


Notícias de IA e infraestrutura
Filtrar por tipo: Todos169
URM combina recorrência e não linearidade no raciocínio
Um post sobre pesquisa em Universal Transformers atribui ganhos de raciocínio ao viés recorrente e à forte não linearidade, e descreve escolhas para mistura local de tokens e treinamento.
AHN propõe memória contínua para LLMs de contexto longo
Em 9 de outubro de 2025, uma publicação da ByteDance apresentou Artificial Hippocampus Networks, arquitetura que comprime continuamente informações que ficam fora da janela de contexto de modelos de linguagem.
Atenção comprimida para reduzir custos em modelos de contexto longo
Publicado em 7 de outubro de 2025, o artigo apresenta uma abordagem que comprime queries, keys e values para executar atenção em um espaço latente menor, com foco em custos de computação e KV-cache.
Atenção e regressão por kernel: uma conexão útil
Um resumo em 10 slides, publicado em 4 de outubro de 2025, examina a relação entre regressão por kernel e atenção e propõe essa perspectiva como apoio à compreensão do mecanismo.
CCA: atenção em espaço latente comprimido
Post de 7 de outubro de 2025 descreve uma arquitetura que calcula atenção em um espaço latente menor e relata reduções de memória, parâmetros e operações em testes com H100.
Circuitos internos ajudam a prever erros de raciocínio
Post de 13 de outubro de 2025 descreve uma técnica que usa grafos de atribuição para identificar raciocínios incorretos em tarefas aritméticas, com melhora nas métricas de detecção.
Como equilibrar adaptação e memória no treinamento de modelos
Estudo publicado em 5 de outubro de 2025 relata que um modelo treinado em 12.000 tarefas pequenas combinou ideias novas e aponta diferenças entre lições estruturadas e mistas.
Como observar o fluxo de informação em LLMs
Publicada em 9 de outubro de 2025, a publicação propõe três etapas para o fluxo de informação em LLMs e relaciona ativações massivas a attention sinks e compression valleys.
Continuous Thought Machines exploram dinâmica entre neurônios
Publicado em 6 de outubro de 2025, o artigo apresenta um modelo que usa processamento e sincronização em nível de neurônio como representações centrais, inspirado na dinâmica neural biológica.
Dicas curtas de raciocínio para avaliar sistemas de IA
Um paper publicado em 5 de outubro de 2025 descreve um gerador de dicas e um solver treinados por reinforcement learning. Em matemática, relata 44% mais acurácia no AIME 2025 do que o RL com cadeias longas.
Dragon Hatchling explora memória local em modelos de linguagem
Publicado em 3 de outubro de 2025, o post descreve uma arquitetura com neurônios simples e conexões que armazenam memória de curto prazo por aprendizado Hebbiano.
Dragon Hatchling propõe arquitetura de LLM interpretável
Publicado em 1º de outubro de 2025, o post descreve uma arquitetura de LLM baseada em partículas neuronais de interação local e afirma que ela rivaliza com o desempenho do GPT-2.
Estudo compara attention em 13 LLMs e encontra melhor resultado com 17%
Publicado em 12 de outubro de 2025, o estudo relata experimentos com 13 LLMs e diferentes proporções de attention convencional e DeltaNet linear attention. A configuração com 17% de attention — duas de 12 camadas — obteve o melhor resultado nos testes.
Gradiente descendente visto como atenção a exemplos
Artigo publicado em 6 de fevereiro de 2023 interpreta camadas lineares treinadas por gradiente como memórias de exemplos e descreve previsões como atenção não normalizada sobre a experiência de treino.
Grokking em adição modular: três etapas até generalizar
Post de 4 de outubro de 2025 descreve um artigo que propõe três etapas para o grokking em adição modular e um limiar de dados próximo a n log n, com weight decay e largura moderada favorecendo o aprendizado de features.
MoE-CL propõe adaptação contínua de LLMs
Publicado em 6 de outubro de 2025, o paper apresenta um método de ajuste contínuo com experts LoRA e relata avaliações nos benchmarks MTL5 e Tencent3, além de um teste A/B.
O que os attention sinks revelam sobre LLMs
Experimentos com modelos de 410 milhões a 120 bilhões de parâmetros relacionam normas extremas de ativação do token inicial a compression valleys e attention sinks.
RLAD explora abstrações de raciocínio com aprendizado por reforço
Publicado em 3 de outubro de 2025, o paper apresenta o RLAD, um framework que usa aprendizado por reforço com dois jogadores para que modelos de linguagem descubram dicas procedurais em linguagem natural.
RLMs: uma abordagem para prompts muito longos
Publicado em 15 de outubro de 2025, o texto descreve modelos de linguagem que interagem recursivamente com prompts longos por meio de um REPL e relata avaliações nos benchmarks OOLONG e BrowseComp-Plus.
SwiReasoning alterna raciocínio para reduzir tokens
Publicação de 12 de outubro de 2025 descreve uma técnica que alterna entre raciocínio latente e explícito e relata ganhos de eficiência de tokens em modelos Qwen3-8B.
Transformers com energia refinam previsões de tokens
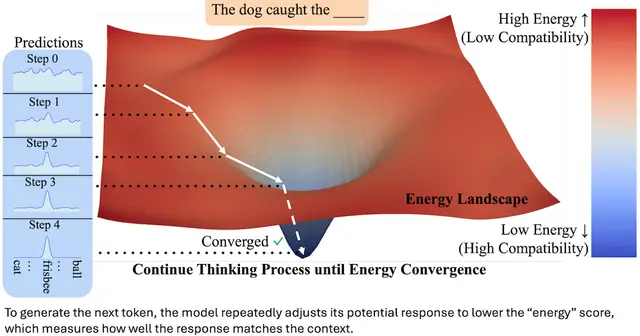
Um paper publicado em 27 de setembro de 2025 relata que Energy-Based Transformers, com 44 milhões de parâmetros, superaram transformers vanilla em três de quatro benchmarks usando RedPajama-Data-v2.
Uma visão unificada de Attention-MoE e FFN-MoE
Artigo publicado em 24 de setembro de 2025 propõe tratar tokens pré-misturados e (V·Wo) como um expert de FFN, unificando abordagens esparsas de attention e FFN.
Agentes otimizam kernels de atenção em GPU
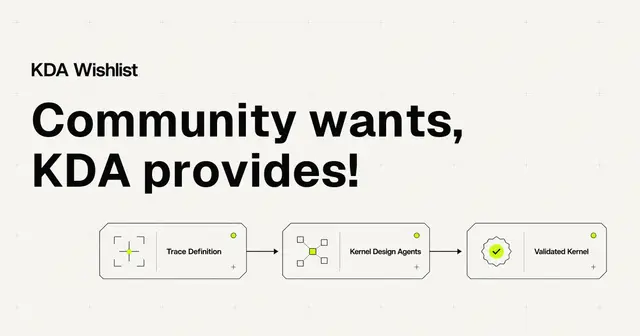
Post da NVIDIA, publicado em 28 de setembro de 2026, relata kernels de atenção com desempenho até 2,96 vezes maior que FlashKDA em B300 e um décimo do erro de estado.
Algoritmos nos pesos de transformers: aplicações práticas
Publicado em 24 de junho de 2026, o artigo sobre The Transformer Cookbook descreve como codificar algoritmos de adição, busca e ramificação nos pesos de transformers, seguindo o trabalho sobre RASP.
Aprendizado contínuo em LLMs com iSDFT
Repositório publicado em 22 de setembro de 2026 apresenta um método de destilação própria para aprendizado contínuo em LLMs, com código de treinamento, checkpoints e avaliações.
Aprendizado contínuo em notebook com 8 GB de VRAM
O repositório mini-AGI descreve um modelo treinado do zero em um notebook com 8 GB de VRAM, usando batch 1, pesos paginados do disco e ajustes na taxa de aprendizado para reduzir o esquecimento.
Arquiteturas híbridas além da atenção padrão
Post publicado em 8 de julho de 2026 compara as arquiteturas do Qwen 3.5 e do Nemotron 3 e aponta a evolução convergente entre atenção linear e modelos de espaço de estados.
Atenção em Transformers de contexto longo
Publicado em 15 de setembro de 2026, o artigo analisa o colapso de posto da atenção à medida que o contexto cresce e estuda o reescalonamento de scores por um fator polilogarítmico.
Atenção esparsa nativamente treinável para contextos longos
Artigo publicado em 26 de setembro de 2026 apresenta a NSA, uma abordagem de atenção esparsa que combina inovações algorítmicas e otimizações de hardware para modelar contextos longos com mais eficiência.
Atenção esparsa pode otimizar a seleção de blocos KV
Publicação da Tencent, datada de 14 de setembro de 2026, descreve um método que usa a perda de modelagem de linguagem para aprender quais blocos KV cada consulta deve acessar.
Atenção linear dinâmica ajusta memória à informação dos tokens
Post de 15 de junho de 2026: a Dynamic Linear Attention adapta os estados de memória à informação dos tokens, mantendo um cache fixo, e relata ganhos em benchmarks, throughput e memória.
Atenção linear e esparsa: o que avaliar em modelos de contexto longo
Um post de 26 de agosto de 2026 afirma que o GLM-5.3 intercala três camadas de atenção linear para cada camada de atenção esparsa, destacando trade-offs de eficiência computacional em contextos longos.
Atenção sob demanda pode equilibrar contexto longo e velocidade
Em publicação datada de 20 de setembro de 2026, a abordagem On-Demand Attention usa uma head leve para acionar o contexto completo quando necessário, buscando acelerar a decodificação sem perder tanto desempenho quanto a atenção local.
Attention sinks e reescala em transformers
Artigo publicado em 5 de outubro de 2026 analisa attention sinks e residual sinks em grandes modelos de linguagem e propõe como esses outliers, a atenção softmax e RMSNorm reescalam outros componentes.
BF16 no FlashAttention: monitore a estabilidade dos gradientes
Em 29 de setembro de 2026, um trabalho técnico relatou que o arredondamento BF16 no FlashAttention pode quebrar uma simetria do gradiente do softmax e causar explosões no fim do treinamento. Os autores propõem o GProj como correção.
Cache de 64 tokens para atenção linear: o que avaliar
Uma postagem sobre HOLA, publicada em 5 de julho de 2026, descreve uma métrica de surpresa sem parâmetros e um cache de 64 tokens para reduzir o esquecimento catastrófico em modelos com atenção linear.
Camadas esparsas e looping na escala de modelos de linguagem
Artigo publicado em 26 de setembro de 2026 compara Transformers padrão e Mixture-of-Experts, com e sem looping, e aponta vantagem de escala para modelos Looped-MoE.
Como avaliar atenção eficiente em modelos híbridos
Publicado em 16 de junho de 2026, o artigo analisa atenção de janela deslizante e mixers recorrentes em modelos de linguagem híbridos, com foco em escalabilidade, mecanismos e decisões de arquitetura.
Como avaliar gargalos na inferência autorregressiva
Um paper da ICLR 2026 aborda um gargalo na decodificação de modelos probabilísticos Transformer. Empresas podem medir o desempenho da inferência e identificar oportunidades de otimização.
Como avaliar o acesso de LLMs ao conhecimento em seus parâmetros
Em publicação de 28 de junho de 2026, o blog do Google Research examina como o raciocínio pode ajudar modelos de linguagem a acessar conhecimento armazenado em seus parâmetros. A questão pode orientar testes internos de modelos e prompts.
 arxiv.org
Vamos avaliar seu projeto

Respondo com escopo e proposta.