


Notícias de IA e infraestrutura
- Agentes de IAProjeto
Repositório de automação furtiva de navegador via MCP: o que muda para a detecção de bots
Repositório open source expõe como agentes de IA controlam sessões reais do Chrome via MCP e Chrome DevTools Protocol, com navegação, network hooks e extração de DOM. O autor afirma contornar desafios do Cloudflare.
nginx com --with-libatomic no ARM perde atualizações e passa a recusar visitantes
Em 14 de outubro de 2026, um nginx de produção num servidor ARM passou a recusar todo visitante novo com o erro 429. A causa é a opção de compilação --with-libatomic. O teste, o patch e a correção estão no GitHub.
Granite Switch 4.1: conversa, decisões e transcrição num só endpoint
A IBM publicou em 15 de outubro de 2026 o Granite Switch 4.1, em versões de 8B e 30B, que junta conversa, adaptadores de decisão e segurança e um modelo de transcrição de fala usando quase a mesma memória de GPU do modelo base.
Intel LLM-Scaler-vLLM 1.5: inferência em GPUs Intel Arc mais atualizada
A Intel lançou em 16 de outubro de 2026 a versão 1.5 do LLM-Scaler-vLLM, um ambiente Docker com vLLM para GPUs Intel Arc, que pulou do vLLM 0.14 para o 0.26 e passou a suportar mais modelos e quantização FP8.
Nemotron 3.5 Super VL: modelo aberto que lê documentos, imagem e vídeo
A NVIDIA lançou em 15 de outubro de 2026 o Nemotron 3.5 Super VL, com 120B parâmetros e 12B ativos, pesos, dados e receitas abertos, entrada de texto, imagem e vídeo e contexto de até 1 milhão de tokens.
TranscribePsy: transcrição de fala no próprio aparelho, inclusive em português
A Tether AI Research lançou em 14 de outubro de 2026 o TranscribePsy, um modelo de transcrição de 254M parâmetros que roda no celular ou no notebook, sem o áudio sair do aparelho.
- Agentes de IAPesquisa
Ciência autônoma limitada pela validação física: alocação de agentes e gargalos de validação
Um artigo no arXiv sustenta que a ciência autônoma é limitada pela capacidade de validação física e propõe mercados e instituições para alocar esse trabalho escasso.
- Aprendizado por reforçoPesquisa
QwenGyre: RL elástico para treinar agentes de horizonte longo
A Alibaba Qwen apresentou o QwenGyre, um framework de RL elástico que realoca GPUs entre rollout e treinamento e agrupa execuções ramificadas de agentes em árvores de trajetórias com prefixos compartilhados, com speedup relatado de até 1,85× sobre Colocate.
- Inferência de LLMsArtigo
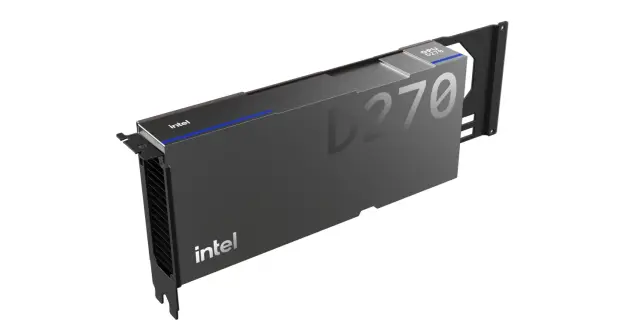
Intel GPU D-Series: placa de inferência com até 480GB LPDDR5X em amostragem
A Intel apresentou a GPU D-Series, com até 480GB de LPDDR5X, 1,5TB/s e 1,3 PFLOPS em FP8 numa placa PCIe de 350W já em amostragem. Veja o que isso muda para inferência privada e custo por token.
- Atenção e arquitetura de modelosProjeto
μLattice: alternativa de escalonamento de memória à atenção, segundo o autor
Projeto de código aberto e artigo descrevem o μLattice, um design de memória que cresce com a entrada sem custo quadrático. O desempenho é alegado pelo autor e ainda não foi verificado de forma independente.
- Voz: TTS e ASRPublicação
Artificial Analysis: HeyGen Voice lidera ranking de síntese de voz controlada
A Artificial Analysis classificou o HeyGen Voice em 1º lugar no Controlled Voice TTS Arena, com Elo de 1.201 em 8 vozes clonadas em inglês dos EUA e do Reino Unido, à frente de modelos comerciais concorrentes de voz.
- Agentes de IAPesquisa
HERMES: harness em nível de componente com um LLM residente por módulo de código
Artigo no arXiv propõe o HERMES, em que cada componente do repositório tem um LLM residente que conhece seu código, com ganhos relatados em migração e em quatro benchmarks de engenharia de software.
- Treino e fine-tuningPublicação
Post sobre RoboJEPA: escala previsível em modelos de mundo robóticos
Post de rede social descreve o RoboJEPA, modelo de mundo JEPA de 8B parâmetros treinado com 15.022 horas de vídeo robótico, e ajustes de leis de escala que antecipam resultados de 4B e 8B.
- Voz: TTS e ASRModelo
Qwen3-TTS 1.7B: clonagem de voz open-source com controles de emoção e sotaque
O post apresenta um modelo open-source de text-to-speech de 1,7B para clonagem de voz, com controles de emoção, idade, tom e sotaque e suporte multilíngue. Para empresas, a avaliação self-hosted exige checar licença, idiomas e controles antes de qualquer uso.
- Voz: TTS e ASRModelo
Whistle: modelo de speech-to-text de 16,9 MB para rodar no dispositivo
A Cactus-Compute publicou o Whistle, um modelo de speech-to-text de 16,9 MB para uso on-device. O autor afirma que ele rivaliza com o Whisper base. Para empresas com áudios sensíveis, o anúncio abre a avaliação de transcrição local.
- Voz: TTS e ASRPublicação
Clones de voz de falantes não nativos avaliados como mais humanos: o que muda para empresas
Um artigo do NeurIPS 2026 clonou vozes de 86 falantes não nativos de inglês com três sistemas de síntese de voz. Em 4.000 avaliações humanas, os clones foram considerados mais calorosos, autoritativos e humanos, o que reforça riscos para a confiança em canais de voz.
- Agentes de IAPublicação
DeLM: agentes de código descentralizados com contexto compartilhado, sem coordenador central
Artigo de Stanford apresenta o DeLM, que troca o coordenador central por contexto compartilhado e fila de tarefas. Segundo o autor, é até 2,49× mais rápido e mais preciso que as linhas de base Claude Code e Codex.
- Treino e fine-tuningArtigo
LayerRoPE: codificar a profundidade nos pesos de normalização para Transformers muito profundos
O artigo propõe o LayerRoPE, que codifica a profundidade nos pesos de normalização para conter o crescimento da norma dos estados ocultos entre camadas, relatando loss de um modelo Pre-Norm de 1,3B com 3,4x menos compute e escala estável até 512 camadas.
- Treino e fine-tuningPesquisa
RoboJEPA: como a escala de modelos de mundo JEPA afeta o planejamento robótico
A Meta apresentou o RoboJEPA, um modelo de mundo latente baseado em JEPA, escalado de 22M para 8B de parâmetros e treinado com dados de 12 embodiments robóticos. O artigo testa se o erro de predição latente prevê o desempenho de planejamento posterior.
- Inferência de LLMsPublicação
Samsung abre código do LittleBit, método que comprime LLMs de 13B para menos de 1 GB
Segundo o post, o LittleBit da Samsung usa fatoração latente e níveis abaixo de 1 bit para reduzir pesos de LLMs de 13B a menos de 1 GB. Vale avaliar para deploy local.
- Voz: TTS e ASRArtigo
Benchmark multilíngue de speech-to-text para modelos locais no transcribe.cpp em notebook
Site que compara precisão e velocidade de modelos de speech-to-text suportados pelo transcribe.cpp, medidos por idioma no conjunto FLEURS, com dados de um notebook com CPU/GPU 4750U.
- Treino e fine-tuningArtigo
H-JEPA: modelos de mundo hierárquicos para planejamento visual de longo prazo
O artigo, orientado por Yann LeCun, propõe o H-JEPA, com modelos de mundo JEPA empilhados em múltiplas escalas de tempo. O autor relata subida de 18% para 73% no Visual AntMaze com essa abordagem hierárquica.
- Atenção e arquitetura de modelosArtigo
LiFT: transformers em loop para gerar imagens com flow matching e custo ajustável na inferência
Artigo apresenta o LiFT, um gerador de imagens com flow matching que reutiliza um núcleo transformer compartilhado em loops. Segundo o autor, um modelo treinado com 2 loops melhora com até 16 loops na inferência, sem retreinar.
- RAG e recuperação de contextoPublicação
Quantização de 10M de vetores EmbeddingGemma para 1 bit com MRL reduz RAM de 30GB para 0,4GB
Post do autor que relata a compressão de 10 milhões de embeddings EmbeddingGemma para 1 bit, com redução MRL para 256 dimensões, caindo a RAM de cerca de 30GB para 0,4GB ao custo de cerca de 5% de qualidade.
- Treino e fine-tuningPesquisa
Roteamento de experts com eficiência de memória para treinamento distribuído de MoE
O artigo no arXiv propõe métodos para reduzir o pico de memória no treinamento distribuído de Mixture-of-Experts, em que o dispatch de experts domina o uso de memória.
- Voz: TTS e ASRPublicação
TTS de voz única com 9MB destilado do Kokoro-82M para saída de voz local
Um post descreve um modelo de text-to-speech de voz e idioma únicos, com cerca de 9MB de pesos, destilado do Kokoro-82M e pensado para saída de voz local em dispositivos com recursos limitados.
- SegurançaProjeto
Coleção sobre segurança e exploração do kernel Linux recebe atualizações de janeiro e fevereiro
A coleção sobre exploração do kernel Linux foi atualizada com links de janeiro e fevereiro sobre segurança do kernel. Para equipes de infraestrutura, o material aponta a necessidade de acompanhar esse tema de forma sistemática.
- OCR e IA para documentosArtigo
Escolher e implantar modelos open de OCR em pipelines próprios
O post do blog de uma plataforma de modelos open aborda como escolher um modelo de OCR, comparar modelos de ponta, implantar localmente ou remotamente e ir além do OCR.
- Treino e fine-tuningProjeto
Notebooks da Unsloth para fine-tuning e RL em diversos tipos de modelo
O repositório da Unsloth reúne mais de 250 notebooks para fine-tuning e RL em modelos de texto, visão, áudio, embeddings e TTS, que servem como exemplos de fluxos de treinamento.
- C e C++Artigo
Referência do Wikibooks reúne mais de 80 padrões de design em C++
O Wikibooks publica uma referência mantida pela comunidade com mais de 80 padrões de design em C++, para engenheiros explorarem e compararem soluções recorrentes. Empresas podem usá-la como base para padrões internos de código.
- SegurançaPublicação
Vetores de prompt injection: como testar e reforçar sistemas de IA
O post reúne vetores e estratégias de prompt injection com exemplos, úteis para avaliar e reforçar a segurança de aplicações com modelos de linguagem.
- C e C++Projeto
WinDbg MCP expõe funções do debugger do Windows como ferramentas MCP
O post descreve o WinDbg MCP, um servidor MCP que disponibiliza funções do debugger Windows, via pybag, a clientes compatíveis para inspecionar processos e crash dumps, definir breakpoints, ler memória e percorrer a stack.
- HardwareArtigo
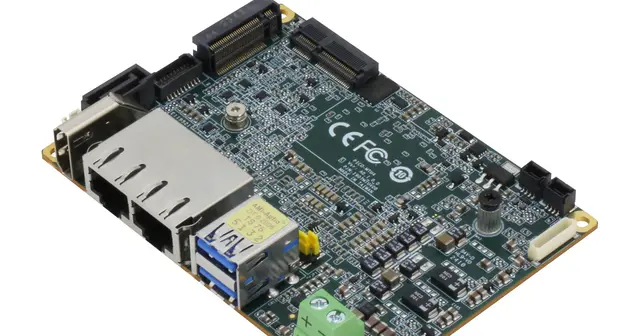
AAEON apresenta SBC Pico-ITX com Core Ultra e até 32 GB
Em 7 de novembro de 2025, a AAEON apresentou a PICO-ARU4, uma placa compacta com processadores Core Ultra, memória LPDDR5 soldada e conexões para sistemas embarcados.
- Aprendizado por reforçoPesquisa
Adaptação de modelos à linguagem Q, usada em finanças
Relatório técnico de 9 de janeiro de 2026 apresenta uma abordagem open source para adaptar modelos de linguagem à Q, uma linguagem de programação especializada em finanças quantitativas.
- C e C++Pesquisa
ADRS explora pesquisa automatizada de desempenho em sistemas
Publicado em 24 de dezembro de 2025, o artigo apresenta um framework que usa modelos de linguagem para gerar, avaliar e refinar algoritmos, testado em dez tarefas de redes, bancos de dados e sistemas distribuídos.
- Agentes de IAPesquisa
Agent-R1: treinamento modular de agentes LLM em várias rodadas
O artigo apresenta um framework de aprendizado por reforço para treinar agentes LLM em interações multi-turn com ferramentas e ambientes sequenciais.
- Agentes de IAPublicação
Agentes com autoaperfeiçoamento auditável
Artigo de 19 de abril de 2026 propõe um protocolo para agentes sugerirem, avaliarem e implementarem melhorias com rastreabilidade auditável e reversão.
- Aprendizado por reforçoPesquisa
Agentes de busca podem verificar evidências contra ruído
Publicado em 28 de outubro de 2025, o paper descreve um agente que define objetivos de busca e verifica se as evidências encontradas os atendem, buscando resistir a pistas enganosas.
- Agentes de IAPublicação
Agentes de código: como avaliar segurança e desempenho
A Microsoft relata um agente de código de 14 bilhões de parâmetros, com 45,3% no SWE-Bench Verified, e um método de treinamento que considera testes quebrados acidentalmente ao adicionar recursos.
- Agentes de IAPublicação
Agentes recursivos trocam estados latentes para colaborar
Uma publicação de 1º de maio de 2026 descreve um paper sobre agentes que refinam estados latentes compartilhados e relata colaboração mais precisa, execução mais rápida e menor uso de tokens nos experimentos.
 arxiv.org
Vamos avaliar seu projeto

Respondo com escopo e proposta.