


Notícias de IA e infraestrutura
Filtrar por tipo: Todos85
- há 5 dias x.com
Modelos de texto por difusão geram a saída inteira de uma vez: o que muda para a inferência
Post descreve modelos de texto por difusão que produzem a resposta inteira simultaneamente, em vez de token a token como os LLMs autorregressivos. Segundo o autor, a geração é rápida, com perfil de latência e custo distinto da inferência padrão.
- há 5 dias x.com
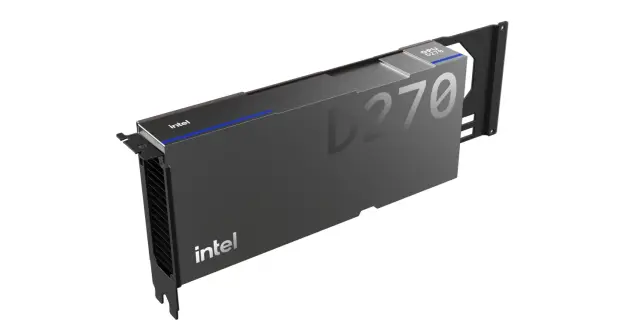
Intel GPU D270 (Crescent Island): acelerador de inferência com memória LPDDR5X de grande capacidade
Um post descreve a GPU D270 da Intel, placa PCIe 5.0 voltada para inferência, com 32 Xe cores, motores de matriz XMX e cerca de 160 GB de LPDDR5X, expansível até 480 GB.
- há 6 dias x.com
Poda de 6 camadas do Qwen3-8B-Base com LaCo reduz o modelo em 16,7%
Post relata a remoção de até 10 camadas do Qwen3-8B-Base com LaCo. Com 6 camadas removidas, o modelo fica 16,7% menor e, segundo o autor, mantém 78-94% das pontuações de raciocínio, com razão de perplexidade de 1,68x.
- há 12 dias storagereview.com
Intel GPU D-Series: placa de inferência com até 480GB LPDDR5X em amostragem
A Intel apresentou a GPU D-Series, com até 480GB de LPDDR5X, 1,5TB/s e 1,3 PFLOPS em FP8 numa placa PCIe de 350W já em amostragem. Veja o que isso muda para inferência privada e custo por token.
- há 16 dias x.com
Samsung abre código do LittleBit, método que comprime LLMs de 13B para menos de 1 GB
Segundo o post, o LittleBit da Samsung usa fatoração latente e níveis abaixo de 1 bit para reduzir pesos de LLMs de 13B a menos de 1 GB. Vale avaliar para deploy local.
- há 17 dias x.com
Benchmark relata TTFT 2,89× mais rápido em contexto de 64K
Publicado em 9 de maio de 2026, o benchmark relata que Luce PFlash teve time to first token 2,89× mais rápido que Ollama com contexto de 64K.
- há 17 dias x.com
CLI estima VRAM antes de carregar modelos
A ferramenta do-i-have-the-vram estima a memória de GPU necessária para carregar um modelo sem carregá-lo, ajudando a avaliar se ele cabe na VRAM disponível.
- há 17 dias andrewkchan.dev
Como avaliar e otimizar inferência de LLM na empresa
Artigo de Andrew Chan, publicado em 1º de março de 2026, aborda inferência rápida de LLM do zero como ponto de partida prático para engenheiros.
- há 17 dias turingpost.com
Como comparar ferramentas para executar modelos fundacionais
Artigo da Turing Post, publicado em 17 de maio de 2026, apresenta 13 ferramentas open source para deployment, serving e execução de modelos, de uso local à inferência de produção.
- há 17 dias x.com
Como comparar inferência MTP em GPUs mais antigas
Uma publicação de 16 de maio de 2026 relata benchmarks do llama.cpp com MTP para modelos Qwen 3.6 em três GPUs GTX 1080 Ti e descreve uma configuração que pode orientar testes internos.
- há 17 dias lmsys.org
Como otimizar a latência do Qwen3 em GPUs AMD
Artigo do blog da LMSYS, publicado em 13 de fevereiro de 2026, aborda a otimização da latência do Qwen3 e do Qwen3-VL em GPUs AMD MI300X.
- há 17 dias x.com
DEER propõe rascunhos de diffusion para acelerar inferência de LLMs
Publicação de 18 de dezembro de 2025 descreve o DEER, que gera rascunhos de tokens com modelos de diffusion e os verifica com modelos autoregressivos. O texto afirma aceleração de até 5,54× sem perda de qualidade.
- há 17 dias x.com
DFlash e DDTree rodam Qwen3.6-27B em uma RTX 3090
Post de 23 de abril de 2026 relata 73 tokens por segundo com speculative decoding em uma única RTX 3090 e aponta compatibilidade de arquitetura como fator para executar o modelo.
- há 17 dias github.com
dflash-mlx v0.1.5 amplia recursos de runtime e serving
Em 3 de maio de 2026, a versão 0.1.5 adicionou uma CLI unificada, cache em RAM e SSD, correspondência de prefixos e suporte experimental a contextos longos.
- há 17 dias arxiv.org
Fluxion propõe atenção esparsa híbrida para contexto longo
Publicado em 11 de maio de 2026, o artigo apresenta um sistema de atenção esparsa híbrida para inferência com contexto longo, usando paralelismo entre CPU e GPU.
- há 17 dias x.com
Fork do DS4 habilita inferência tensor-parallel em várias máquinas
Publicado em 9 de junho de 2026, o fork do repositório antirez/ds4 adiciona suporte à combinação de tensor parallelism e funções de nó para inferência distribuída em várias máquinas e GPUs.
- há 17 dias x.com
hf-mem estima memória para novos modelos
Publicação de 17 de fevereiro de 2026 apresenta uma ferramenta de linha de comando para estimar requisitos de memória conforme as arquiteturas dos modelos mudam.
- há 17 dias openanonymity.ai
Inference não vinculável para proteger a identidade de usuários
Em post publicado em 26 de fevereiro de 2026, a OpenAnonymity descreve uma camada para impedir que provedores de IA associem chamadas de inference a usuários individuais.
- há 17 dias baseten.co
Inferência de IA em produção exige engenharia de ponta a ponta
Publicado em 3 de março de 2026, o livro de Philip Kiely aborda hardware, software, técnicas e infraestrutura para sistemas de inferência em produção, com foco principal em modelos de linguagem e algum conteúdo sobre diffusion.
- há 17 dias github.com
Inferência de Llama 70B em uma RTX 3090 com ntransformer
Em 22 de fevereiro de 2026, a página do repositório ntransformer afirma que o engine de inferência em C++/CUDA executa Llama 70B em uma RTX 3090, com transferência de NVMe para GPU sem passar pela CPU.
- há 17 dias x.com
Inferência local: desempenho e consumo na RTX 3090
Testes de oito LLMs locais em uma RTX 3090 compararam throughput e eficiência energética com limites de potência entre 100 W e 450 W.
- há 17 dias outcomeschool.com
KV cache: menos recálculo na inferência de LLMs
Publicado em 9 de maio de 2026, o artigo explica como o KV cache reutiliza valores já calculados e por que isso importa para memória e computação na inferência.
- há 17 dias github.com
llama.cpp adiciona suporte a Multi-Token Prediction
Em 17 de maio de 2026, um pull request do llama.cpp adicionou suporte a heads de MTP. O relato cita 65 tokens por segundo para o Qwen3.6-27B em uma RTX 3090, contra 38 sem MTP.
- há 17 dias github.com
llmfit ajuda a avaliar modelos para hardware local
O repositório llmfit, publicado no GitHub em 21 de fevereiro de 2026, analisa hardware local para identificar modelos compatíveis e estimar a velocidade de inferência.
- há 17 dias x.com
LMCache reutiliza cache KV entre GPU, CPU e disco
Em 30 de janeiro de 2026, a descrição do projeto open source LMCache apresentou uma extensão para serving de LLMs que reaproveita estados KV entre GPUs, CPUs e discos locais, inclusive para fragmentos de texto repetidos que não sejam apenas prefixos.
- há 17 dias
 arxiv.org
LoPA explora lookahead para acelerar inferência de modelos de difusão
Publicado em 11 de janeiro de 2026, o texto apresenta o LoPA, um algoritmo sem treinamento adicional que usa lookahead para escolher a ordem de preenchimento de tokens em modelos de linguagem de difusão.
- há 17 dias github.com
Lucebox explora speculative inference em GPUs de consumo
Publicada em 9 de maio de 2026, a postagem apresenta o Lucebox, servidor de speculative inference para hardware heterogêneo, e afirma que o Qwen3.6-27B alcança 120–200 tokens por segundo em uma RTX 3090.
- há 17 dias huggingface.co
Pesos quantizados abrem caminho para avaliar inferência local
Um repositório publicado em 3 de janeiro de 2026 disponibiliza pesos W4A16 de um modelo de 185 bilhões de parâmetros, com 92 GB. O autor afirma ter executado localmente 100 milhões de tokens.
- há 17 dias x.com
Post avalia inferência com duas RTX Pro 6000
Publicado em 29 de abril de 2026, o post afirma que os experts de um modelo de linguagem já usam quantização de 4 bits e poderiam caber em duas RTX Pro 6000; aponta uma lacuna de suporte a SM120 em duas opções de serving.
- há 17 dias github.com
Receitas comunitárias para servir LLMs em GPUs RTX
Publicado em 24 de maio de 2026, o repositório reúne configurações independentes de modelo para servir LLMs em GPUs RTX 3090, 4090 e 5090, com vLLM, llama.cpp e ik_llama.
- há 17 dias x.com
RTX 3090: eficiência e throughput em inferência local
Testes relatados em 9 de maio de 2026 compararam um modelo de 27 bilhões de parâmetros na RTX 3090, variando concorrência e limite de potência.
- há 17 dias x.com
Serving de modelos MoE com AWS EFA
Em 6 de novembro de 2025, um artigo da Perplexity descreveu kernels para servir modelos MoE em várias GPUs da AWS usando EFA, sem GPUDirect Async.
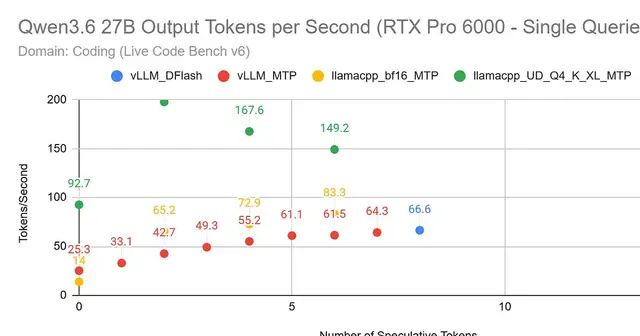
Speculative decoding: desempenho varia por modelo
Artigo publicado em 3 de junho de 2026 compara DFlash e MTP com vLLM e llama.cpp em matemática, programação e chat. Os resultados variam conforme o modelo e a carga de trabalho.
- há 17 dias x.com
SWAA propõe inferência mais eficiente com contexto longo
Post de 15 de dezembro de 2025 descreve receitas sem treinamento para adaptar modelos de linguagem com atenção completa a uma escala linear e recuperar desempenho.
- há 17 dias huggingface.co
Técnicas para otimizar inferência de Transformers
Um post publicado em 24 de dezembro de 2025 descreve técnicas de inferência de Transformers: quantização MXFP4, paralelismo de tensores e especialistas e janelas deslizantes dinâmicas.
- há 17 dias github.com
Tencent apresenta operadores HPC-Ops para inferência de LLMs
Em 27 de janeiro de 2026, a Tencent apresentou a biblioteca open source HPC-Ops, com operadores para inferência de LLMs e suporte a operações em GPUs e comunicação multinó.
- há 17 dias lightseek.org
TokenSpeed destaca otimizações de inferência para agentes
Publicado em 24 de maio de 2026, o texto descreve um engine de inferência para workloads agentic, com paralelismo apoiado por compiler, scheduler de alto desempenho, reutilização restrita de recursos KV e kernels plugáveis para aceleradores heterogêneos.
- há 17 dias
 unsloth.ai
Tool calling com modelos locais: do guia à aplicação
Publicado em 5 de fevereiro de 2026, o guia da Unsloth apresenta exemplos de chamadas a ferramentas com modelos abertos locais, incluindo Python, terminal e matemática.
- há 17 dias github.com
Treinar redes neurais no Neural Engine: como avaliar o repositório ANE
Publicado em 2 de março de 2026, o repositório ANE descreve treinamento de redes neurais com APIs privadas obtidas por engenharia reversa do Neural Engine da Apple. Veja como avaliar essa abordagem antes de adotá-la.
- há 17 dias github.com
Voice agents: modelos em paralelo podem reduzir o silêncio
Uma contribuição ao Gradbot, publicada em 5 de junho de 2026, descreve o envio de uma resposta breve ao TTS enquanto outro modelo raciocina e aciona ferramentas em segundo plano.
Vamos avaliar seu projeto

Respondo com escopo e proposta.