


Notícias de IA e infraestrutura
Filtrar por tipo: Todos66
Desbloqueio da taxa de issue FP/BF16 em RTX 3090 via gpu-unlock: o que medir antes de decidir
Segundo o post, o projeto gpu-unlock elevou o throughput medido no PyTorch em uma RTX 3090 de 75T para 135T, com limite de 360 W. O repositório descreve o desbloqueio da taxa de issue de FP/BF16 até o nível das placas profissionais.
- há 17 dias github.com
Booth: compiler para várias arquiteturas
O Booth é um compiler open source para CUDA, Triton e HIP, com suporte a diferentes arquiteturas de GPU e CPU. Veja como uma empresa pode avaliar essa compatibilidade em seus ambientes de computação.
- há 17 dias amazon.com
Como estruturar uma trilha de programação CUDA
Em publicação de 9 de novembro de 2025, um autor recomenda estudar C/C++ e álgebra linear antes de CUDA e indica livros e um curso para iniciar em programação de GPU.
Como sobrepor transferências e computação em CUDA
Post do NVIDIA Technical Blog, publicado em 27 de março de 2026, explica a sobreposição de transferências de dados e computação em CUDA C/C++ para aproveitar melhor o tempo da CPU e da GPU.
Computação em GPU: da arquitetura à otimização
Artigo introdutório publicado em 28 de março de 2026 apresenta arquitetura e computação em GPU como contexto para engenheiros que desenvolvem ou otimizam software para esse hardware.
- há 17 dias
 hgpu.org
CuBridge explora LLMs para reconstruir kernels CUDA de attention
Publicado em 10 de maio de 2026, o texto apresenta o CuBridge, framework que usa LLMs para entender e reconstruir kernels de attention eficientes em CUDA.
CUDA C++: do exemplo paralelo ao teste de GPU
Em post publicado em 28 de fevereiro de 2026, a NVIDIA apresenta uma introdução passo a passo à programação CUDA C++ por meio de um exemplo simples de programação paralela.
CUDA C++: primeiros passos na programação paralela
Em post publicado em 3 de novembro de 2025, a NVIDIA apresenta uma introdução passo a passo a CUDA C++ por meio de um exemplo simples de programação paralela.
- há 17 dias
 arxiv.org
CUDA-L2 automatiza o ajuste de kernels HGEMM
Artigo publicado em 15 de dezembro de 2025 apresenta uma abordagem que combina modelos de linguagem e aprendizado por reforço para otimizar kernels CUDA de multiplicação de matrizes em meia precisão.
- há 17 dias manning.com
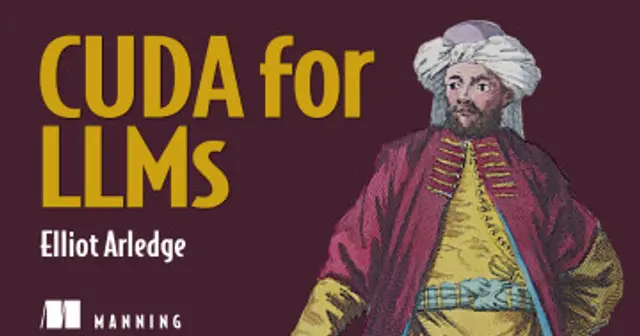
CUDA para LLMs: kernels, atenção e profiling
Publicado em 3 de fevereiro de 2026, o livro da Manning apresenta programação CUDA para GPUs NVIDIA, de kernels básicos a Flash Attention, e aborda profiling com Nsight Compute.
- há 17 dias x.com
De Numba a Triton: um percurso prático para programar GPUs
Publicada em 12 de dezembro de 2025, a publicação apresenta um notebook Jupyter que ensina programação de GPU com Numba e avança para a escrita de kernels com Triton.
De SIMD a SIMT: o que a evolução das GPUs muda na prática
Em artigo publicado em 5 de fevereiro de 2026, o ACM SIGGRAPH Blog explica como GPUs combinaram abstrações de threads com hardware SIMD, tornando-se processadores flexíveis para gráficos, IA e computação científica.
Escalonamento de tiles no CuTeDSL e kernels persistentes
Post publicado em 15 de maio de 2026 apresenta o StaticPersistentTileScheduler no CuTeDSL e sua utilidade para organizar kernels persistentes.
Falhas em módulos Linux de GPU ampliam risco local
Em 8 de novembro de 2025, a Quarkslab descreveu dois bugs em módulos de kernel Linux para GPUs, exploráveis por um processo local sem privilégios.
- há 17 dias x.com
FlashAttention em CuPy/CUDA: implementação e desempenho
Projeto publicado em 1º de março de 2026 implementa FlashAttention com tiling e online softmax, sem materializar a matriz de scores NxN; relata verificação matemática, mas nenhum speedup sobre cuBLAS.
GPU Blackwell: o que a arquitetura significa para suas cargas de trabalho
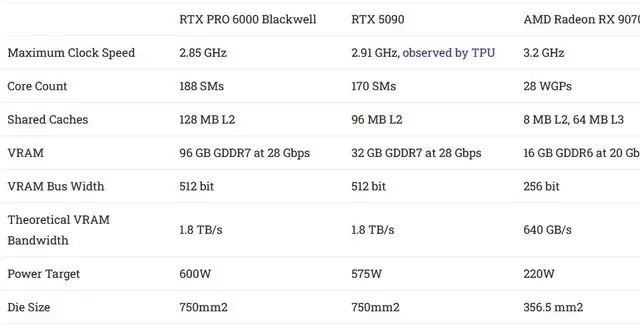
Artigo publicado em 3 de março de 2026 examina a GPU Blackwell e a relaciona à tradição da NVIDIA de construir GPUs grandes. O tema ajuda equipes a avaliar requisitos de hardware para suas cargas de trabalho.
Hardware de inferência em 2026: custo por token e trade-offs
Em artigo publicado em 28 de fevereiro de 2026, a Turing Post compara chips de inferência, incluindo GPUs, um acelerador programável para LLMs e uma abordagem que transforma modelos em hardware, com foco no custo por token.
- há 17 dias hgpu.org
HPC++ automatiza paralelização de C++ para CPUs e GPUs
Publicado em 22 de fevereiro de 2026, o texto apresenta um framework baseado em LLVM que converte programas sequenciais em C++ em implementações paralelas para CPUs multicore e GPUs compatíveis com OpenCL.
- há 17 dias tunbury.org
Inferência ONNX: CPU e GPU em comparação
Publicado em 11 de março de 2026, o artigo compara inferência com ONNX Runtime em uma GPU NVIDIA L4 e uma CPU AMD EPYC 9965. O autor relata que OCaml e o posicionamento de memória com libnuma aceleraram a inferência em CPU frente ao uso de GPUs escassas no TESSERA.
- há 17 dias tensara.org
Kernel CUDA para soma de arrays: do exemplo à prática
Publicado em 16 de novembro de 2025, o artigo da Tensara apresenta a iniciantes a escrita de um kernel CUDA simples para somar arrays. O exemplo pode servir de base para avaliar cargas de trabalho em GPU.
Kernel de matmul em CUDA/PTX relata ganho de 6% no B200
Post publicado em 27 de abril de 2026 descreve um kernel de multiplicação de matrizes em CUDA/PTX puro que, no B200 e com M=N=K=8192, teria superado o desempenho do cuBLAS em 6%.
Layouts CuTe ajudam a entender shapes e strides
Post da NVIDIA, publicado em 3 de fevereiro de 2026, recomenda tutoriais de álgebra de layouts para compreender como o CuTe representa tensores.
Otimização de kernels GPU além das tabelas de latência SASS
Post de 25 de novembro de 2025 questiona a utilidade de tabelas de latência SASS extraídas pelo nvdisasm e aponta ganhos de 3–4% com reordenação de instruções, diante de um limite teórico de 10%.
- há 17 dias siboehm.com
Otimização iterativa de multiplicação de matrizes em CUDA
Em artigo publicado em 26 de fevereiro de 2026, Simon Boehm descreve a otimização de um kernel CUDA para se aproximar do desempenho do cuBLAS, sem pretender substituí-lo.
- há 17 dias x.com
Padding de inputs para reutilizar CUDA graphs variáveis
Em post publicado em 26 de fevereiro de 2026, o autor recomenda preencher inputs até tamanhos de referência e criar uma família de CUDA graphs para reduzir recompilações em workloads de inferência com sequências de comprimentos variados.
- há 17 dias x.com
Padrões de kernels CUDA e otimização de cargas de trabalho
Post de 25 de fevereiro de 2026 reúne reduction, convolução 1D, histogramas e softmax estável como padrões centrais de kernels CUDA.
- há 17 dias github.com
Penny: comunicação entre GPUs em uma biblioteca open source
O repositório da Penny, publicado em 26 de outubro de 2025, apresenta uma biblioteca de comunicação GPU feita à mão e aberta à comunidade. Empresas podem avaliar sua adequação por meio de testes controlados.
- há 17 dias x.com
Ponteiros de 64 bits e acesso bindless em GPUs
Post publicado em 6 de abril de 2026 compara formas de acessar buffers em APIs de GPU e aponta diferenças de suporte entre elas.
Primitivas de warp no CUDA: oportunidades para otimizar GPUs
Em artigo publicado em 4 de março de 2026, o NVIDIA Technical Blog explica como grupos de threads chamados warps executam no modelo SIMT e como programas CUDA podem aproveitar esse comportamento.
- há 17 dias github.com
pyptx leva kernels PTX para fluxos Python com JAX e PyTorch
Publicado em 25 de abril de 2026, o repositório pyptx apresenta uma DSL em Python para kernels NVIDIA PTX, com suporte a Hopper e Blackwell e exemplos de operações usadas em computação acelerada.
Red Hat apresenta os fundamentos da programação de GPU
Publicado em 26 de novembro de 2025, o primeiro post de uma série de quatro partes oferece uma visão geral do modelo de programação de GPU e aponta um roteiro de arquitetura da Universidade Cornell.
- há 17 dias hgpu.org
RL agentic para gerar kernels CUDA de alto desempenho
Post de 4 de março de 2026 apresenta o CUDA Agent, sistema de reinforcement learning agentic em larga escala para gerar kernels CUDA, uma tarefa que exige conhecimento especializado de hardware.
- há 17 dias khronos.org
Subgroups no Vulkan 1.1: paralelismo na GPU
Em tutorial publicado em 4 de março de 2026, a Khronos explica como subgroups no Vulkan 1.1 permitem compartilhar e manipular dados entre tarefas paralelas na GPU.
Transposição de matrizes em CUDA com memória compartilhada
Em post publicado em 26 de fevereiro de 2026, Mark Harris, no blog da NVIDIA, explica como a memória compartilhada pode melhorar o desempenho da transposição de matrizes em CUDA C/C++.
- há 17 dias x.com
Treinamento de LLMs em escala: escolhas de paralelismo
Playbook publicado em 6 de abril de 2026 descreve estratégias de paralelismo para treinar LLMs em clusters de GPUs, com dados de 4.000 experimentos em até 512 GPUs.
- há 17 dias hgpu.org
Treinamento FP4 de modelos MoE em GPUs Hopper
A página, publicada em 8 de março de 2026, aborda treinamento FP4 de modelos MoE de grande escala em GPUs Hopper e aponta memória de ativações e comunicação entre especialistas como gargalos.
- há 17 dias hgpu.org
VOLT: como projetar um compilador GPU open source
Publicado em 8 de fevereiro de 2026, o artigo apresenta o VOLT, um compilador GPU open source, e aborda arquiteturas GPU abertas emergentes com funcionalidades SIMT.
Vulkan: barreiras de memória e layouts de imagem
Em post publicado em 3 de março de 2026, a RasterGrid explica barreiras de memória e layouts de imagem no Vulkan, temas relevantes para sincronização de memória em GPU.
- há 17 dias nvidia.fr
Otimização de GPUs: da pesquisa à medição
Uma publicação datada de 4 de julho de 2026 reúne artigos e palestras sobre desempenho de GPUs, com temas como desenrolamento de loops, ocultação de latência, álgebra linear densa e memória.
- há 17 dias x.com
Aritmética de 256 bits em kernels CUDA para GPU
Publicação de 22 de setembro de 2025 apresenta multiplicação e adição de 256 bits na GPU e aborda aritmética multiword em kernels CUDA.
Vamos avaliar seu projeto

Respondo com escopo e proposta.