


Notícias de IA e infraestrutura
Filtrar por tipo: Todos120
- há 16 dias x.com
Post sobre RoboJEPA: escala previsível em modelos de mundo robóticos
Post de rede social descreve o RoboJEPA, modelo de mundo JEPA de 8B parâmetros treinado com 15.022 horas de vídeo robótico, e ajustes de leis de escala que antecipam resultados de 4B e 8B.
- há 17 dias arxivb.org
LayerRoPE: codificar a profundidade nos pesos de normalização para Transformers muito profundos
O artigo propõe o LayerRoPE, que codifica a profundidade nos pesos de normalização para conter o crescimento da norma dos estados ocultos entre camadas, relatando loss de um modelo Pre-Norm de 1,3B com 3,4x menos compute e escala estável até 512 camadas.
- há 17 dias
 arxiv.org
RoboJEPA: como a escala de modelos de mundo JEPA afeta o planejamento robótico
A Meta apresentou o RoboJEPA, um modelo de mundo latente baseado em JEPA, escalado de 22M para 8B de parâmetros e treinado com dados de 12 embodiments robóticos. O artigo testa se o erro de predição latente prevê o desempenho de planejamento posterior.
- há 18 dias alphaxiv.org
H-JEPA: modelos de mundo hierárquicos para planejamento visual de longo prazo
O artigo, orientado por Yann LeCun, propõe o H-JEPA, com modelos de mundo JEPA empilhados em múltiplas escalas de tempo. O autor relata subida de 18% para 73% no Visual AntMaze com essa abordagem hierárquica.
- há 18 dias arxiv.org
Roteamento de experts com eficiência de memória para treinamento distribuído de MoE
O artigo no arXiv propõe métodos para reduzir o pico de memória no treinamento distribuído de Mixture-of-Experts, em que o dispatch de experts domina o uso de memória.
- há 18 dias github.com
Notebooks da Unsloth para fine-tuning e RL em diversos tipos de modelo
O repositório da Unsloth reúne mais de 250 notebooks para fine-tuning e RL em modelos de texto, visão, áudio, embeddings e TTS, que servem como exemplos de fluxos de treinamento.
- há 18 dias arxiv.org
Anti-grokking: sinais de perda de generalização nos pesos
Paper publicado em 4 de fevereiro de 2026 examina se matrizes de pesos podem revelar colapso tardio da generalização em dois experimentos com treinamento prolongado.
- há 18 dias arxiv.org
CE-GPPO busca preservar gradientes no RL de LLMs
Publicado em 30 de outubro de 2025, o paper apresenta o CE-GPPO, método que aborda gradientes de tokens de baixa probabilidade descartados pelo clipping do PPO e coordena a entropia da política durante o treinamento.
- há 18 dias x.com
Compressão de gradientes reduz demanda de rede no pretraining
Post publicado em 23 de dezembro de 2025 relata o uso de compressão de gradientes no pretraining, mantendo alta eficiência com um quarto da largura de banda de rede mencionada.
- há 18 dias x.com
DAPO relata avanço do GRPO no AIME, de 30% para 50%
Em paper publicado em 1º de março de 2026, o DAPO relata que o GRPO padrão atingiu 30% no AIME em seus experimentos, e que a adição de algumas técnicas elevou o resultado para 50%.
- há 18 dias x.com
DroPE amplia o contexto sem fine-tuning longo
Em post publicado em 12 de janeiro de 2026, o DroPE remove embeddings posicionais após o treinamento e usa uma calibração curta para estender o contexto. O post relata ganhos em retrieval e perguntas e respostas em 16k frente a baselines, em modelos de até 7B.
- há 18 dias arxiv.org
EB-JEPA explora modelos de mundo com previsões em embeddings
Publicado em 4 de fevereiro de 2026, o artigo apresenta a EB-JEPA, uma biblioteca open source modular para aprender representações e modelos de mundo com arquiteturas que preveem no espaço de representações, não no de pixels.
- há 18 dias manning.com
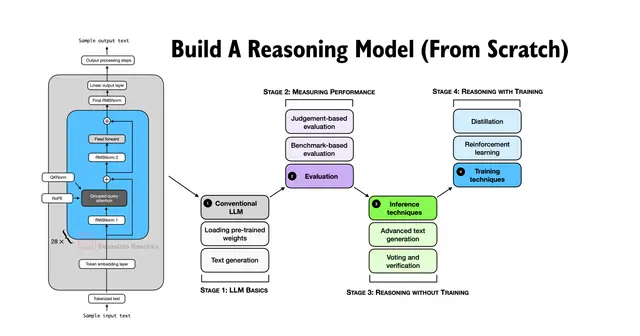
GRPO com recompensas verificáveis: como testar o método
Publicado em 31 de janeiro de 2026, um capítulo de Build a Reasoning Model (From Scratch) apresenta GRPO do zero para aprendizado por reforço com recompensas verificáveis.
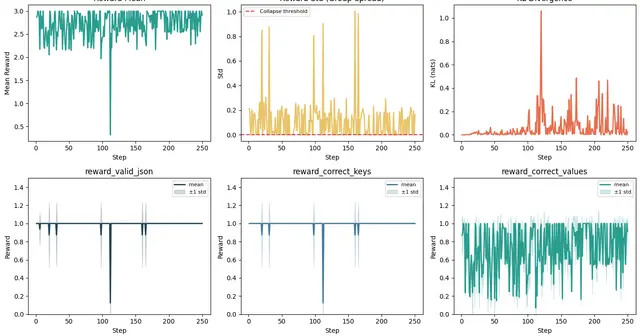
GRPO para extrair recibos em JSON com OCR
Artigo publicado em 4 de maio de 2026 apresenta um fluxo de fine-tuning com GRPO para extrair dados de recibos por OCR e estruturá-los em JSON.
- há 18 dias x.com
GRPO: parâmetro para investigar a estabilidade do treinamento
Relatório técnico INTELLECT-2, publicado em 26 de janeiro de 2026, aponta o uso de delta=4.0 como configuração para aumentar a estabilidade do treinamento GRPO.
- há 18 dias x.com
GRPO sem treinamento usa memória de experiências
Um post de 14 de fevereiro de 2026 descreve um método que mantém o modelo congelado e consulta rollouts bem-sucedidos e malsucedidos em memória textual. A abordagem afirma alcançar desempenho de fine-tuning com 100 exemplos.
- há 18 dias x.com
LeJEPA: chunks de SIGReg reduzem VRAM e tempo
Relato publicado em 4 de março de 2026 aponta que dividir 256 slices de SIGReg em chunks de 32 usou oito vezes menos VRAM e terminou mais rápido em uma GPU 4090 MaxQ.
- há 18 dias turingpost.com
LeJEPA combina predição latente e regularização
Publicado em 22 de novembro de 2025, o post descreve o LeJEPA, que combina a perda de predição em espaço latente do JEPA com o SIGReg para moldar embeddings em uma distribuição gaussiana isotrópica.
- há 18 dias x.com
LeWorldModel: JEPA compacto treinado a partir de pixels
Publicação de 9 de maio de 2026 descreve um JEPA de 15 milhões de parâmetros treinado de ponta a ponta com pixels brutos e relata planejamento até 48 vezes mais rápido que world models baseados em modelos fundacionais em tarefas de controle.
- há 18 dias x.com
LoRA como memória: como avaliar dados e rank
Post de 4 de março de 2026 resume um estudo sobre como a memória de conhecimento armazenada por LoRA escala e satura conforme o rank. QA e resumos geraram mais memória por token do que passagens brutas.
- há 18 dias arxiv.org
LoRA como memória de conhecimento: limites para avaliar
Publicado em 3 de março de 2026, o paper analisa adapters LoRA para atualizar o conhecimento de modelos de linguagem e examina capacidade, escalabilidade modular e interferência na mesclagem.
- há 18 dias arxiv.org
Megatron-LM divide modelos entre GPUs para viabilizar o treinamento
Um paper de 2019 da NVIDIA descreve o uso de model parallelism para treinar modelos de linguagem com bilhões de parâmetros, distribuindo os pesos entre GPUs quando não cabem em uma só.
- há 18 dias github.com
Melhorias no GRPO em um notebook PyTorch
Notebook de 15 de fevereiro de 2026 analisa melhorias para uma implementação de GRPO, incluindo razões de política limitadas, termo KL e recompensas de formato.
- há 18 dias arxiv.org
Ouroboros testa LoRA condicionada à entrada em transformers recursivos
Publicado em 25 de abril de 2026, o paper explora um controlador compacto que modula um bloco compartilhado de transformer por etapa. No Qwen2.5-3B, relata menor training loss que um baseline de 17 camadas, com ganhos observados in-distribution.
- há 18 dias x.com
Programa sul-coreano define requisitos para treinar modelos
Publicado em 31 de dezembro de 2025, o artigo descreve três requisitos para equipes de uma iniciativa sul-coreana de treinamento de modelos: treinar do zero, permitir algum uso comercial e perseguir metas ambiciosas.
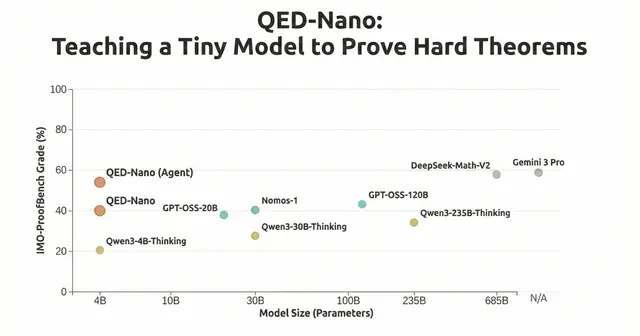
QED-Nano: o que um modelo de 4B ensina sobre provas matemáticas
Um post publicado em 15 de fevereiro de 2026 apresenta o QED-Nano, projeto para treinar um modelo de 4 bilhões de parâmetros a provar problemas de olimpíada, com materiais sobre treinamento, dados e implementação.
- há 18 dias x.com
QLoRA: fine-tuning com 50 saídas de um modelo teacher
Um post publicado em 24 de fevereiro de 2026 descreve uma demonstração local que usa 50 saídas do GPT-5.2 para ajustar um modelo Llama de 3 bilhões de parâmetros com QLoRA.
Receitas de RL para avaliar treinamento de modelos
Documentação publicada em 25 de fevereiro de 2026 reúne receitas de treinamento com aprendizado por reforço para raciocínio matemático, geração de código e uso de ferramentas.
- há 18 dias x.com
Recompensas por etapa no treinamento com flow matching
Descrição publicada em 15 de fevereiro de 2026 apresenta o TurningPoint-GRPO, framework que identifica etapas com mudanças de sinal na recompensa local para capturar dependências de longo prazo.
- há 18 dias x.com
Ring-linear 2.0: atenção híbrida e otimização FP8
Em post publicado em 27 de outubro de 2025, a Ant Group descreve dois modelos que combinam atenção linear e softmax e afirma ganhos de eficiência no treinamento com operadores FP8.
- há 18 dias arxiv.org
RobustMerge consolida MLLMs especialistas sem retreinamento
Publicado em 15 de novembro de 2025, o post descreve um método para combinar modelos multimodais ajustados para tarefas específicas em um modelo multitarefa, sem novo treinamento.
- há 18 dias huggingface.co
RoPE e decisões de arquitetura de modelos
Publicação de 12 de abril de 2026 apresenta um artigo como explicação de rotary positional embeddings (RoPE), voltada a engenheiros que estudam codificação posicional.
- há 18 dias x.com
SAM no mid-training pode reduzir o esquecimento no fine-tuning
Post de 8 de maio de 2026 afirma que aplicar SAM nos 10% finais do mid-training reduziu em mais de 35% o esquecimento após fine-tuning ou quantização.
- há 18 dias arxiv.org
SFT com taxas menores pode preservar capacidades gerais
Estudo publicado em 23 de outubro de 2025 relata que taxas de aprendizado menores podem manter capacidades gerais de LLMs sem perder desempenho especializado; também apresenta o método TALR.
- há 18 dias arxiv.org
SHINE gera adapters LoRA a partir de contexto em uma passagem
Publicado em 6 de abril de 2026, o paper apresenta uma hypernetwork que mapeia contextos para adapters LoRA, reutilizando os parâmetros congelados de um LLM.
- há 18 dias x.com
TC-JEPA: legendas orientam o aprendizado visual
Post publicado em 9 de maio de 2026 descreve um método self-supervised que usa legendas para orientar a previsão de patches mascarados em imagens. Segundo o post, a abordagem melhora a estabilidade do treinamento e o raciocínio visual em comparação com métodos contrastivos.
- há 18 dias deeplearning.ai
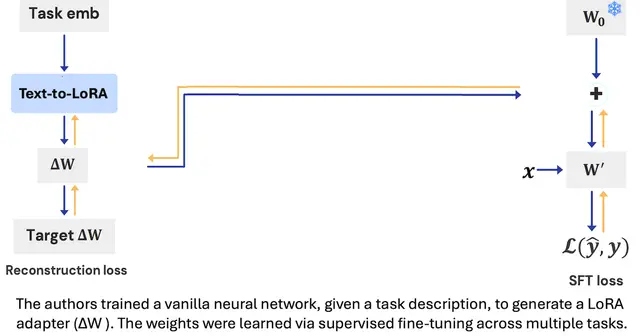
Text-to-LoRA gera adapters a partir de descrições
Publicado em 21 de outubro de 2025, o estudo da Sakana AI apresenta um método que gera adapters LoRA para tarefas a partir de descrições em linguagem natural e avalia seus resultados em 479 tarefas.
- há 18 dias x.com
Tile Kernels otimizam operações de LLM em GPU
Em 23 de abril de 2026, a empresa publicou kernels de GPU desenvolvidos com TileLang para operações de LLM e informou que alguns são usados em treinamento e inferência internos.
- há 18 dias
 unsloth.ai
Unsloth: ajuste fino de modelos de embeddings
Em 22 de janeiro de 2026, a documentação da Unsloth apresentou um guia de fine-tuning de modelos de embeddings, com um notebook Colab para um modelo de 300 milhões de parâmetros.
- há 18 dias turingpost.com
Variantes de LoRA: como comparar estratégias de ajuste eficiente
Publicado em 26 de abril de 2026, o artigo da Turing Post apresenta mais de 15 variantes de LoRA, como QLoRA, DoRA e Mixture-of-LoRA-Experts, e acompanha a evolução do ajuste eficiente em parâmetros para grandes modelos de linguagem.
Vamos avaliar seu projeto

Respondo com escopo e proposta.