


Notícias de IA e infraestrutura
Filtrar por tipo: Todos169
Como estruturar ciclos de autoaperfeiçoamento em IA
Artigo de 13 de setembro de 2026 apresenta uma estrutura para sistemas de IA identificarem limitações, validarem mudanças e preservarem melhorias ao longo de ciclos persistentes.
Como LLMs representam somas e erros aritméticos
Artigo publicado em 28 de junho de 2026 analisa representações internas durante somas com vários operandos e propõe um modelo geométrico para explicar erros aritméticos.
Como reduzir custo e latência em aplicações com LLMs
Artigo de 10 de julho de 2026 explora alternativas a cadeias longas de raciocínio para equilibrar precisão, contexto, custo computacional e latência.
Como testar consultas de n-gramas em modelos de linguagem
Uma publicação técnica datada de 25 de agosto de 2026 descreve o Engram, módulo que recupera embeddings de n-gramas e pode transferir sua tabela de consulta para a CPU com pouca lentidão na inferência.
Compartilhamento de projeções QKV em Transformers
Artigo publicado em 2 de julho de 2026 avalia variantes que compartilham projeções de atenção e relata que igualar key e value foi excessivo para os LLMs ternários pequenos do autor.
CTM-AI explora uma arquitetura de IA inspirada em consciência
Publicado em 25 de agosto de 2026, o artigo apresenta o projeto inicial CTM-AI, que aplica a Conscious Turing Machine à arquitetura de IA, sem relatar resultados de benchmarks.
Depth-wise batching em modelos recorrentes: como avaliar
Um post publicado em 2 de setembro de 2026 descreve como sobrepor requisições em diferentes profundidades recorrentes pode melhorar a utilização de modelos com computação adaptativa.
DepthBench propõe avaliar a profundidade computacional em Transformers
Apresentado em 29 de setembro de 2026, o DepthBench compara métodos de fluxo de informação e examina se eles ajudam Transformers mais profundos a aproveitar suas camadas de forma eficaz.
Destilação de Transformers para modelos Mamba
Paper de 29 de setembro de 2026 estuda a transferência de conhecimento de Transformers pré-treinados para modelos de espaço de estados, como o Mamba.
Diffusing Blame propõe treinar redes sem backpropagation
Postagem publicada em 17 de julho de 2026 descreve um método de roteamento de sinais de erro e relata resultados em reconhecimento de imagens, locomoção e Craftax.
Difusão em loop: reutilizar blocos do Transformer
Artigo publicado em 3 de outubro de 2026 descreve um modelo de geração de imagens por texto que reutiliza blocos do Transformer durante a denoising e relata ganhos com mais loops.
Dust explora treinamento de transformers sem gradientes
Publicado em 5 de outubro de 2026, o paper apresenta o Dust, método zeroth-order que usa perturbações de ativações e relata experimentos de escala e comparações com backpropagation.
Estado recorrente pode ampliar a memória de Transformers
A descrição do Recurrent Looped Transformer, datada de 13 de setembro de 2026, apresenta um decoder recorrente que preserva estado entre tokens para ampliar o caminho temporal de informação.
Fatoração de attention e fluxo de gradientes: implicações para modelos
Publicada em 30 de setembro de 2026, a publicação discute como fatorar a matriz de attention como S = WWᵀ pode alterar o fluxo de gradientes e remover um gargalo de expoente de informação na otimização.
Filtragem de contexto na atenção para hardware limitado
Artigo da SAS, publicado em 16 de setembro de 2026, descreve um seletor treinado de ponta a ponta dentro do Softmax para filtrar contexto em mecanismos de atenção voltados a hardware com recursos computacionais limitados.
FlashAttention-3: otimização de attention em GPUs Hopper
O artigo, publicado em 24 de setembro de 2026, apresenta técnicas de execução assíncrona e baixa precisão para acelerar attention em GPUs Hopper, com foco em tráfego de memória e uso do hardware.
FlowTracer rastreia tokens influentes no raciocínio de LLMs
Publicado em 4 de julho de 2026, o artigo apresenta um método que usa atenção para rastrear a propagação de informação e direcionar a atribuição de crédito no treinamento por reforço.
Fluxos recorrentes refinam o raciocínio em tarefas discretas
Um post publicado em 3 de setembro de 2026 descreve modelos que combinam fluxos contínuos e refinamento recorrente para resolver problemas estruturados, como Sudoku.
FuncAttn leva attention funcional a dados contínuos
Post de 25 de junho de 2026 descreve um método que aplica operadores lineares estruturados à attention entre espaços de funções, com resultados em solução de PDEs, segmentação 3D e regressão.
Functional Attention propõe atenção de custo linear
Publicado em 6 de julho de 2026, o paper descreve uma forma de representar query e key/value com bases aprendidas e uma matriz compacta, relatando custo linear no número de pontos.
Gated Linear Attention: atenção linear com gates
Publicado em 20 de setembro de 2026, o artigo apresenta uma formulação de transformer com atenção linear e gates dependentes dos dados, expressável também como uma RNN com estados ocultos matriciais.
GLM-5.3-Flash: visão geral da arquitetura
Publicada em 26 de agosto de 2026, a visão geral descreve uma arquitetura híbrida com attention 3:1, backbone sparse MoE menor, residual path mHC com quatro streams e vision encoder nativo.
GOAT propõe priors treináveis para a attention
Publicado em 3 de outubro de 2026, o paper interpreta a attention padrão como um problema de transporte ótimo entrópico com prior uniforme implícito e apresenta o GOAT, com prior contínuo e treinável.
Gradientes BF16 crescem no fim do treinamento
Um artigo relata aumento de 1.000 vezes na norma do gradiente após 25 bilhões de tokens em um transformer treinado com FlashAttention-3 em BF16.
HiLS aprende a selecionar chunks para sparse attention
Publicado em 7 de julho de 2026, o artigo apresenta a HiLS, uma abordagem que aprende a selecionar chunks para sparse attention com a loss de modelagem de linguagem.
HOLA combina atenção linear com cache KV exato e limitado
Publicado em 3 de julho de 2026, o artigo apresenta o HOLA: uma arquitetura que combina estado recorrente e cache limitado de key-values, com ganhos relatados em perplexidade e recall de longo alcance.
HOLA combina estado recorrente e cache limitado para contextos longos
Post de 6 de julho de 2026 descreve o HOLA, que usa estado recorrente e um pequeno KV cache para memória exata. O método reduz a perplexidade em 16,1% e mantém recuperação robusta em 32 mil tokens.
HydraHead combina dois tipos de atenção por head
Publicado em 30 de junho de 2026, o post sobre HydraHead descreve uma arquitetura que combina Full Attention e Linear Attention no nível dos heads para buscar mais eficiência em modelos de contexto longo.
HySparse2 propõe compartilhamento de KV em dois níveis
Datado de 27 de setembro de 2026, o paper apresenta um método híbrido de atenção esparsa para reduzir demandas de prefill e compactar o armazenamento de KV cache em agentes com contextos longos.
HySparse2 reduz custo de contexto longo com reuso de KV
Publicado em 23 de setembro de 2026, o post descreve dois níveis de compartilhamento de KV para reduzir FLOPs de prefill e tamanho do cache, com melhores scores de retrieval que o Hybrid SWA do MiMo-V2.6 em contexto de 1 milhão de tokens.
IA com profundidade recorrente: desafios para monitorar
Publicação de 2 de setembro de 2026 afirma que a IA Astra usa raciocínio com profundidade recorrente, o que pode dificultar o monitoramento, afetar custos e desempenho e complicar a supervisão.
iLLaDA: difusão mascarada em um modelo de 8B
Descrição publicada em 25 de junho de 2026 apresenta o iLLaDA, modelo de linguagem de difusão mascarada de 8B treinado do zero com atenção totalmente bidirecional.
iLLaDA treina modelo de difusão com 8 bilhões de parâmetros
Artigo publicado em 27 de junho de 2026 descreve o treinamento de um Transformer de 8 bilhões de parâmetros com difusão mascarada bidirecional em 12 trilhões de tokens.
Interpretabilidade além dos conceitos humanos
Publicado em 22 de setembro de 2026, o paper investiga se modelos de linguagem usam representações internas que não correspondem adequadamente a conceitos humanos familiares.
Interpretabilidade automatizada para heads de atenção
Paper publicado em 29 de junho de 2026 descreve uma técnica que explica heads de atenção com programas Python. Substituir cerca de 40% dos padrões de atenção no Llama-3B por saídas desses programas quase não afetou o desempenho nas tarefas avaliadas.
Jagged Flash Attention na NVIDIA Blackwell: lições para otimizar kernels
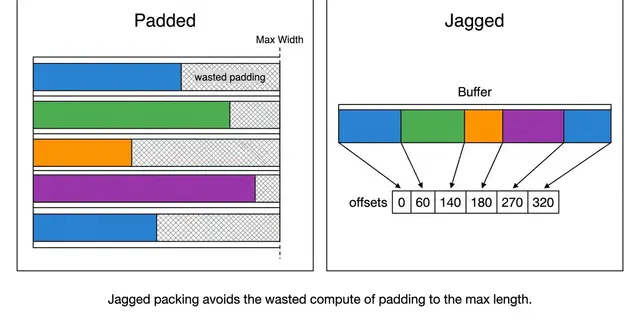
Em artigo publicado em 1º de outubro de 2026, o blog do PyTorch descreve um kernel de attention desenvolvido com TLX para a NVIDIA Blackwell. Nas formas jagged do Generative Ads Model da Meta, o artigo relata desempenho superior ao FlashAttention-4.
Jamba combina Transformer, Mamba e MoE
O artigo, publicado em 20 de setembro de 2026, descreve uma arquitetura híbrida que intercala blocos Transformer e Mamba e usa mixture-of-experts em algumas camadas.
KATA explora spherical packing para recall em linear attention
Artigo publicado em 16 de setembro de 2026 apresenta KATA, uma abordagem geométrica que formula o associative recall em linear attention como um problema de spherical packing.
Kernel de atenção paginada em Triton para inspeção técnica
Publicação de 10 de julho de 2026 compartilha um kernel de atenção paginada em Triton atribuído a um modelo de IA e um arquivo de solução no KernelBench.
KITE amplia Transformers sem aumentar o cálculo de KV
Publicado em 29 de setembro de 2026, o material descreve o KITE, uma abordagem que amplia componentes do decoder reutilizando um KV cache gerado por um prefiller menor.
 arxiv.org
Vamos avaliar seu projeto

Respondo com escopo e proposta.