


Notícias de IA e infraestrutura
Filtrar por tipo: Artigo33
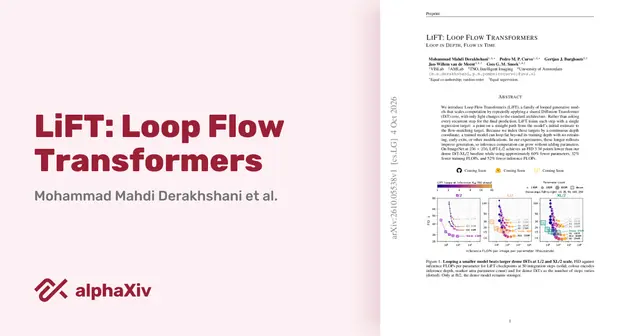
LiFT: transformers em loop para gerar imagens com flow matching e custo ajustável na inferência
Artigo apresenta o LiFT, um gerador de imagens com flow matching que reutiliza um núcleo transformer compartilhado em loops. Segundo o autor, um modelo treinado com 2 loops melhora com até 16 loops na inferência, sem retreinar.
Atenção com KV compartilhado: eficiência e custo de computação
Publicação de 29 de abril de 2026 compara MQA de alta ordem e MLA: compartilhamento de KV pode reduzir a pressão sobre o cache, em troca de mais computação por token.
- há 17 dias k-a.in
Avalie atenção esparsa comprimida em modelos
Uma implementação publicada em 28 de abril de 2026 reproduz a técnica Compressed Sparse Attention descrita em um paper recente, oferecendo uma referência para equipes de engenharia examinarem essa variante de atenção.
Como comparar três métodos de self-distillation on-policy
Artigo de 12 de fevereiro de 2026 examina OPSD, SDFT e SDPO, métodos que usam feedback mais denso, e aborda benchmarks e limitações.
Como estimar custos de treinamento de loop models
Um artigo de blog publicado em 19 de abril de 2026 analisa sete variantes de loop models e como a estrutura dos gradientes afeta FLOPs e memória.
Mecanismos de atenção: como comparar arquiteturas de Transformers
Um artigo publicado em 19 de abril de 2026 apresenta mais de 13 mecanismos de atenção e explica como eles influenciam o processamento de contexto e memória em Transformers e LLMs.
Sequential Attention propõe modelos mais enxutos
Em 9 de fevereiro de 2026, o Google Research apresentou a Sequential Attention, abordagem que seleciona recursos ou camadas durante o treinamento para buscar modelos mais rápidos e enxutos sem sacrificar a precisão.
Técnicas para tornar o serving de LLMs mais eficiente
Notas de aula publicadas em 13 de maio de 2026 abordam quantização, sparsity, atenção, speculative decoding e batching para melhorar a inferência e o serving de LLMs.
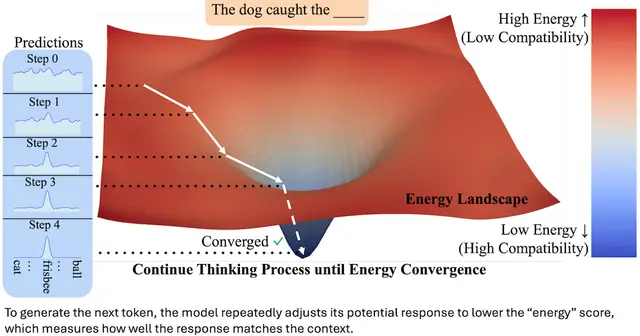
Transformers com energia refinam previsões de tokens
Um paper publicado em 27 de setembro de 2025 relata que Energy-Based Transformers, com 44 milhões de parâmetros, superaram transformers vanilla em três de quatro benchmarks usando RedPajama-Data-v2.
Agentes otimizam kernels de atenção em GPU
Post da NVIDIA, publicado em 28 de setembro de 2026, relata kernels de atenção com desempenho até 2,96 vezes maior que FlashKDA em B300 e um décimo do erro de estado.
Algoritmos nos pesos de transformers: aplicações práticas
Publicado em 24 de junho de 2026, o artigo sobre The Transformer Cookbook descreve como codificar algoritmos de adição, busca e ramificação nos pesos de transformers, seguindo o trabalho sobre RASP.
Atenção sob demanda pode equilibrar contexto longo e velocidade
Em publicação datada de 20 de setembro de 2026, a abordagem On-Demand Attention usa uma head leve para acionar o contexto completo quando necessário, buscando acelerar a decodificação sem perder tanto desempenho quanto a atenção local.
BF16 no FlashAttention: monitore a estabilidade dos gradientes
Em 29 de setembro de 2026, um trabalho técnico relatou que o arredondamento BF16 no FlashAttention pode quebrar uma simetria do gradiente do softmax e causar explosões no fim do treinamento. Os autores propõem o GProj como correção.
Como avaliar o acesso de LLMs ao conhecimento em seus parâmetros
Em publicação de 28 de junho de 2026, o blog do Google Research examina como o raciocínio pode ajudar modelos de linguagem a acessar conhecimento armazenado em seus parâmetros. A questão pode orientar testes internos de modelos e prompts.
Como estruturar ciclos de autoaperfeiçoamento em IA
Artigo de 13 de setembro de 2026 apresenta uma estrutura para sistemas de IA identificarem limitações, validarem mudanças e preservarem melhorias ao longo de ciclos persistentes.
Difusão em loop: reutilizar blocos do Transformer
Artigo publicado em 3 de outubro de 2026 descreve um modelo de geração de imagens por texto que reutiliza blocos do Transformer durante a denoising e relata ganhos com mais loops.
HySparse2 propõe compartilhamento de KV em dois níveis
Datado de 27 de setembro de 2026, o paper apresenta um método híbrido de atenção esparsa para reduzir demandas de prefill e compactar o armazenamento de KV cache em agentes com contextos longos.
IA com profundidade recorrente: desafios para monitorar
Publicação de 2 de setembro de 2026 afirma que a IA Astra usa raciocínio com profundidade recorrente, o que pode dificultar o monitoramento, afetar custos e desempenho e complicar a supervisão.
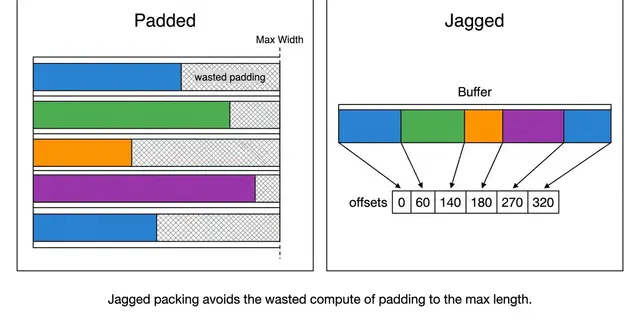
Jagged Flash Attention na NVIDIA Blackwell: lições para otimizar kernels
Em artigo publicado em 1º de outubro de 2026, o blog do PyTorch descreve um kernel de attention desenvolvido com TLX para a NVIDIA Blackwell. Nas formas jagged do Generative Ads Model da Meta, o artigo relata desempenho superior ao FlashAttention-4.
Kernel de atenção paginada em Triton para inspeção técnica
Publicação de 10 de julho de 2026 compartilha um kernel de atenção paginada em Triton atribuído a um modelo de IA e um arquivo de solução no KernelBench.
LiFT amplia a inferência iterativa com um núcleo DiT compartilhado
Publicada em 6 de outubro de 2026, a pesquisa relata que LiFT supera um baseline DiT denso no ImageNet 256×256 com cerca de 60% menos parâmetros.
LoopCD refina a decodificação de Transformers sem novo treinamento
O artigo, publicado em 2 de outubro de 2026, apresenta uma técnica que compara previsões de estados recorrentes iniciais e finais para refinar a decodificação. Relata maior acurácia no AIME 2024 com Ouro-2.6B-Thinking.
Looped-DiT reutiliza blocos para reduzir computação
Um post publicado em 1º de outubro de 2026 afirma que o Looped-DiT superou um modelo 6,5 vezes maior em benchmarks de geração de imagens, com 4,9 vezes menos computação na inferência.
Matryoshka Attribution localiza pesos ligados a comportamentos de modelos
Em post publicado em 28 de setembro de 2026, Matryoshka Attribution é apresentada como uma técnica para classificar representações neurais e mudanças de pesos por sua influência no comportamento.
Memória compartilhada reduz o uso de memória em Transformers recorrentes
Artigo publicado em 5 de outubro de 2026 relata redução de 76–79% na memória de contexto e melhora de qualidade em modelos de 150 milhões a 1 bilhão de parâmetros.
Memória indexada por token muda a atenção em Transformers
Um post publicado em 25 de setembro de 2026 descreve uma arquitetura que soma chaves contextuais e vetores de memória indexados por token, específicos de cada camada, e permite manter a memória na CPU.
Modelos de linguagem por difusão: técnicas e aplicações
Publicado em 8 de julho de 2026, o post do Kuleshov Group apresenta modelos de linguagem por difusão e aborda masked diffusion, refinamento iterativo, pós-treinamento e geração de comprimento variável.
O papel da cadeia de pensamento em tarefas seriais
Artigo de 1º de outubro de 2026 investiga se a cadeia de pensamento contribui para o cálculo em Transformers e relata queda de precisão quando ela é removida de tarefas seriais.
OPAL reduz o custo de attention em contextos longos
Post de 29 de setembro de 2026 descreve o OPAL, método que treina modelos de linear attention com as próprias saídas e relata recuperação total em retrieval e 83–93% do desempenho em raciocínio matemático.
PC-ALM treina MLPs residuais de até 1.000 camadas
Publicado em 14 de setembro de 2026, o paper apresenta o PC-ALM, método de aprendizado local que treina redes profundas com desempenho descrito como quase equivalente ao da retropropagação.
Seleção de blocos em atenção esparsa cai para O(N log N)
Artigo publicado em 28 de setembro de 2026 apresenta seleção hierárquica de blocos com LogSumExp, reduzindo de O(N²) para O(N log N) o custo dessa etapa em modelos de contexto longo.
Treinamento recorrente melhora resultados em testes de raciocínio
Um post publicado em 16 de setembro de 2026 relata que objetivos locais de denoising elevaram o desempenho de modelos recorrentes em seis benchmarks, com 58,8% de acurácia no ARC-AGI-1.
TWT reduz o compute de Vision Transformers
Publicado em 26 de setembro de 2026, o post descreve o Transformer-Within-Transformer, que substitui grupos de camadas semelhantes. No DINOv2, relata cerca de metade do compute, com pequena queda de acurácia.
Vamos avaliar seu projeto

Respondo com escopo e proposta.