


Notícias de IA e infraestrutura
Filtrar por tipo: Todos66
- há 17 dias x.com
Como desenvolver kernels CUDA de matmul de alto desempenho
Publicado em 29 de setembro de 2025, o guia aborda hierarquia de memória de GPU, programação CUDA e inspeção de PTX/SASS para orientar o desenvolvimento de kernels de matmul.
Kernels de multiplicação de matrizes em GPUs NVIDIA
Artigo publicado em 1º de outubro de 2025 sobre arquitetura de GPUs e técnicas de kernels para acelerar multiplicações de matrizes.
- há 17 dias modal.com
Otimização de attention: lições do FlashAttention-4
Em post publicado em 26 de setembro de 2025, a Modal descreve técnicas de engenharia reversa do FlashAttention-4 e atribui a elas um ganho de performance de 20%.
Penny e a comunicação entre GPUs: o que observar
Post de 21 de setembro de 2025 inicia um diário sobre o desenvolvimento manual da Penny, uma biblioteca de comunicação para GPUs.
Atualização do guia CUDA da NVIDIA pede revisão técnica
A publicação da NVIDIA informa que o CUDA C++ Programming Guide foi atualizado em junho de 2026. Empresas que desenvolvem software para GPU podem revisar suas práticas e documentar os padrões usados nos projetos.
- há 18 dias tcgen05.mma
Tensor Memory no Blackwell e a acumulação de matmul
O post descreve como a Tensor Memory da arquitetura Blackwell, um espaço separado de 256 KB por SM, passa a armazenar resultados de Tensor Cores e reduz, segundo o autor, a emissão de matmul de 128 threads para uma.
- há 18 dias blog.mlc.ai
Como avaliar a otimização de kernels GPU por agentes
O TIRx Harness reúne análise de compilador, catálogo de kernels, especificações de hardware e avaliação remota em GPUs para explorar, depurar e otimizar kernels com agentes.
Como uma leitura de memória percorre a RTX 4090
Artigo datado de 13 de agosto de 2026 acompanha uma instrução LDG.E SASS pelas unidades de hardware e pela hierarquia de memória da RTX 4090, incluindo detalhes obtidos por engenharia reversa.
- há 18 dias x.com
CUDA C++: execução, memória e correção em GPU
Publicado em 19 de setembro de 2026, o guia de programação CUDA C++ da NVIDIA aborda kernels, threads, memória, sincronização, erros e validação dos resultados da GPU frente à CPU.
Do nvcc aos warps: como um kernel CUDA é executado
Publicado em 8 de julho de 2026, o artigo acompanha um kernel de soma de vetores da compilação com nvcc até sua execução por warps na GPU.
- há 18 dias arxiv.org
FIBER propõe separar registradores da execução na GPU
Publicado em 21 de agosto de 2026, o artigo apresenta uma arquitetura de GPU que desacopla a propriedade de registradores das instâncias de execução paralela.
- há 18 dias x.com
Fork habilita P2P via PCIe em GeForce
Post de 27 de agosto de 2026 relata uma alteração em drivers gráficos para habilitar transferências peer-to-peer via PCIe em GeForce durante a otimização de serving em GPU.
- há 18 dias x.com
GPU de dois núcleos em FPGA de US$ 30: o que avaliar
Publicado em 9 de julho de 2026, o artigo descreve uma GPU de dois núcleos implementada em FPGA de US$ 30, capaz de executar inferência de IA a 81 MHz.
- há 18 dias arxiv.org
GPU-Tile-Sim propõe simulação de GPU para co-design de LLMs
Publicado em 14 de julho de 2026, o paper propõe um framework de simulação de GPU baseado em tiles para apoiar o co-design de hardware e software de LLMs.
Índices de GPU ampliam suporte a PyTorch e Python
Post da Astral, publicado em 5 de outubro de 2026, informa suporte a PyTorch 2.13 e 2.14 e Python 3.15, com wheels para GPU de pacotes como FlashAttention e DeepSpeed.
- há 18 dias x.com
Latency hiding em GPUs: medir antes de otimizar
Capítulo de Vasily Volkov, da UC Berkeley, publicado em 4 de julho de 2026, sobre como GPUs ocultam latência e conceitos de arquitetura ligados ao desempenho.
- há 18 dias mlc.ai
Livro da CMU aborda programação de GPUs para sistemas de ML
Publicado em 23 de junho de 2026, o livro online reúne material de uma minissérie do curso de ML Systems da CMU sobre técnicas de programação de GPUs.
- há 18 dias vxlang.org
Memória heterogênea: verificações de capacidade no compilador
Em post publicado em 28 de setembro de 2026, Vx descreve um modelo de máquinas baseado em capacidade, conexões e visibilidade e relata dois erros de capacidade encontrados em um laptop sem GPU.
- há 18 dias x.com
O que acontece ao lançar um kernel CUDA
Post publicado em 11 de julho de 2026 sobre a comunicação entre CPU e GPU necessária para lançar um kernel CUDA e o trabalho envolvido nessa operação.
- há 18 dias leetgpu.com
Prática de CUDA com desafios de GPU
Em post publicado em 12 de agosto de 2026, o LeetGPU recomenda uma trilha de desafios para praticar CUDA, de kernels SIMD a shared memory, tiling e recursos mais avançados.
- há 18 dias x.com
PufferLib 4.0 relata escala multi-GPU
Publicado em 21 de junho de 2026, o relatório sobre PufferLib 4.0 informa aceleração de 6,6× em oito GPUs num teste de pior caso e throughput superior a 100 milhões de steps por segundo em oito RTX 5090.
- há 18 dias github.com
Repositório auto-gpu-kernel 1.0 gera kernels e harnesses para GPU
Publicado em 15 de setembro de 2026, o repositório apresenta um sistema que evolui kernels e harnesses para GPU e que venceu a categoria DSA de um concurso do MLSys 2026 FlashInfer.
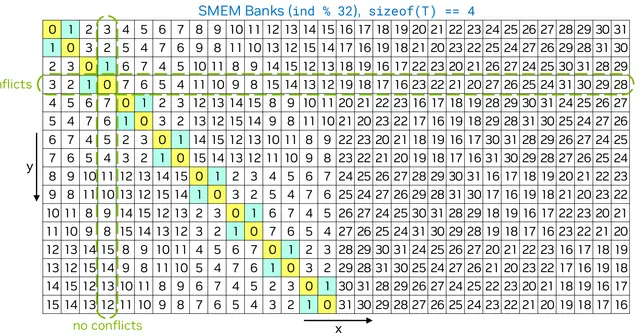
Swizzling para reduzir conflitos na shared memory CUDA
Artigo técnico datado de 13 de agosto de 2026 aborda o uso de swizzling para lidar com conflitos de bancos na shared memory do CUDA, que podem afetar o desempenho de kernels.
- há 18 dias github.com
Symmetric memory pode otimizar comunicação em GPU
Post do Machine Learning Engineering Open Book, publicado em 5 de outubro de 2026, aborda symmetric memory no NCCL e no PyTorch e seu potencial para payloads pequenos e médios e para sobrepor comunicação e computação.
Vulkan: compute shaders, GPUs e modelos de memória
Tutorial publicado em 12 de julho de 2026 apresenta compute shaders, arquitetura de GPU e modelos de memória, conceitos que também ajudam a compreender o DirectX 12.
- há 18 dias
 hgpu.org
Xtrace propõe rastreamento detalhado de kernels de GPU
Descrição publicada em 27 de setembro de 2026 apresenta o Xtrace, uma abordagem de tracing intra-kernel que insere probes por splicing de instruções em nível binário.
Vamos avaliar seu projeto

Respondo com escopo e proposta.