


Notícias de IA e infraestrutura
Filtrar por tipo: Artigo33
- há 17 dias amazon.com
Como estruturar uma trilha de programação CUDA
Em publicação de 9 de novembro de 2025, um autor recomenda estudar C/C++ e álgebra linear antes de CUDA e indica livros e um curso para iniciar em programação de GPU.
Computação em GPU: da arquitetura à otimização
Artigo introdutório publicado em 28 de março de 2026 apresenta arquitetura e computação em GPU como contexto para engenheiros que desenvolvem ou otimizam software para esse hardware.
- há 17 dias
 hgpu.org
CuBridge explora LLMs para reconstruir kernels CUDA de attention
Publicado em 10 de maio de 2026, o texto apresenta o CuBridge, framework que usa LLMs para entender e reconstruir kernels de attention eficientes em CUDA.
- há 17 dias manning.com
CUDA para LLMs: kernels, atenção e profiling
Publicado em 3 de fevereiro de 2026, o livro da Manning apresenta programação CUDA para GPUs NVIDIA, de kernels básicos a Flash Attention, e aborda profiling com Nsight Compute.
De SIMD a SIMT: o que a evolução das GPUs muda na prática
Em artigo publicado em 5 de fevereiro de 2026, o ACM SIGGRAPH Blog explica como GPUs combinaram abstrações de threads com hardware SIMD, tornando-se processadores flexíveis para gráficos, IA e computação científica.
Escalonamento de tiles no CuTeDSL e kernels persistentes
Post publicado em 15 de maio de 2026 apresenta o StaticPersistentTileScheduler no CuTeDSL e sua utilidade para organizar kernels persistentes.
Falhas em módulos Linux de GPU ampliam risco local
Em 8 de novembro de 2025, a Quarkslab descreveu dois bugs em módulos de kernel Linux para GPUs, exploráveis por um processo local sem privilégios.
GPU Blackwell: o que a arquitetura significa para suas cargas de trabalho
Artigo publicado em 3 de março de 2026 examina a GPU Blackwell e a relaciona à tradição da NVIDIA de construir GPUs grandes. O tema ajuda equipes a avaliar requisitos de hardware para suas cargas de trabalho.
Hardware de inferência em 2026: custo por token e trade-offs
Em artigo publicado em 28 de fevereiro de 2026, a Turing Post compara chips de inferência, incluindo GPUs, um acelerador programável para LLMs e uma abordagem que transforma modelos em hardware, com foco no custo por token.
- há 17 dias hgpu.org
HPC++ automatiza paralelização de C++ para CPUs e GPUs
Publicado em 22 de fevereiro de 2026, o texto apresenta um framework baseado em LLVM que converte programas sequenciais em C++ em implementações paralelas para CPUs multicore e GPUs compatíveis com OpenCL.
- há 17 dias tunbury.org
Inferência ONNX: CPU e GPU em comparação
Publicado em 11 de março de 2026, o artigo compara inferência com ONNX Runtime em uma GPU NVIDIA L4 e uma CPU AMD EPYC 9965. O autor relata que OCaml e o posicionamento de memória com libnuma aceleraram a inferência em CPU frente ao uso de GPUs escassas no TESSERA.
- há 17 dias tensara.org
Kernel CUDA para soma de arrays: do exemplo à prática
Publicado em 16 de novembro de 2025, o artigo da Tensara apresenta a iniciantes a escrita de um kernel CUDA simples para somar arrays. O exemplo pode servir de base para avaliar cargas de trabalho em GPU.
Kernel de matmul em CUDA/PTX relata ganho de 6% no B200
Post publicado em 27 de abril de 2026 descreve um kernel de multiplicação de matrizes em CUDA/PTX puro que, no B200 e com M=N=K=8192, teria superado o desempenho do cuBLAS em 6%.
Otimização de kernels GPU além das tabelas de latência SASS
Post de 25 de novembro de 2025 questiona a utilidade de tabelas de latência SASS extraídas pelo nvdisasm e aponta ganhos de 3–4% com reordenação de instruções, diante de um limite teórico de 10%.
- há 17 dias siboehm.com
Otimização iterativa de multiplicação de matrizes em CUDA
Em artigo publicado em 26 de fevereiro de 2026, Simon Boehm descreve a otimização de um kernel CUDA para se aproximar do desempenho do cuBLAS, sem pretender substituí-lo.
- há 17 dias hgpu.org
RL agentic para gerar kernels CUDA de alto desempenho
Post de 4 de março de 2026 apresenta o CUDA Agent, sistema de reinforcement learning agentic em larga escala para gerar kernels CUDA, uma tarefa que exige conhecimento especializado de hardware.
- há 17 dias khronos.org
Subgroups no Vulkan 1.1: paralelismo na GPU
Em tutorial publicado em 4 de março de 2026, a Khronos explica como subgroups no Vulkan 1.1 permitem compartilhar e manipular dados entre tarefas paralelas na GPU.
- há 17 dias hgpu.org
Treinamento FP4 de modelos MoE em GPUs Hopper
A página, publicada em 8 de março de 2026, aborda treinamento FP4 de modelos MoE de grande escala em GPUs Hopper e aponta memória de ativações e comunicação entre especialistas como gargalos.
- há 17 dias hgpu.org
VOLT: como projetar um compilador GPU open source
Publicado em 8 de fevereiro de 2026, o artigo apresenta o VOLT, um compilador GPU open source, e aborda arquiteturas GPU abertas emergentes com funcionalidades SIMT.
Vulkan: barreiras de memória e layouts de imagem
Em post publicado em 3 de março de 2026, a RasterGrid explica barreiras de memória e layouts de imagem no Vulkan, temas relevantes para sincronização de memória em GPU.
Kernels de multiplicação de matrizes em GPUs NVIDIA
Artigo publicado em 1º de outubro de 2025 sobre arquitetura de GPUs e técnicas de kernels para acelerar multiplicações de matrizes.
- há 17 dias modal.com
Otimização de attention: lições do FlashAttention-4
Em post publicado em 26 de setembro de 2025, a Modal descreve técnicas de engenharia reversa do FlashAttention-4 e atribui a elas um ganho de performance de 20%.
Penny e a comunicação entre GPUs: o que observar
Post de 21 de setembro de 2025 inicia um diário sobre o desenvolvimento manual da Penny, uma biblioteca de comunicação para GPUs.
- há 18 dias tcgen05.mma
Tensor Memory no Blackwell e a acumulação de matmul
O post descreve como a Tensor Memory da arquitetura Blackwell, um espaço separado de 256 KB por SM, passa a armazenar resultados de Tensor Cores e reduz, segundo o autor, a emissão de matmul de 128 threads para uma.
- há 18 dias blog.mlc.ai
Como avaliar a otimização de kernels GPU por agentes
O TIRx Harness reúne análise de compilador, catálogo de kernels, especificações de hardware e avaliação remota em GPUs para explorar, depurar e otimizar kernels com agentes.
Como uma leitura de memória percorre a RTX 4090
Artigo datado de 13 de agosto de 2026 acompanha uma instrução LDG.E SASS pelas unidades de hardware e pela hierarquia de memória da RTX 4090, incluindo detalhes obtidos por engenharia reversa.
Do nvcc aos warps: como um kernel CUDA é executado
Publicado em 8 de julho de 2026, o artigo acompanha um kernel de soma de vetores da compilação com nvcc até sua execução por warps na GPU.
Índices de GPU ampliam suporte a PyTorch e Python
Post da Astral, publicado em 5 de outubro de 2026, informa suporte a PyTorch 2.13 e 2.14 e Python 3.15, com wheels para GPU de pacotes como FlashAttention e DeepSpeed.
- há 18 dias mlc.ai
Livro da CMU aborda programação de GPUs para sistemas de ML
Publicado em 23 de junho de 2026, o livro online reúne material de uma minissérie do curso de ML Systems da CMU sobre técnicas de programação de GPUs.
- há 18 dias vxlang.org
Memória heterogênea: verificações de capacidade no compilador
Em post publicado em 28 de setembro de 2026, Vx descreve um modelo de máquinas baseado em capacidade, conexões e visibilidade e relata dois erros de capacidade encontrados em um laptop sem GPU.
- há 18 dias leetgpu.com
Prática de CUDA com desafios de GPU
Em post publicado em 12 de agosto de 2026, o LeetGPU recomenda uma trilha de desafios para praticar CUDA, de kernels SIMD a shared memory, tiling e recursos mais avançados.
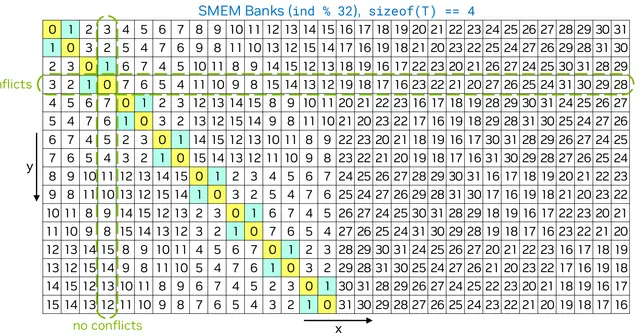
Swizzling para reduzir conflitos na shared memory CUDA
Artigo técnico datado de 13 de agosto de 2026 aborda o uso de swizzling para lidar com conflitos de bancos na shared memory do CUDA, que podem afetar o desempenho de kernels.
- há 18 dias hgpu.org
Xtrace propõe rastreamento detalhado de kernels de GPU
Descrição publicada em 27 de setembro de 2026 apresenta o Xtrace, uma abordagem de tracing intra-kernel que insere probes por splicing de instruções em nível binário.
Vamos avaliar seu projeto

Respondo com escopo e proposta.