


Notícias de IA e infraestrutura
Filtrar por tipo: Todos120
- há 19 dias github.com
Kyutai abre o stack de treinamento do Pocket TTS
Em 25 de agosto de 2026, a Kyutai publicou o stack de treinamento do Pocket TTS, com pipeline de dados, receitas de treinamento e avaliações para um modelo de síntese de fala executável em CPU.
- há 19 dias
 arxiv.org
LoRA+ propõe taxas distintas para matrizes adapter
Artigo de 24 de setembro de 2026 analisa como a mesma taxa de aprendizado para as matrizes A e B pode prejudicar o aprendizado de features em modelos largos e propõe usar taxas diferentes no fine-tuning.
- há 19 dias github.com
MaAI amplia os dados de treino do modelo VAP em inglês
Em post publicado em 6 de setembro de 2026, a MaAI informa que treinou seu modelo VAP em inglês com uma escala maior de dados. O projeto prevê sinais de conversação e movimentos de cabeça em tempo real.
- há 19 dias arxiv.org
Mol-JEPA explora dados multimodais para modelos moleculares
Post publicado em 25 de agosto de 2026 relata que o Mol-JEPA aprende com estruturas moleculares, fenótipos celulares e afinidades de ligação, com ganhos fora da distribuição em pequenos conjuntos de dados de ADME.
- há 19 dias x.com
NoRA propõe normalizar A na inicialização do LoRA
Post de 2 de setembro de 2026 descreve uma inicialização que normaliza as colunas de A no LoRA e relata resultados médios superiores aos de vários métodos de adaptação em SFT e RLVR.
- há 19 dias books.vizuara.ai
O que o pré-treinamento de um modelo MoE exige na prática
Publicado em 20 de agosto de 2026, o relato documenta uma tentativa de pré-treinar um modelo MoE de 1,02 bilhão de parâmetros em uma H200, incluindo pipeline de dados, falhas e ajustes de throughput.
- há 19 dias huggingface.co
onPanda permite anotar tokens e inspecionar modelos
Publicado em 22 de setembro de 2026, o repositório onPanda apresenta uma ferramenta open source para anotação de dados de LLMs e inspeção de modelos.
- há 19 dias huggingface.co
OPD com uma única consulta: o que o paper propõe
Datado de 29 de setembro de 2026, o paper testa destilação on-policy com uma única consulta em matemática, código, seguimento de instruções e uso de ferramentas por agentes.
- há 19 dias arxiv.org
ORPO reúne SFT e alinhamento de preferências em uma etapa
Publicado em 19 de setembro de 2026, o paper apresenta o ORPO, método que combina supervised fine-tuning e otimização de preferências sem um modelo de referência.
- há 19 dias x.com
Ostris AI Toolkit passa a treinar LoRAs para MiniMax H3
Em 3 de agosto de 2026, o repositório Ostris AI Toolkit anunciou suporte ao treinamento de LoRAs para MiniMax H3, limitado a fluxos de texto para vídeo e imagem para vídeo, com uso de pesos quantizados do Comfy.
- há 19 dias arxiv.org
Paper aponta ganho ao redistribuir capacidade entre camadas
Pesquisa sobre modelos de linguagem relata que uma alocação cossenoidal de capacidade melhorou a perplexidade sem ampliar parâmetros ou FLOPs.
- há 19 dias x.com
Poda de modelos usa tamanho efetivo da amostra para definir componentes
Post publicado em 1º de julho de 2026 apresenta o Effective Model Pruning, método que usa tamanho efetivo da amostra para calcular quantos componentes manter em redes neurais e modelos de linguagem.
- há 19 dias kawine.github.io
Post-training e adaptação de modelos no mundo real
Slides de uma palestra introdutória, publicados em 21 de agosto de 2026, apresentam métodos de post-training e questões de adaptação para agentes em ambientes mutáveis.
- há 19 dias posttrainbench.com
PostTrainBench destaca desempenho e confiabilidade de modelo
Em 25 de junho de 2026, um post sobre o PostTrainBench informou pontuações próximas no ranking e zero execuções com falha em 84 tentativas para o GLM 5.2.
- há 19 dias arxiv.org
PPO e GRPO: escolhas para treinamento de longo horizonte
Um post publicado em 21 de junho de 2026 discute limites de infraestrutura e de redução de variância do GRPO em sequências longas, em comparação com o PPO.
- há 19 dias alphaxiv.org
Projection Sampling adapta demonstrações para SFT
Paper publicado em 4 de outubro de 2026 apresenta uma forma de reescrever demonstrações de especialistas como trajetórias corretas e mais prováveis sob o modelo-alvo, para uso em supervised fine-tuning padrão.
- há 19 dias arxiv.org
Pruning ou treino do zero para LLMs pequenos?
Paper compara seis métodos de pruning do Llama-3.1-8B com treino do zero em dois cenários de orçamento de tokens; a vantagem depende de como o orçamento é contabilizado.
- há 19 dias arxiv.org
QLoRA: fine-tuning de modelo de 65 bilhões em GPU de 48 GB
Paper sobre QLoRA, datado de 20 de setembro de 2026, relata fine-tuning de um modelo de 65 bilhões de parâmetros em uma única GPU de 48 GB, com desempenho preservado em tarefas de ajuste em 16 bits.
- há 19 dias x.com
Ramificações locais para escalar a inferência de LLMs
Paper publicado em 5 de julho de 2026 propõe gerar e selecionar ramificações de tokens durante a inferência; o post relata melhora em raciocínio matemático frente a três abordagens de comparação.
- há 19 dias doi.org
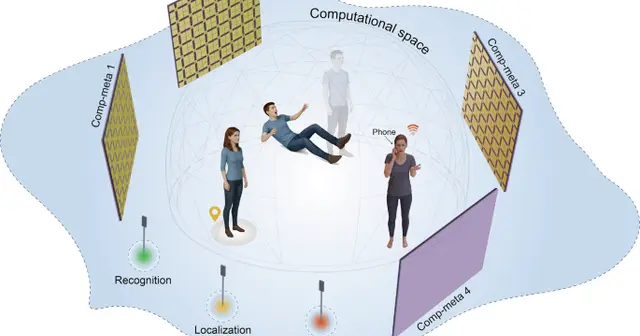
Rede neural física de metasuperfícies treinada sem modelos digitais
Artigo da Nature Communications descreve uma rede neural física com quatro metasuperfícies programáveis, que aprende por interações eletromagnéticas para focalizar ondas, reconhecer objetos e localizar alvos, sem modelos digitais.
- há 19 dias arxiv.org
ResidencyRL explora treino clínico em consultas simuladas
Publicado em 10 de agosto de 2026, o artigo descreve o uso de reinforcement learning em ambientes clínicos simulados para treinar raciocínio além de benchmarks médicos estáticos.
- há 19 dias zhihu.com
RL de longo horizonte pode favorecer PPO
Post no Zhihu, publicado em 24 de junho de 2026, argumenta que rollouts agentic longos e ruidosos podem dificultar a atribuição de crédito no GRPO e tornar útil o modelo de valor do PPO.
RL para comportamentos benéficos em vários domínios
Em post publicado em 18 de junho de 2026, a OpenAI relata que treinamento por reforço focado em comportamento melhorou o alinhamento em diferentes domínios e resistiu à pressão adversarial.
- há 19 dias x.com
RL pós-treinamento com menos parâmetros alterados
Um post publicado em 5 de julho de 2026 descreve uma abordagem que reforça camadas intermediárias de maior contribuição durante o RL pós-treinamento e pode igualar ou superar o treinamento de todos os parâmetros, alterando menos parâmetros.
- há 19 dias arxiv.org
RLSD ajusta atualizações de RLVR por token
Paper publicado em 11 de julho de 2026 apresenta um método de treinamento que combina recompensas do ambiente e self-distillation. Em cinco benchmarks de raciocínio multimodal, relata maior acurácia média que o modelo base e o GRPO.
- há 19 dias arxiv.org
RoLA propõe atenção linear de baixo rank para Diffusion Transformers
Publicado em 15 de setembro de 2026, o paper apresenta RoLA, um método que combina atenção linear de baixo rank e posição rotativa para enfrentar gargalos de escalonamento em Diffusion Transformers.
- há 19 dias x.com
Sampling no SFT: como avaliar o post-training
Um post publicado em 2 de outubro de 2026 apresenta um método que adiciona sampling ao stack de post-training e afirma que ele pode melhorar a generalização e reduzir o esquecimento em alguns casos.
- há 19 dias alphaxiv.org
Self-play para pré-treinar modelos sem dados naturais
Paper publicado em 26 de setembro de 2026 investiga pré-treinamento com sequências de bytes geradas por programas e relata transferência para modalidades e tarefas não vistas.
- há 19 dias x.com
Self-play sem dados reais: como avaliar a abordagem
Um trabalho datado de 25 de setembro de 2026 explora o pré-treinamento por self-play sem dados reais e relata reduções previsíveis na loss de validação zero-shot em várias modalidades.
- há 19 dias arxiv.org
SFT em LLMs: como acompanhar efeitos e decidir quando parar
Um artigo publicado em 15 de junho de 2026 analisa por que o ajuste supervisionado pode beneficiar modelos menores, mas produzir efeitos inconsistentes ou prejudiciais em LLMs.
- há 19 dias x.com
SIGReg de JEPA: conceitos e loop de treinamento
Publicado em 24 de julho de 2026, o guia apresenta números complexos, a fórmula de Euler, o teorema de Cramér–Wold e um loop funcional de treinamento relacionados ao SIGReg de JEPA.
- há 19 dias x.com
SIGReg e a repulsão entre pares no treinamento de JEPA
Post datado de 28 de setembro de 2026 descreve como o regularizador SIGReg aproxima um sliced MMD e introduz repulsão entre amostras no batch durante o treinamento de JEPA.
- há 19 dias github.com
slime: framework aberto para pós-treinamento de LLMs
Publicado em 19 de junho de 2026, o repositório da THUDM apresenta um framework para pós-treinamento de modelos de linguagem com aprendizado por reforço e scaling.
- há 19 dias arxiv.org
TAPA propõe atenção de fase sensível a tokens para contextos longos
Publicado em 26 de junho de 2026, o paper apresenta o Token-Aware Phase Attention (TAPA), um método de positional encoding com função de fase treinável, e o compara ao RoPE em contextos longos.
The Stack v3: dataset de código com 5 trilhões de tokens
O The Stack v3 reúne cerca de 5 trilhões de tokens de código em 713 linguagens filtradas e 224 milhões de repositórios, com coleta do GitHub concluída até agosto de 2025.
- há 19 dias x.com
TinyLoRA testa ajuste por reforço com 13 parâmetros
Post publicado em 17 de setembro de 2026 descreve uma técnica que usa 13 parâmetros treináveis e relata ganhos em três benchmarks matemáticos.
- há 19 dias x.com
TR-DPO limita desvios no treinamento com DPO
Publicação de 21 de setembro de 2026 descreve uma penalidade de divergência KL na loss do DPO para limitar o desvio em relação ao modelo de referência e estabilizar o treinamento offline.
- há 19 dias github.com
Treinamento online de DSpark no Speculators
Em 2 de julho de 2026, o repositório Speculators apresentou um script de shell para treinamento online de DSpark com Qwen3 0.6B e ShareGPT, no contexto de speculative decoding para vLLM.
- há 19 dias arxiv.org
Turn-PPO e treinamento de agentes em múltiplos turnos
Artigo publicado em 21 de junho de 2026 apresenta o Turn-PPO, método de estimativa de vantagem por turno para usar PPO no treinamento por reforço de LLMs agentic, e examina limitações do GRPO em tarefas de longo horizonte.
- há 19 dias arxiv.org
Vocabulary Transfer para melhorar sparse retrieval
Paper de 2 de julho de 2026 atribui o desempenho inferior de encoders avançados em learned sparse retrieval a incompatibilidades entre vocabulários de tokenizers e propõe Vocabulary Transfer.
Vamos avaliar seu projeto

Respondo com escopo e proposta.