


Notícias de IA e infraestrutura
Filtrar por tipo: Artigo20
- há 17 dias arxivb.org
LayerRoPE: codificar a profundidade nos pesos de normalização para Transformers muito profundos
O artigo propõe o LayerRoPE, que codifica a profundidade nos pesos de normalização para conter o crescimento da norma dos estados ocultos entre camadas, relatando loss de um modelo Pre-Norm de 1,3B com 3,4x menos compute e escala estável até 512 camadas.
- há 18 dias alphaxiv.org
H-JEPA: modelos de mundo hierárquicos para planejamento visual de longo prazo
O artigo, orientado por Yann LeCun, propõe o H-JEPA, com modelos de mundo JEPA empilhados em múltiplas escalas de tempo. O autor relata subida de 18% para 73% no Visual AntMaze com essa abordagem hierárquica.
- há 18 dias manning.com
GRPO com recompensas verificáveis: como testar o método
Publicado em 31 de janeiro de 2026, um capítulo de Build a Reasoning Model (From Scratch) apresenta GRPO do zero para aprendizado por reforço com recompensas verificáveis.
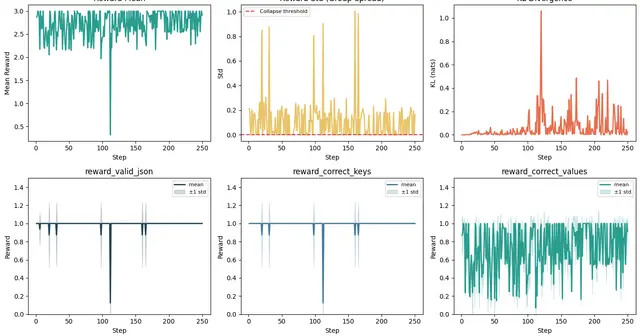
GRPO para extrair recibos em JSON com OCR
Artigo publicado em 4 de maio de 2026 apresenta um fluxo de fine-tuning com GRPO para extrair dados de recibos por OCR e estruturá-los em JSON.
- há 18 dias turingpost.com
LeJEPA combina predição latente e regularização
Publicado em 22 de novembro de 2025, o post descreve o LeJEPA, que combina a perda de predição em espaço latente do JEPA com o SIGReg para moldar embeddings em uma distribuição gaussiana isotrópica.
- há 18 dias huggingface.co
RoPE e decisões de arquitetura de modelos
Publicação de 12 de abril de 2026 apresenta um artigo como explicação de rotary positional embeddings (RoPE), voltada a engenheiros que estudam codificação posicional.
- há 18 dias deeplearning.ai
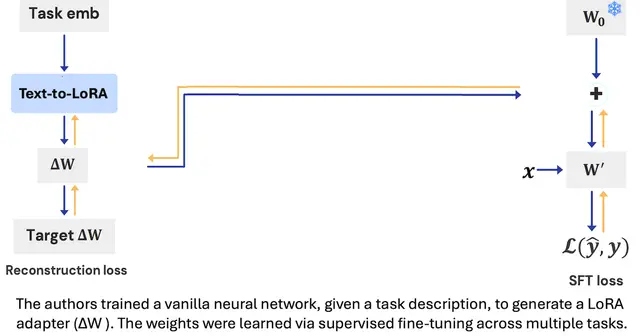
Text-to-LoRA gera adapters a partir de descrições
Publicado em 21 de outubro de 2025, o estudo da Sakana AI apresenta um método que gera adapters LoRA para tarefas a partir de descrições em linguagem natural e avalia seus resultados em 479 tarefas.
- há 18 dias
 unsloth.ai
Unsloth: ajuste fino de modelos de embeddings
Em 22 de janeiro de 2026, a documentação da Unsloth apresentou um guia de fine-tuning de modelos de embeddings, com um notebook Colab para um modelo de 300 milhões de parâmetros.
- há 18 dias turingpost.com
Variantes de LoRA: como comparar estratégias de ajuste eficiente
Publicado em 26 de abril de 2026, o artigo da Turing Post apresenta mais de 15 variantes de LoRA, como QLoRA, DoRA e Mixture-of-LoRA-Experts, e acompanha a evolução do ajuste eficiente em parâmetros para grandes modelos de linguagem.
Detecção de elementos do basquete com visão computacional
Uma publicação de 24 de setembro de 2025 descreve o ajuste fino de um modelo de detecção para identificar jogadores, números, árbitros, bola e aro em partidas de basquete.
Post-training de LLMs: métodos e avaliação
Guia publicado em 12 de outubro de 2025 sobre adaptação de LLMs: de previsão de tokens a seguimento de instruções, com métodos de treino e avaliação.
Classificação de documentos em larga escala com poucos exemplos
Post publicado em 10 de setembro de 2026 descreve um fluxo que rotulou 200 exemplos com um agente e classificou 191.724 documentos por cerca de US$ 0,70 em computação de inferência.
- há 19 dias aleph-alpha.com
Como testar a escala de treinamento antes de ampliar GPUs
Em relatório publicado em 5 de outubro de 2026, a Aleph Alpha descreve a escala de um modelo MoE de 30B-A3B, de 16 para 512 GPUs B200, com escalabilidade quase linear e MFU de 35,3%.
- há 19 dias books.vizuara.ai
O que o pré-treinamento de um modelo MoE exige na prática
Publicado em 20 de agosto de 2026, o relato documenta uma tentativa de pré-treinar um modelo MoE de 1,02 bilhão de parâmetros em uma H200, incluindo pipeline de dados, falhas e ajustes de throughput.
- há 19 dias posttrainbench.com
PostTrainBench destaca desempenho e confiabilidade de modelo
Em 25 de junho de 2026, um post sobre o PostTrainBench informou pontuações próximas no ranking e zero execuções com falha em 84 tentativas para o GLM 5.2.
- há 19 dias alphaxiv.org
Projection Sampling adapta demonstrações para SFT
Paper publicado em 4 de outubro de 2026 apresenta uma forma de reescrever demonstrações de especialistas como trajetórias corretas e mais prováveis sob o modelo-alvo, para uso em supervised fine-tuning padrão.
- há 19 dias doi.org
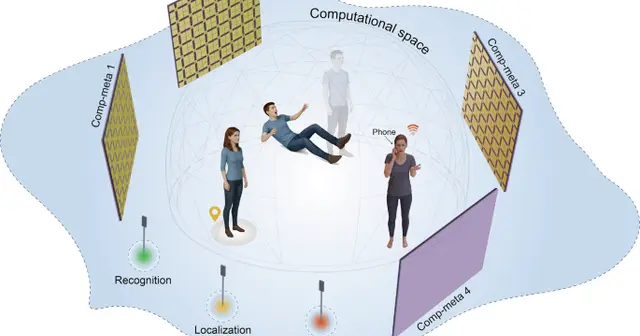
Rede neural física de metasuperfícies treinada sem modelos digitais
Artigo da Nature Communications descreve uma rede neural física com quatro metasuperfícies programáveis, que aprende por interações eletromagnéticas para focalizar ondas, reconhecer objetos e localizar alvos, sem modelos digitais.
- há 19 dias zhihu.com
RL de longo horizonte pode favorecer PPO
Post no Zhihu, publicado em 24 de junho de 2026, argumenta que rollouts agentic longos e ruidosos podem dificultar a atribuição de crédito no GRPO e tornar útil o modelo de valor do PPO.
RL para comportamentos benéficos em vários domínios
Em post publicado em 18 de junho de 2026, a OpenAI relata que treinamento por reforço focado em comportamento melhorou o alinhamento em diferentes domínios e resistiu à pressão adversarial.
- há 19 dias alphaxiv.org
Self-play para pré-treinar modelos sem dados naturais
Paper publicado em 26 de setembro de 2026 investiga pré-treinamento com sequências de bytes geradas por programas e relata transferência para modalidades e tarefas não vistas.
 tokens-for-thoughts.notion.site
Vamos avaliar seu projeto

Respondo com escopo e proposta.