


Notícias de IA e infraestrutura
Filtrar por tipo: Todos85
- há 17 dias github.com
NVIDIA Model Optimizer reúne técnicas de compressão de modelos para inferência
A NVIDIA publicou um post sobre o Model Optimizer, biblioteca com quantização, destilação, pruning, neural architecture search e speculative decoding, com checkpoints exportáveis para vLLM, SGLang, TensorRT-LLM e TensorRT.
- há 17 dias x.com
Inferência concorrente de Llama 3.1 8B em uma RTX 3090
Post da Backprop, publicado em 16 de agosto de 2024, relata desempenho razoável em um benchmark com mais de 100 requisições simultâneas em uma única GPU.
- há 17 dias x.com
Inferência por camadas em GPUs com memória limitada
Em 25 de setembro de 2024, a publicação do AirLLM descreveu inferência que carrega uma camada do Transformer por vez a partir do disco, além de quantização em blocos e suporte à compressão.
- há 17 dias
 arxiv.org
InfLLM-V2 alterna atenção densa e esparsa
Publicado em 13 de outubro de 2025, o artigo apresenta um sistema de atenção alternável entre densa e esparsa, voltado a sequências curtas e longas.
- há 17 dias x.com
Jamba 1.5: contexto de 256 mil tokens e avaliação de inferência
Em 22 de agosto de 2024, a AI21 Labs anunciou os modelos Jamba 1.5 Mini e Large, com arquitetura que combina Mamba e Joint Attention, contexto de 256 mil tokens e recursos como ExpertInt8 e saída JSON.
- há 17 dias github.com
LLM Compressor reúne técnicas para comprimir modelos usados com vLLM
Em post publicado em 16 de agosto de 2024, a Neural Magic apresentou uma biblioteca com técnicas de compressão que buscam reduzir a latência de inferência mantendo a precisão.
- há 17 dias github.com
Mirage compila LLMs em megakernels persistentes
Publicada em 19 de junho de 2025, a publicação descreve um compilador que transforma LLMs em megakernels persistentes e afirma reduzir a latência em 1,2 a 6,7 vezes.
- há 17 dias cnx-software.com
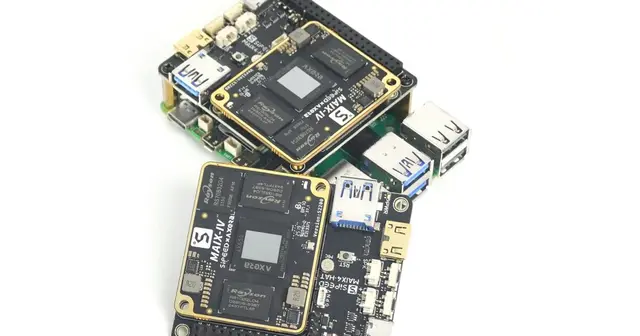
NPU de até 72 TOPS no Raspberry Pi 5
Em publicação de 11 de agosto de 2025, a Sipeed apresentou o Maix4-HAT, com NPU AXera AX650N, até 72 TOPS em INT4 ou 18 TOPS em INT8 e 8 GB de RAM LPDDR4x, para inferência de Transformers na edge.
- há 17 dias x.com
PHLoRA extrai adapters LoRA de modelos ajustados
Publicado em 17 de setembro de 2025, o post descreve um método que extrai adapters de baixo rank de checkpoints ajustados, sem dados de treinamento ou gradientes.
- há 17 dias arxiv.org
Router-R1 explora roteamento de LLMs com aprendizado por reforço
Publicado em 18 de outubro de 2025, o texto apresenta o Router-R1, que alterna entre raciocínio e chamadas a vários modelos e relata avaliações em sete benchmarks de perguntas e respostas.
- há 17 dias x.com
Throughput de inferência: SGLang e vLLM em GPUs A6000
Um post publicado em 4 de agosto de 2024 relata throughput maior com SGLang do que com vLLM em quatro GPUs A6000, mas desempenho semelhante em batches menores.
- há 17 dias pytorch.org
Torchchat leva inferência local de LLMs a diferentes dispositivos
Publicado em 30 de julho de 2024, o post apresenta uma biblioteca PyTorch para executar modelos Llama 3, 3.1 e outros LLMs localmente em laptops, desktops e dispositivos móveis.
- há 18 dias x.com
BITCOS reduz o armazenamento de LLMs ternários
Em post publicado em 20 de setembro de 2026, a Intel descreve o BITCOS, método que armazena pesos exatos de LLMs ternários a 1,485 bits por peso e relata ganhos de throughput de decode.
- há 18 dias youtube.com
Cache e atenção: otimização de inferência
Post datado de 1º de outubro de 2026 relata técnicas de atenção e redução de KV cache em um modelo de linguagem, com possíveis implicações para custos de inferência.
- há 18 dias arxiv.org
Camadas de treinamento em tempo de teste para sequências
Artigo publicado em 24 de setembro de 2026 apresenta camadas de modelagem de sequências com complexidade linear e estados ocultos atualizados por aprendizado autossupervisionado.
- há 18 dias github.com
Colibri transmite experts de MoE do disco para inferência local
Um engine de inferência escrito em C puro carrega experts de modelos MoE a partir do disco, uma abordagem para avaliar execução local em hardware com memória limitada.
- há 18 dias x.com
Como avaliar reduções no uso de KV cache
Um post relata uma redução alegada do KV cache de 389.000 para 890 bytes por token em três anos. A afirmação destaca uma oportunidade para medir memória e custo em sistemas com contexto longo.
- há 18 dias x.com
Como o vLLM agenda requisições e aloca o KV cache
Artigo de 26 de setembro de 2026 acompanha o caminho de uma requisição no vLLM e explica o agendamento por iteração e a alocação de blocos de KV cache.
- há 18 dias github.com
Como reproduzir serving multi-GPU e perfil térmico
Um repositório no GitHub, publicado em 30 de julho de 2026, apresenta uma configuração reproduzível de serving do GLM-5.2 EXL3 MTP3 e um perfil térmico para quatro GPUs RTX PRO 6000 Blackwell.
- há 18 dias github.com
Comunicação de modelos em NPUs Huawei Ascend
A publicação, datada de 30 de setembro de 2026, apresenta uma biblioteca de comunicação de alto desempenho para treinamento e inferência de machine learning em NPUs Huawei Ascend.
- há 18 dias github.com
Configuração de inferência em dois DGX Sparks
Um pull request datado de 31 de julho de 2026 atualiza o checkpoint padrão e instala o encoder nos dois ranks de uma configuração com dois DGX Sparks.
- há 18 dias crusoe.ai
Crusoe reporta inferência em 512 GPUs AMD MI355X
Em publicação de 16 de setembro de 2026, a Crusoe relata resultados do MLPerf Inference v6.1: 5,75 milhões de tokens por segundo em gpt-oss-120b e escalabilidade linear sem InfiniBand.
- há 18 dias arxiv.org
Dual-Cache: compartilhamento de contexto entre LLMs
Paper publicado em 26 de setembro de 2026 apresenta um protocolo latente para transferir informações entre modelos heterogêneos, convertendo o KV cache e adicionando mistura conjunta entre camadas.
- há 18 dias github.com
Falhas silenciosas no serving de LLMs: como diagnosticar
Publicado em 28 de julho de 2026, o repositório do GitHub cataloga falhas de serving de LLMs, seus sintomas, mecanismos, verificações e correções.
- há 18 dias platform.claude.com
Hooks de inferência permitem bloquear prompts antes da execução
Material datado de 11 de agosto de 2026 descreve hooks que enviam prompts a um servidor de segurança da organização, onde são permitidos ou negados antes da inferência.
- há 18 dias github.com
Inferência de LLMs com VRAM limitada
Post de 17 de julho de 2026 descreve um framework para inferência e fine-tuning heterogêneos, distribuindo experts entre GPU e CPU.
- há 18 dias arxiv.org
JetSpec acelera speculative decoding com draft trees paralelas
Post publicado em 7 de julho de 2026 descreve o JetSpec, que usa um único forward pass para gerar draft trees coerentes e relata ganhos de até 9,64× no MATH-500 e 4,58× em conversas abertas.
- há 18 dias aclanthology.org
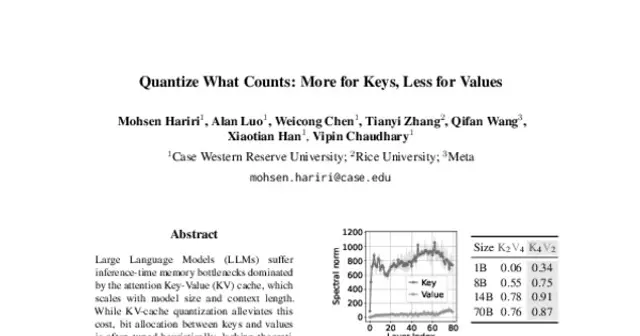
KV cache: mais bits para keys que para values
Artigo da ACL 2026 examina a compressão do KV cache e relata que usar 4 bits para keys e 2 para values pode funcionar bem, enquanto inverter essa distribuição degrada bastante a precisão.
- há 18 dias x.com
KV Cache: por que queries não ficam armazenadas
Post de 30 de agosto de 2026 distingue o uso temporário de queries do armazenamento de keys e values no KV cache durante a inferência.
- há 18 dias github.com
Livro aberto reúne 12 capítulos sobre infraestrutura de IA
Publicado em 13 de setembro de 2026, o livro percorre arquiteturas de modelos, aceleradores, inferência e treinamento. Sua abrangência ajuda empresas a identificar desafios concretos de infraestrutura.
- há 18 dias arxiv.org
PagedAttention e a gestão do KV cache em LLM serving
Artigo publicado em 24 de setembro de 2026 apresenta o PagedAttention, uma abordagem inspirada em memória virtual para reduzir fragmentação e duplicação do KV cache, fatores que podem limitar o tamanho do batch.
- há 18 dias x.com
Post descreve compressão low-bit do Hy4 guiada por calibração
Post publicado em 29 de agosto de 2026 afirma que a Tencent reduziu o preview do Hy4 de 1,5 TB para 200 GB com precisão definida por camada. Relata resultados em dois benchmarks.
- há 18 dias dstack.ai
Presets da dstack propõem otimização portátil de inferência
Publicado em 20 de agosto de 2026, o anúncio da dstack apresenta um toolkit open source que usa agentes para simplificar a otimização de inferência e guardar resultados em formato portátil.
- há 18 dias x.com
Quantização de 1 bit reduz modelo a 217 GB, relata Unsloth
Em post publicado em 28 de agosto de 2026, a Unsloth relata quantização dinâmica de 1 bit do GLM-5.3: 217 GB, ante 1,5 TB em BF16, e cerca de 76% de acurácia top-1.
- há 18 dias huggingface.co
Quantização reduz Hy4 Preview para 214 GB
Publicação da Tencent, de 1º de setembro de 2026, afirma que a quantização Sherry leva o Hy4 Preview de 1,5 TB para 214 GB e descreve sua execução em GPUs distribuídas por várias máquinas.
- há 18 dias github.com
Ridgeline: perfilando inferência de LLMs com o modelo roofline
Publicado em 8 de julho de 2026, o texto descreve o Ridgeline, um profiler baseado em PyTorch que aplica o modelo roofline à análise de workloads de inferência de LLMs.
- há 18 dias arxiv.org
Serving de LLM: cache e balanceamento após um ano em produção
Paper publicado em 21 de agosto de 2026 analisa um ano de tráfego de LLM em produção e examina reutilização de prefixos, localidade do cache KV e balanceamento de carga.
- há 18 dias x.com
Servir modelos entre GPU, RAM e NVMe
Post de 12 de setembro de 2026 relata a execução de um modelo em uma RTX 5090 com 125,7 GiB de RAM e parte dos pesos em NVMe.
- há 18 dias arxiv.org
Speculative decoding pode reduzir etapas na inferência
Um artigo datado de 20 de setembro de 2026 descreve uma técnica que combina propostas de um modelo eficiente com verificação paralela por um modelo maior para acelerar a geração sem alterar a distribuição de saída.
- há 18 dias github.com
Strata leva inferência local de MoE a GPUs com 8 GB
Em 1º de outubro de 2026, a página do repositório Strata descreveu a execução do modelo MoE Qwen3.8-Flash-Next, de 125 bilhões de parâmetros, em GPUs NVIDIA com pelo menos 8 GB de VRAM.
Vamos avaliar seu projeto

Respondo com escopo e proposta.