


Notícias de IA e infraestrutura
Filtrar por tipo: Artigo16
- há 12 dias storagereview.com
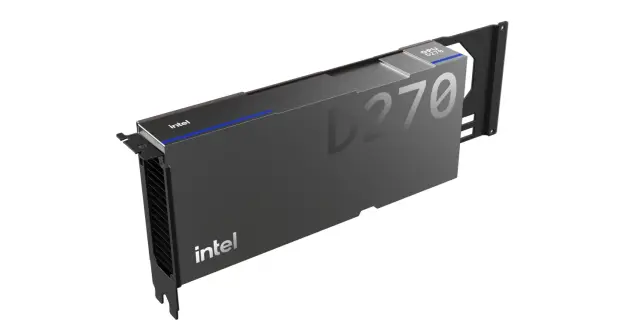
Intel GPU D-Series: placa de inferência com até 480GB LPDDR5X em amostragem
A Intel apresentou a GPU D-Series, com até 480GB de LPDDR5X, 1,5TB/s e 1,3 PFLOPS em FP8 numa placa PCIe de 350W já em amostragem. Veja o que isso muda para inferência privada e custo por token.
- há 17 dias andrewkchan.dev
Como avaliar e otimizar inferência de LLM na empresa
Artigo de Andrew Chan, publicado em 1º de março de 2026, aborda inferência rápida de LLM do zero como ponto de partida prático para engenheiros.
- há 17 dias turingpost.com
Como comparar ferramentas para executar modelos fundacionais
Artigo da Turing Post, publicado em 17 de maio de 2026, apresenta 13 ferramentas open source para deployment, serving e execução de modelos, de uso local à inferência de produção.
- há 17 dias lmsys.org
Como otimizar a latência do Qwen3 em GPUs AMD
Artigo do blog da LMSYS, publicado em 13 de fevereiro de 2026, aborda a otimização da latência do Qwen3 e do Qwen3-VL em GPUs AMD MI300X.
- há 17 dias openanonymity.ai
Inference não vinculável para proteger a identidade de usuários
Em post publicado em 26 de fevereiro de 2026, a OpenAnonymity descreve uma camada para impedir que provedores de IA associem chamadas de inference a usuários individuais.
- há 17 dias baseten.co
Inferência de IA em produção exige engenharia de ponta a ponta
Publicado em 3 de março de 2026, o livro de Philip Kiely aborda hardware, software, técnicas e infraestrutura para sistemas de inferência em produção, com foco principal em modelos de linguagem e algum conteúdo sobre diffusion.
- há 17 dias outcomeschool.com
KV cache: menos recálculo na inferência de LLMs
Publicado em 9 de maio de 2026, o artigo explica como o KV cache reutiliza valores já calculados e por que isso importa para memória e computação na inferência.
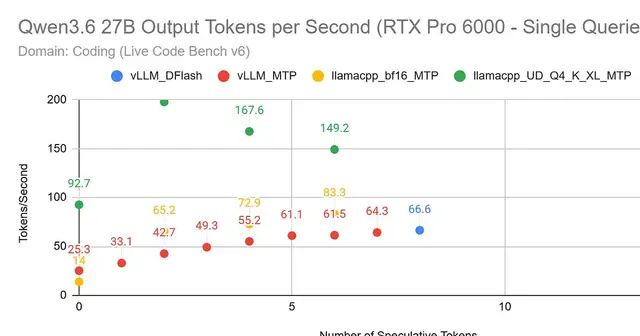
Speculative decoding: desempenho varia por modelo
Artigo publicado em 3 de junho de 2026 compara DFlash e MTP com vLLM e llama.cpp em matemática, programação e chat. Os resultados variam conforme o modelo e a carga de trabalho.
- há 17 dias huggingface.co
Técnicas para otimizar inferência de Transformers
Um post publicado em 24 de dezembro de 2025 descreve técnicas de inferência de Transformers: quantização MXFP4, paralelismo de tensores e especialistas e janelas deslizantes dinâmicas.
- há 17 dias lightseek.org
TokenSpeed destaca otimizações de inferência para agentes
Publicado em 24 de maio de 2026, o texto descreve um engine de inferência para workloads agentic, com paralelismo apoiado por compiler, scheduler de alto desempenho, reutilização restrita de recursos KV e kernels plugáveis para aceleradores heterogêneos.
- há 17 dias
 unsloth.ai
Tool calling com modelos locais: do guia à aplicação
Publicado em 5 de fevereiro de 2026, o guia da Unsloth apresenta exemplos de chamadas a ferramentas com modelos abertos locais, incluindo Python, terminal e matemática.
- há 17 dias cnx-software.com
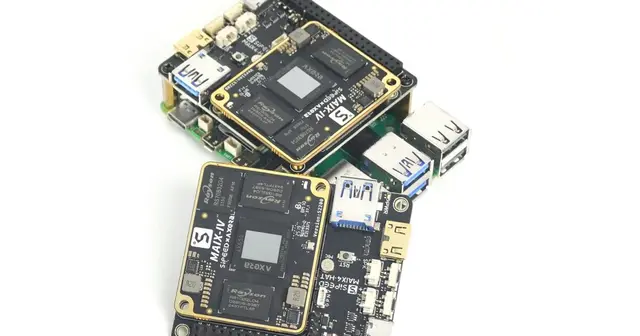
NPU de até 72 TOPS no Raspberry Pi 5
Em publicação de 11 de agosto de 2025, a Sipeed apresentou o Maix4-HAT, com NPU AXera AX650N, até 72 TOPS em INT4 ou 18 TOPS em INT8 e 8 GB de RAM LPDDR4x, para inferência de Transformers na edge.
- há 17 dias pytorch.org
Torchchat leva inferência local de LLMs a diferentes dispositivos
Publicado em 30 de julho de 2024, o post apresenta uma biblioteca PyTorch para executar modelos Llama 3, 3.1 e outros LLMs localmente em laptops, desktops e dispositivos móveis.
- há 18 dias crusoe.ai
Crusoe reporta inferência em 512 GPUs AMD MI355X
Em publicação de 16 de setembro de 2026, a Crusoe relata resultados do MLPerf Inference v6.1: 5,75 milhões de tokens por segundo em gpt-oss-120b e escalabilidade linear sem InfiniBand.
- há 18 dias platform.claude.com
Hooks de inferência permitem bloquear prompts antes da execução
Material datado de 11 de agosto de 2026 descreve hooks que enviam prompts a um servidor de segurança da organização, onde são permitidos ou negados antes da inferência.
- há 18 dias dstack.ai
Presets da dstack propõem otimização portátil de inferência
Publicado em 20 de agosto de 2026, o anúncio da dstack apresenta um toolkit open source que usa agentes para simplificar a otimização de inferência e guardar resultados em formato portátil.
Vamos avaliar seu projeto

Respondo com escopo e proposta.