


Notícias de IA e infraestrutura
Filtrar por tipo: Todos83
- há 12 dias
 arxiv.org
QwenGyre: RL elástico para treinar agentes de horizonte longo
A Alibaba Qwen apresentou o QwenGyre, um framework de RL elástico que realoca GPUs entre rollout e treinamento e agrupa execuções ramificadas de agentes em árvores de trajetórias com prefixos compartilhados, com speedup relatado de até 1,85× sobre Colocate.
- há 17 dias arxiv.org
Adaptação de modelos à linguagem Q, usada em finanças
Relatório técnico de 9 de janeiro de 2026 apresenta uma abordagem open source para adaptar modelos de linguagem à Q, uma linguagem de programação especializada em finanças quantitativas.
- há 17 dias arxiv.org
Agentes de busca podem verificar evidências contra ruído
Publicado em 28 de outubro de 2025, o paper descreve um agente que define objetivos de busca e verifica se as evidências encontradas os atendem, buscando resistir a pistas enganosas.
- há 17 dias x.com
Ajuste de modelo de código de 14B com SFT e DPO
Artigo de 20 de janeiro de 2026 descreve o ajuste de um modelo de 14B com conversas sobre código e relata números, custos e dificuldades.
- há 17 dias x.com
Arquitetura também influencia o aprendizado contínuo
Artigo publicado em 17 de janeiro de 2026 relata que redes mais largas e menos global average pooling podem favorecer a retenção, enquanto ResNets e WideResNets aprendem novas tarefas rapidamente, mas esquecem mais.
- há 17 dias arxiv.org
Auto-destilação pode apoiar aprendizado contínuo sem recompensa
Um post publicado em 16 de fevereiro de 2026 descreve uma técnica de auto-destilação para treinar modelos em novas tarefas sem função de recompensa e com foco em reduzir o esquecimento catastrófico.
- há 17 dias arxiv.org
BAPO busca estabilizar o treinamento off-policy de LLMs
Publicado em 23 de outubro de 2025, o paper apresenta o BAPO, método com otimização balanceada da política e clipping adaptativo para cenários de partial rollout e reaproveitamento de experiências.
- há 17 dias arxiv.org
CogRouter ajusta o raciocínio de agentes por etapa
Publicado em 16 de fevereiro de 2026, o material descreve quatro níveis cognitivos para agentes com LLMs e relata 82,3% de sucesso em benchmarks para um modelo de 7B.
- há 17 dias arxiv.org
Como estabilizar o reinforcement learning com LLMs
Artigo da equipe Qwen, publicado em 16 de dezembro de 2025, aborda instabilidades no reinforcement learning com modelos de linguagem e destaca diferenças entre treinamento e inferência, políticas antigas e novas, importance sampling e routing replay.
- há 17 dias x.com
Como medir escala e custo em experimentos de RL
Post de 18 de abril de 2026 compara leis de escala de pré-treinamento e aprendizado por reforço, destacando custos de amostragem e atualização da política e desafios de avaliação.
- há 17 dias x.com
Distilação progressiva para aprimorar VLMs
Em post publicado em 4 de janeiro de 2026, o autor descreve o framework Masters e relata ganhos em dois modelos de visão e linguagem, com uma abordagem que busca evitar o custo computacional de RL online.
- há 17 dias arxiv.org
EditScore aplica reward models à edição de imagens
Post de 25 de outubro de 2025 apresenta uma família de modelos de recompensa para avaliar e orientar edições complexas de imagens, com resultados reportados no EditReward-Bench.
- há 17 dias blog.ml.cmu.edu
Exploração em RL para treinar LLMs em tarefas difíceis
Post da CMU, publicado em 31 de janeiro de 2026, descreve três regimes de exploração e riscos de estagnação e interferência no treinamento por reinforcement learning.
- há 17 dias
 unsloth.ai
GRPO com contexto de 380K em uma GPU de 192 GB
Em 15 de janeiro de 2026, a documentação da Unsloth descreveu fine-tuning com GRPO e contexto longo, afirmando que seus algoritmos de batching permitem contexto de 380K para gpt-oss em uma GPU de 192 GB.
- há 17 dias x.com
IA pode descobrir algoritmos de reinforcement learning
Artigo publicado na Nature em 28 de outubro de 2025 relata a descoberta autônoma de algoritmos de reinforcement learning e aponta uma possível nova abordagem para engenheiros.
- há 17 dias arxiv.org
JustRL testa RL simples em modelos de raciocínio de 1,5B
Publicado em 4 de janeiro de 2026, o paper descreve treinamento em etapa única, com hiperparâmetros fixos, e relata acurácias médias de 54,9% e 64,3% em dois modelos de raciocínio de 1,5B.
- há 17 dias x.com
LaSeR explora recompensas pelo último token em LLMs
Em post publicado em 19 de outubro de 2025, a Tencent apresenta o LaSeR, algoritmo de reinforcement learning que alinha scores do último token a recompensas reais e usa uma inferência adicional de token.
- há 17 dias alphaxiv.org
LoRA para RLVR: média de especialistas supera gate nos testes
Em 3 de janeiro de 2026, um trabalho sobre estratégias práticas de PEFT para RLVR em múltiplos domínios relatou interferência no treinamento conjunto. Nos experimentos descritos, a média dos pesos de LoRAs especialistas, seguida de treinamento contínuo, superou o método de gating testado.
- há 17 dias x.com
MaxRL propõe outra forma de treinar RL com recompensa binária
Publicado em 9 de fevereiro de 2026, o post descreve o MaxRL e relata até 20 vezes mais eficiência em tempo de teste que o GRPO.
- há 17 dias nature.com
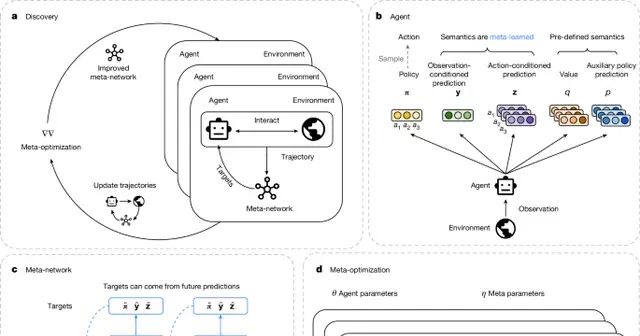
Meta-learning propõe regras de atualização para reinforcement learning
Publicado em 24 de outubro de 2025, o artigo apresenta o DiscoRL, método que aprende regras de atualização de reinforcement learning entre agentes e ambientes e relata resultados de ponta em benchmarks como Atari e ProcGen.
- há 17 dias aweers.de
Métodos de RL para modelos de raciocínio
Artigo publicado em 16 de março de 2026 reúne métodos de aprendizado por reforço usados com modelos de linguagem, oferecendo uma base para comparação por equipes de engenharia.
- há 17 dias x.com
Modelos em loop: escala e avaliação prática
Artigo de 30 de outubro de 2025 relata treinamento de modelos de linguagem em loop com 2,6 bilhões de parâmetros e mais de 7 trilhões de tokens, com desempenho comparável ao de modelos duas a três vezes maiores.
- há 17 dias x.com
O pipeline do Olmo 3 e o treinamento de modelos de raciocínio
Post publicado em 15 de dezembro de 2025 descreve SFT com traces curados, seguido de DPO e RLVR com otimização de política relativa em grupo.
- há 17 dias github.com
OpenTinker propõe infraestrutura de RL para modelos fundacionais
Descrição publicada em 8 de janeiro de 2026 apresenta uma plataforma open source de reinforcement learning para agentes, com separação entre programação e execução e transição do treinamento para a inferência.
- há 17 dias x.com
Prompts longos: processamento recursivo com código
Post do MIT, publicado em 6 de janeiro de 2026, descreve modelos que usam uma interface Python para filtrar e processar recursivamente trechos de prompts longos.
- há 17 dias arxiv.org
Regularização KL em RL pode não seguir a intuição sobre diversidade
Publicado em 24 de outubro de 2025, o artigo analisa regularização por reverse KL e forward KL em reinforcement learning e mostra que a distinção usual entre buscar modos e cobrir massa não necessariamente se aplica.
- há 17 dias x.com
Ring-1T: treinamento em três fases para MoE de 1 trilhão de parâmetros
Post publicado em 22 de outubro de 2025 descreve o Ring-1T, modelo MoE de raciocínio com 1 trilhão de parâmetros e cerca de 50 bilhões ativos por token, treinado em três fases.
RL em sistemas de treinamento: desafios e resultados de pass@k
Artigo publicado em 21 de dezembro de 2025 reúne desafios de rollouts em treinamento por RL e resultados variados sobre desempenho pass@k.
- há 17 dias arxiv.org
RL multimodal: estabilidade com rollout único
Publicação de 23 de dezembro de 2025 relata que advantage shaping com bônus de entropia estabilizou uma abordagem de rollout único para RL multimodal.
- há 17 dias x.com
RL offline: generalização bayesiana em modelos
Post de 14 de janeiro de 2026 sobre um artigo que explora generalização bayesiana adaptativa em RL offline baseado em modelos, usando rollouts de longo horizonte para reduzir restrições conservadoras.
- há 17 dias
 hgpu.org
RL online para geração de código HPC com benchmarks reais
Artigo publicado em 15 de fevereiro de 2026 descreve o uso de aprendizado por reforço online, recompensado por benchmarks em máquinas reais, para melhorar a geração de código HPC. O desempenho em execução do código gerado não é garantido.
- há 17 dias x.com
RLAC propõe crítico adversarial para geração livre
Em post publicado em 5 de novembro de 2025, a abordagem RLAC relata mais factualidade e melhores pontuações em código, com menos chamadas de validação e menos dados e casos de teste.
RLHF em GPUs AMD: implantação com ROCm 7.0
Artigo da AMD, publicado em 2 de março de 2026, descreve o uso de verl para treinamento de RLHF em GPUs AMD, com otimizações para ROCm e scripts Docker, e apresenta resultados de throughput e convergência.
- há 17 dias x.com
RLoop alterna exploração e consolidação no RL
Post de 7 de novembro de 2025 descreve uma estratégia de inicialização iterativa de políticas, com ganhos em duas métricas de avaliação.
- há 17 dias arxiv.org
SA-RAG explora ativação em grafos para recuperar evidências
Publicado em 20 de dezembro de 2025, o paper apresenta o SA-RAG, que propaga ativação por conexões ponderadas em grafos de conhecimento para recuperar documentos ligados a entidades relevantes.
- há 17 dias arxiv.org
SAR como sinal de recompensa para LLMs
Publicação de 16 de janeiro de 2026 apresenta o Self-Aligned Reward, compatível com PPO e GRPO, para buscar melhor raciocínio com menos tokens.
- há 17 dias x.com
Self-play para treinar agentes de código com bugs reais
Uma publicação de 26 de dezembro de 2025 descreve o Self-play SWE-RL, método que treina um agente para inserir e corrigir bugs em repositórios reais sem issues rotuladas por pessoas nem descrições dos problemas em linguagem natural.
- há 17 dias x.com
SETA lança 400 ambientes de RL para agentes de terminal
Em 9 de janeiro de 2026, a SETA anunciou ambientes de treinamento, um pipeline de RL e pesos de modelo para experimentos com agentes de terminal.
- há 17 dias arxiv.org
SFT ou ajuste por reforço no pós-treinamento contínuo?
Artigo publicado em 11 de janeiro de 2026 compara SFT e ajuste fino por reforço no pós-treinamento contínuo de modelos fundacionais. Seu título afirma que o ajuste por reforço mitiga naturalmente o esquecimento.
- há 17 dias github.com
slime v0.2.2 amplia suporte a Int4-QAT e R3
Publicado em 18 de janeiro de 2026, o anúncio da versão slime v0.2.2 destaca melhorias de memória e desempenho, treinamento Int4-QAT e suporte a R3 com DeepEP e MTP.
Vamos avaliar seu projeto

Respondo com escopo e proposta.