


Notícias de IA e infraestrutura
Filtrar por tipo: Todos83
- há 18 dias arxiv.org
Socratic-Zero gera currículos de raciocínio com agentes
Publicado em 28 de outubro de 2025, o paper apresenta um método de geração de dados de raciocínio sem rótulos humanos e relata resultados em sete benchmarks matemáticos.
Trajetórias de especialistas no treinamento de modelos de linguagem
Em 31 de outubro de 2025, uma publicação apresentou um método que usa trajetórias de especialistas para ensinar modelos de linguagem pequenos a raciocinar sobre problemas difíceis.
Treinamento com RL: riscos de dados e infraestrutura
Publicada em 5 de novembro de 2025, a publicação aponta que feedback ruidoso e uma infraestrutura complexa podem tornar o treinamento com RL instável.
SmolDataEnvs: coleção aberta de 5.000 tarefas verificáveis para RL em modelos pequenos
A coleção open source SmolDataEnvs reúne 5.000 tarefas verificáveis de ambientes de reinforcement learning voltadas a programação e ciência de dados, com avaliações e rotinas de treinamento incluídas.
- há 18 dias github.com
SkyRL tx v0.0.2 habilita treinamento multi-LoRA
Em 14 de outubro de 2025, a atualização v0.0.2 do backend aberto SkyRL tx passou a permitir treinar modelos multi-LoRA pela API Tinker.
- há 19 dias x.com
Agentes de terminal treinados em ambientes RL Dockerizados
Post publicado em 24 de junho de 2026 descreve 14,6 mil ambientes Dockerizados de aprendizado por reforço e uma receita DPPO baseada apenas em resultados. Um modelo 9B alcançou 27% no Terminal-Bench 2.0.
- há 19 dias github.com
Ambientes de RL e código para treinar modelos de linguagem
Em 26 de setembro de 2026, a Xiaomi MiMo publicou ambientes de aprendizado por reforço, código de treinamento e um conjunto de dados para experimentos com modelos de linguagem.
- há 19 dias github.com
Amostragem de replay buffer com SQL
Post publicado em 16 de agosto de 2026 descreve amostragem ponderada top-k em SQL e relata selecionar 8.192 linhas entre 50 milhões em cerca de 1,1 segundo em um laptop.
- há 19 dias x.com
AutoDecompiler aplica RL à decompilação iterativa
Post de 25 de junho de 2026 descreve um modelo que usa aprendizado por reforço e feedback direto em várias etapas para decompilar código.
- há 19 dias x.com
CodeMidas cria tarefas de treinamento de RL a partir de código
Em um post datado de 21 de setembro de 2026, a Xiaomi descreve o CodeMidas, que usa agentes para gerar 5.545 tarefas executáveis em 23 linguagens a partir de bases de código open source.
- há 19 dias
 arxiv.org
CodeMidas propõe gerar tarefas de RL a partir de código
Em 21 de setembro de 2026, a CodeMidas apresentou um pipeline que converte funcionalidades de projetos open source em ambientes executáveis de aprendizado por reforço para programação.
- há 19 dias arxiv.org
Como avaliar RL assíncrono no pós-treinamento de agentes
Um post publicado em 9 de julho de 2026 aborda RL assíncrono para pós-treinamento de modelos de linguagem, atualizações conforme chegam rollouts e técnicas de estabilidade.
- há 19 dias arxivb.org
Como direcionar o compute de RL para problemas difíceis
Artigo publicado em 18 de setembro de 2026 relata que o método adaptativo Never Give Up amostra até obter sucesso para direcionar compute de treinamento por reforço a problemas mais difíceis em LLMs.
Como explorar ambientes de reforço e executar rollouts
Um Space interativo, publicado em 29 de setembro de 2026, permite inspecionar ambientes de aprendizado por reforço e executar rollouts. A abordagem pode inspirar ferramentas internas de avaliação e teste.
- há 19 dias x.com
Como medir ganhos de RL em tarefas de engenharia de software
Um post datado de 21 de setembro de 2026 relata que a pontuação do MiMo Pro no benchmark DeepSWE passou de 58,41 para 72,57 após execuções de aprendizado por reforço.
- há 19 dias x.com
Como o RL pode ampliar habilidades aprendidas por SFT
Post de 11 de julho de 2026 apresenta a hipótese de que o RL pode separar componentes úteis do SFT em habilidades reutilizáveis e regras de roteamento.
- há 19 dias arxiv.org
Distilação em duas fases para modelos multitarefa
Paper de 30 de junho de 2026 estuda como consolidar especialistas de aprendizado por reforço em um modelo multitarefa usando distilação off-policy e on-policy.
- há 19 dias x.com
Distilação on-policy para combinar modelos especialistas
A técnica MOPD treina um modelo student com suas próprias respostas e usa probabilidades por token de vários teachers para transferir capacidades especializadas.
- há 19 dias arxiv.org
DreamSmooth suaviza recompensas esparsas em RL
Apresentado em um paper da ICLR publicado em 28 de junho de 2026, o DreamSmooth aplica suavização temporal às recompensas em model-based RL e foi avaliado em RoboDesk e Shadow Hand.
- há 19 dias arxiv.org
EfficientRollout acelera rollouts de RL para LLMs
Paper de 5 de julho de 2026 descreve speculative decoding autoespeculativo com adaptação ao sistema e relata até 19,6% mais rapidez na geração de rollouts.
- há 19 dias github.com
FrontierSmith reúne 200 problemas abertos de RL
Em 28 de setembro de 2026, a FrontierSmith publicou um repositório com 200 problemas para estudar aprendizado por reforço em tarefas abertas e desafiadoras.
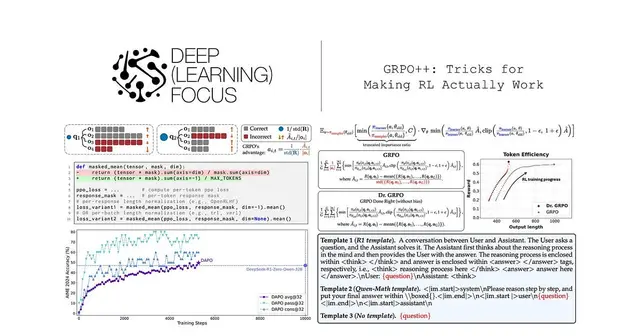
GRPO e OPD: caminhos práticos para post-training
Publicação de 26 de agosto de 2026 apresenta dois recursos sobre post-training com aprendizado por reforço: um sobre escalar o GRPO vanilla e outro dedicado a OPD.
- há 19 dias
 unsloth.ai
GRPO no treinamento de modelos de raciocínio: o guia da Unsloth
Publicado em 26 de setembro de 2026, o guia da Unsloth percorre reinforcement learning do nível iniciante ao avançado e apresenta o uso de GRPO no treinamento de modelos de raciocínio.
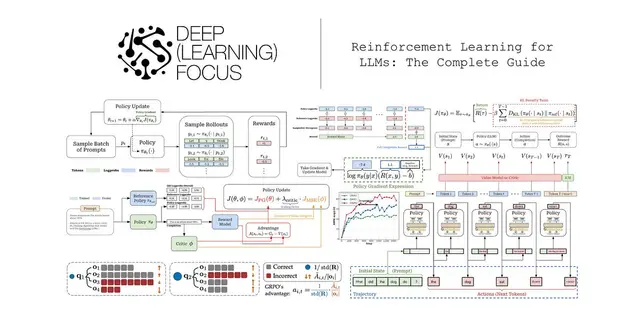
Guia de reinforcement learning para modelos de linguagem
Publicado em 24 de agosto de 2026, o guia relaciona fundamentos de reinforcement learning a métodos de treinamento de modelos de linguagem, incluindo policy gradients, REINFORCE e diferentes formas de definir estados e recompensas.
- há 19 dias arxiv.org
Informação privilegiada pode afetar raciocínios longos em modelos
Artigo datado de 7 de julho de 2026 relata degradação em trajetórias longas de raciocínio após self-distillation com informação privilegiada, em cinco modelos avaliados no AIME.
- há 19 dias arxiv.org
LED explora camadas intermediárias em modelos de raciocínio
Artigo publicado em 10 de julho de 2026 relata que o Latent Exploration Decoding usa distribuições de camadas intermediárias para ampliar a exploração sem treinamento adicional.
- há 19 dias arxiv.org
LENS combina raciocínio e segmentação de imagens com RL
O artigo apresenta o LENS, um framework que usa aprendizado por reforço para otimizar o raciocínio e a segmentação de imagens a partir de texto.
- há 19 dias esraasaleh.com
Operadores de contração em RL: do conceito ao aprendizado interno
Artigo publicado em 12 de setembro de 2026 apresenta uma abordagem visual e concisa para explicar operadores de contração, conceito fundamental de aprendizado por reforço.
Otimizar objetivos avaliáveis sem recorrer a RL
Post de 27 de agosto de 2026 inicia uma série sobre alternativas ao aprendizado por reforço e apresenta métodos de amostragem para otimizar objetivos avaliáveis.
- há 19 dias arxiv.org
Paper avalia feedback de LLM-as-a-Judge no treinamento
Publicado em 19 de setembro de 2026, o paper estuda o uso do próprio modelo de linguagem para gerar feedback durante o treinamento e compara a abordagem a modelos de recompensa congelados, treinados com preferências humanas.
- há 19 dias x.com
Policy gradients: da derivação à avaliação prática
Publicado em 30 de agosto de 2026, o artigo revisa trabalhos fundamentais de aprendizado por reforço, deriva o algoritmo de policy gradient e discute suas variantes.
- há 19 dias arxiv.org
Positional encodings: como comparar alternativas ao RoPE
Estudo publicado em 29 de setembro de 2026 examina o viés do RoPE por tokens próximos e alternativas avaliadas em diferentes configurações.
Post compara eficiência de OPD e RL no treinamento de modelos
Datado de 19 de junho de 2026, o post afirma que OPD pode usar compute e amostras com mais eficiência que RL na busca por traces de raciocínio com alta recompensa.
- há 19 dias x.com
ProRL Agent separa rollouts do treino de políticas de LLMs
Publicado em 30 de setembro de 2026, o ProRL Agent descreve uma infraestrutura open source que separa geração de trajetórias, orquestração de ambientes e avaliação da otimização de políticas para agentes multi-turn.
- há 19 dias arxiv.org
Raciocínio verificado sem atualizar os pesos do modelo
Post publicado em 23 de junho de 2026 propõe manter um modelo de linguagem congelado e recuperar raciocínios verificados de um conjunto externo, com verificação lógica como desafio central.
- há 19 dias fa.bianp.net
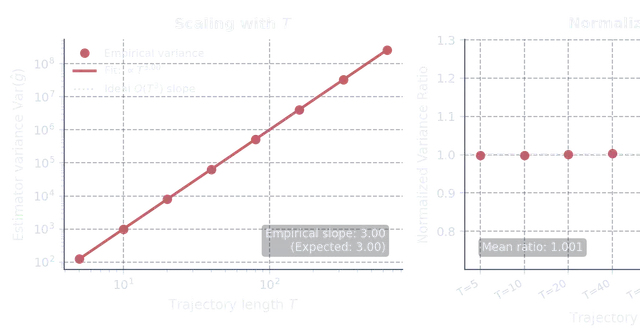
REINFORCE: gradientes de política e variância
Post publicado em 12 de julho de 2026: deriva o estimador REINFORCE sem diferenciar pelo ambiente e analisa como a variância depende do tamanho da trajetória.
- há 19 dias x.com
RubricEM usa critérios por etapa para treinar agentes de pesquisa
Publicado em 5 de julho de 2026, o trabalho descreve agentes que criam critérios de avaliação antes de pesquisar e reutilizam lições de tentativas avaliadas.
- há 19 dias github.com
RULER transforma avaliações de agentes em recompensas para GRPO
Post do OpenPipe ART, publicado em 17 de setembro de 2026, descreve como avaliações de trajetórias ranqueadas por um LLM podem gerar recompensas para treinamento de agentes.
- há 19 dias x.com
Sandboxes em escala: referência para infraestrutura
Uma publicação datada de 22 de setembro de 2026 relata que uma unidade de computação em escala de produção cobre cerca de 160 nós e suporta mais de 380 mil sandboxes simultâneos.
- há 19 dias arxiv.org
Self-Distillation On-Policy para raciocínio em LLMs
Paper datado de 28 de setembro de 2026 descreve um método de treinamento que combina trajetórias geradas pelo student com supervisão densa de um teacher em cada token.
Vamos avaliar seu projeto

Respondo com escopo e proposta.