


Notícias de IA e infraestrutura
Filtrar por tipo: Artigo16
- há 17 dias blog.ml.cmu.edu
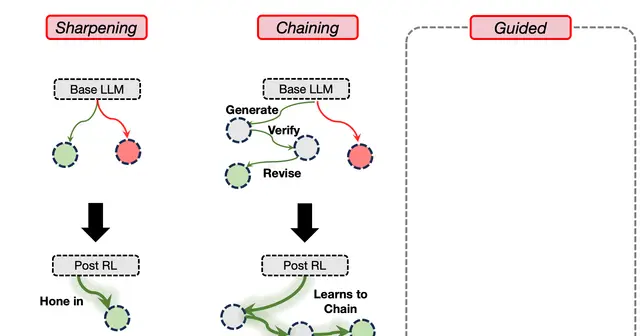
Exploração em RL para treinar LLMs em tarefas difíceis
Post da CMU, publicado em 31 de janeiro de 2026, descreve três regimes de exploração e riscos de estagnação e interferência no treinamento por reinforcement learning.
- há 17 dias
 unsloth.ai
GRPO com contexto de 380K em uma GPU de 192 GB
Em 15 de janeiro de 2026, a documentação da Unsloth descreveu fine-tuning com GRPO e contexto longo, afirmando que seus algoritmos de batching permitem contexto de 380K para gpt-oss em uma GPU de 192 GB.
- há 17 dias alphaxiv.org
LoRA para RLVR: média de especialistas supera gate nos testes
Em 3 de janeiro de 2026, um trabalho sobre estratégias práticas de PEFT para RLVR em múltiplos domínios relatou interferência no treinamento conjunto. Nos experimentos descritos, a média dos pesos de LoRAs especialistas, seguida de treinamento contínuo, superou o método de gating testado.
- há 17 dias aweers.de
Métodos de RL para modelos de raciocínio
Artigo publicado em 16 de março de 2026 reúne métodos de aprendizado por reforço usados com modelos de linguagem, oferecendo uma base para comparação por equipes de engenharia.
RL em sistemas de treinamento: desafios e resultados de pass@k
Artigo publicado em 21 de dezembro de 2025 reúne desafios de rollouts em treinamento por RL e resultados variados sobre desempenho pass@k.
- há 17 dias
 hgpu.org
RL online para geração de código HPC com benchmarks reais
Artigo publicado em 15 de fevereiro de 2026 descreve o uso de aprendizado por reforço online, recompensado por benchmarks em máquinas reais, para melhorar a geração de código HPC. O desempenho em execução do código gerado não é garantido.
RLHF em GPUs AMD: implantação com ROCm 7.0
Artigo da AMD, publicado em 2 de março de 2026, descreve o uso de verl para treinamento de RLHF em GPUs AMD, com otimizações para ROCm e scripts Docker, e apresenta resultados de throughput e convergência.
Treinamento com RL: riscos de dados e infraestrutura
Publicada em 5 de novembro de 2025, a publicação aponta que feedback ruidoso e uma infraestrutura complexa podem tornar o treinamento com RL instável.
- há 18 dias arxivb.org
Como direcionar o compute de RL para problemas difíceis
Artigo publicado em 18 de setembro de 2026 relata que o método adaptativo Never Give Up amostra até obter sucesso para direcionar compute de treinamento por reforço a problemas mais difíceis em LLMs.
GRPO e OPD: caminhos práticos para post-training
Publicação de 26 de agosto de 2026 apresenta dois recursos sobre post-training com aprendizado por reforço: um sobre escalar o GRPO vanilla e outro dedicado a OPD.
- há 18 dias unsloth.ai
GRPO no treinamento de modelos de raciocínio: o guia da Unsloth
Publicado em 26 de setembro de 2026, o guia da Unsloth percorre reinforcement learning do nível iniciante ao avançado e apresenta o uso de GRPO no treinamento de modelos de raciocínio.
Guia de reinforcement learning para modelos de linguagem
Publicado em 24 de agosto de 2026, o guia relaciona fundamentos de reinforcement learning a métodos de treinamento de modelos de linguagem, incluindo policy gradients, REINFORCE e diferentes formas de definir estados e recompensas.
- há 18 dias esraasaleh.com
Operadores de contração em RL: do conceito ao aprendizado interno
Artigo publicado em 12 de setembro de 2026 apresenta uma abordagem visual e concisa para explicar operadores de contração, conceito fundamental de aprendizado por reforço.
Otimizar objetivos avaliáveis sem recorrer a RL
Post de 27 de agosto de 2026 inicia uma série sobre alternativas ao aprendizado por reforço e apresenta métodos de amostragem para otimizar objetivos avaliáveis.
Post compara eficiência de OPD e RL no treinamento de modelos
Datado de 19 de junho de 2026, o post afirma que OPD pode usar compute e amostras com mais eficiência que RL na busca por traces de raciocínio com alta recompensa.
- há 18 dias fa.bianp.net
REINFORCE: gradientes de política e variância
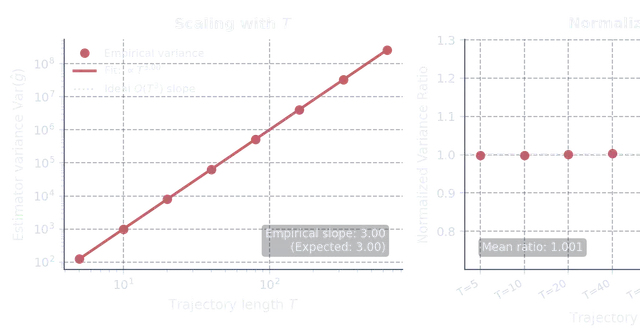
Post publicado em 12 de julho de 2026: deriva o estimador REINFORCE sem diferenciar pelo ambiente e analisa como a variância depende do tamanho da trajetória.
Vamos avaliar seu projeto

Respondo com escopo e proposta.