


Notícias de IA e infraestrutura
Filtrar por tipo: Todos90
Ming 3 TTS aparece em primeiro entre modelos de voz abertos em ranking da Artificial Analysis
Post relata que o modelo aberto Ming 3 TTS, publicado pela inclusionAI, lidera o ranking da Artificial Analysis entre modelos TTS abertos e supera levemente o Fish Audio Drama 3. Para quem hospeda síntese de voz, vale avaliar os candidatos com dados próprios antes de trocar de modelo.
- há 1 dia x.com
Dessa: modelo speech-to-speech full-duplex anunciado para GPUs de consumo
Post anuncia o Dessa, modelo de fala para fala full-duplex que, segundo o autor, foi treinado apenas com fala e roda em GPUs de consumo. Relevante para voz conversacional local.
- há 1 dia x.com
Open TTS Leaderboard inclui modelos de 31M e 35B e a métrica UTMOS
A atualização do Open TTS Leaderboard compara um modelo aberto de 31M parâmetros com um de 35B em WER em inglês e adiciona a métrica UTMOS para naturalidade da fala.
- há 3 dias github.com
Phonon 31M: TTS aberto rodando na Neural Engine da Apple via Swift
Post sobre um port em Swift do modelo TTS aberto Phonon 31M, com CoreML na Neural Engine, 103 vozes e latência e velocidade declaradas pelo autor.
- há 4 dias x.com
Ant Ling libera cinco modelos de fala Ming-3.0 com pesos abertos
A Ant Ling anunciou a liberação open-source de cinco modelos Ming-3.0 com variantes de síntese de voz, compreensão de áudio, diálogo e reconhecimento automático de fala para dialetos.
- há 4 dias x.com
ASR em streaming: decodificar fala sem ver o áudio futuro
O post da Tongyi Speech AI explica o reconhecimento de fala em streaming, em que palavras precisam ser definidas antes do fim da fala. Latência e lookahead moldam o modelo e o decoder em aplicações de voz ao vivo.
- há 4 dias x.com
Kyutai lança versões menores do Pocket TTS com até 1,9M de parâmetros
A Kyutai Labs anunciou versões menores do Pocket TTS, de 18,2M, 6,9M e 1,9M de parâmetros, e afirma que a de 1,9M roda 103x mais rápido que o tempo real em um núcleo de CPU, com clonagem de voz.
- há 4 dias x.com
Modelos TTS open source menores que o Kokoro, com clonagem de voz
O post anuncia modelos open source de síntese de fala com cerca de metade do tamanho do Kokoro (82M parâmetros), com maior naturalidade e precisão declaradas e suporte a clonagem de voz. Pode reduzir o custo de síntese local.
- há 4 dias x.com
Phonon: modelo TTS multilíngue de 40M de parâmetros para voz executada localmente
Segundo o anúncio do autor, o Phonon é um modelo text-to-speech de cerca de 40M de parâmetros, com vários idiomas, biblioteca de vozes e uso local pelo pacote speech-to-speech.
- há 4 dias x.com
Phonon: TTS aberto de 31M de parâmetros rodando no navegador via WebGPU
Post relata o port do Phonon, um TTS open de 31M de parâmetros da GradiumAI, para rodar totalmente no navegador via WebGPU em meia precisão, com cerca de 47x tempo real no M4 Pro e 7x no Phone 13 Pro.
- há 4 dias github.com
Voz no iPhone sem nuvem: app de código aberto combina Phonon TTS e Pipecat no próprio aparelho
Um app iOS de código aberto roda speech-to-text e text-to-speech inteiramente no celular, com Pipecat embarcado, o SpeechAnalyzer da Apple e o modelo Gradium Phonon 31M, sem inferência na rede.
- há 5 dias github.com
Pull request adiciona TTS em streaming Drama-3 ao pipeline speech-to-speech
Um pull request propõe o Drama-3, da Fish Audio, como backend de text-to-speech em streaming em um repositório speech-to-speech, com clonagem de voz opcional e entonações expressivas como sussurros e risos.
- há 6 dias x.com
AuroraASR-1M: reconhecimento de fala offline em CPU com modelo de 1 MB
Post descreve modelo Conformer-CTC de 949K parâmetros para inglês, com 1,06 MB em INT8, licença Apache 2.0, velocidade de cerca de 436x tempo real em uma thread de CPU e WER de 11,43% no test-clean.
- há 6 dias github.com
Dublagem com clonagem de voz local: OpenVoice em hardware comum
O post descreve um agente de IA usando o OpenVoice, modelo de clonagem de voz instantânea de código aberto do MIT e da MyShell, para dublar um filme em polonês mantendo o diálogo sincronizado, num Mac mini M4 de 16 GB.
- há 15 dias x.com
Artificial Analysis: HeyGen Voice lidera ranking de síntese de voz controlada
A Artificial Analysis classificou o HeyGen Voice em 1º lugar no Controlled Voice TTS Arena, com Elo de 1.201 em 8 vozes clonadas em inglês dos EUA e do Reino Unido, à frente de modelos comerciais concorrentes de voz.
- há 15 dias huggingface.co
Qwen3-TTS 1.7B: clonagem de voz open-source com controles de emoção e sotaque
O post apresenta um modelo open-source de text-to-speech de 1,7B para clonagem de voz, com controles de emoção, idade, tom e sotaque e suporte multilíngue. Para empresas, a avaliação self-hosted exige checar licença, idiomas e controles antes de qualquer uso.
- há 15 dias huggingface.co
Whistle: modelo de speech-to-text de 16,9 MB para rodar no dispositivo
A Cactus-Compute publicou o Whistle, um modelo de speech-to-text de 16,9 MB para uso on-device. O autor afirma que ele rivaliza com o Whisper base. Para empresas com áudios sensíveis, o anúncio abre a avaliação de transcrição local.
- há 16 dias x.com
Clones de voz de falantes não nativos avaliados como mais humanos: o que muda para empresas
Um artigo do NeurIPS 2026 clonou vozes de 86 falantes não nativos de inglês com três sistemas de síntese de voz. Em 4.000 avaliações humanas, os clones foram considerados mais calorosos, autoritativos e humanos, o que reforça riscos para a confiança em canais de voz.
- há 17 dias models.handy.computer
Benchmark multilíngue de speech-to-text para modelos locais no transcribe.cpp em notebook
Site que compara precisão e velocidade de modelos de speech-to-text suportados pelo transcribe.cpp, medidos por idioma no conjunto FLEURS, com dados de um notebook com CPU/GPU 4750U.
- há 17 dias x.com
TTS de voz única com 9MB destilado do Kokoro-82M para saída de voz local
Um post descreve um modelo de text-to-speech de voz e idioma únicos, com cerca de 9MB de pesos, destilado do Kokoro-82M e pensado para saída de voz local em dispositivos com recursos limitados.
- há 17 dias inworld.ai
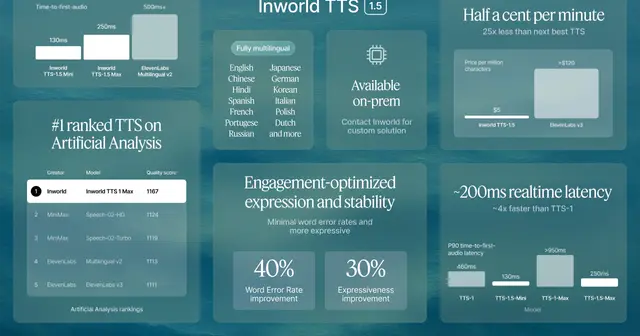
Avaliação humana destaca síntese de fala em quatro categorias
Em 6 de novembro de 2025, a Artificial Analysis informou que um modelo de síntese de fala liderava seu Speech Arena, uma avaliação cega de preferência humana em quatro categorias de fala do mundo real.
- há 17 dias x.com
Avaliação privada para reduzir vazamento em ASR
Em 6 de maio de 2026, o Open ASR Leaderboard passou a incluir dados privados de avaliação da Appen e da DataoceanAI para reduzir a contaminação dos testes e o overfitting.
- há 17 dias huggingface.co
Como avaliar diálogo falado em tempo real na empresa
Uma publicação de 16 de janeiro de 2026 descreve um modelo de diálogo falado interativo, com licença Apache 2.0 e arquitetura dual brain voltada à baixa latência. Veja como avaliar uma aplicação de voz antes de integrá-la.
- há 17 dias x.com
Como avaliar modelos de voz para produtos e operações
Em 6 de novembro de 2025, a Artificial Analysis informou que o Inworld TTS 1 Max liderava o Speech Arena, uma comparação às cegas de modelos de síntese de voz com avaliações humanas.
- há 17 dias docs.vllm.ai
Como avaliar o serving de reconhecimento de voz com vLLM
Uma publicação datada de 29 de janeiro de 2026 informa que o vLLM oferece suporte ao Qwen3-ASR desde o lançamento e aponta um guia para executar o modelo.
- há 17 dias ai.google.dev
Como planejar tradução ao vivo em experiências multilíngues
Documentação publicada em 9 de junho de 2026 aborda tradução ao vivo por API. Veja como avaliar uma implementação para os processos da sua empresa.
- há 17 dias github.com
Edição de áudio por prompts: o que avaliar na empresa
Post da StepFun, publicado em 8 de novembro de 2025, descreve um modelo de 3 bilhões de parâmetros para edição de áudio e geração de fala multilíngue.
- há 17 dias github.com
FireRedVAD: detecção de voz em mais de 100 idiomas
O repositório FireRedVAD descreve detecção de atividade de voz e eventos de áudio, com suporte informado a mais de 100 idiomas. Veja como avaliar sua integração em pipelines de fala.
- há 17 dias github.com
Inferência em C abre caminho para transcrição de voz integrada
O repositório antirez/qwen-asr oferece inferência em C para modelos de reconhecimento de fala de 0,6B e 1,7B, com aplicação potencial em bots de transcrição e interfaces por voz.
- há 17 dias lemas-project.github.io
LEMAS publica dataset de speech com 150 mil horas
Publicação de 12 de janeiro de 2026 apresenta um dataset de áudio com 150 mil horas em 10 idiomas, timestamps por palavra e os modelos generativos LEMAS-TTS e LEMAS-Edit.
- há 17 dias github.com
Local Studio propõe suporte a ROCm, voz, imagens e vídeos
Um pull request do repositório Local Studio, publicado em 9 de fevereiro de 2026, descreve suporte proposto a ROCm, entrada e saída de voz, imagens e vídeos.
- há 17 dias x.com
Microsoft anuncia transcrição de áudio longo com diarização
Artigo publicado em 2 de março de 2026 descreve um modelo que, segundo a Microsoft, transcreve até 60 minutos de áudio em uma passagem e oferece suporte a mais de 50 idiomas.
- há 17 dias x.com
Pocket TTS: síntese de voz em laptops sem GPU
Em post publicado em 13 de janeiro de 2026, a Kyutai Labs apresentou o Pocket TTS, modelo de síntese de voz com 100 milhões de parâmetros, clonagem de voz e execução em laptop sem GPU.
- há 17 dias x.com
Reconhecimento de fala em áudio distante: como avaliar modelos
Em 10 de junho de 2026, a Cohere afirmou que seu modelo aberto de reconhecimento de fala ficou em primeiro lugar no benchmark Far-Field ASR. O resultado pode orientar a avaliação de sistemas para áudio distante.
- há 17 dias github.com
Reconhecimento de fala em mais de 1.600 idiomas
Em 10 de novembro de 2025, a Meta anunciou modelos open source de reconhecimento de fala e um conjunto de dados para mais de 1.600 idiomas, incluindo 500 descritos como antes sem suporte.
- há 17 dias github.com
Repositório open source oferece ponto de partida para agentes de voz
Publicado em 6 de fevereiro de 2026, o repositório apresenta uma base para engenheiros criarem agentes de voz com modelos open source.
- há 17 dias gradium.ai
TTS para pronunciar dados estruturados com mais precisão
Em publicação de 10 de junho de 2026, a Gradium afirma que uma atualização de seu modelo TTS melhora a pronúncia de palavras soletradas, siglas, e-mails, números de telefone e códigos.
- há 17 dias github.com
UNITTS reúne inferência e benchmarking de voz sintética
Post datado de 9 de junho de 2026 apresenta o UNITTS, toolkit para inferência e benchmarking de modelos TTS open source, com suporte a Chatterbox e Fish Audio s2-pro.
- há 17 dias vllm.ai
vLLM relata streaming e API WebSocket em tempo real
Em 11 de fevereiro de 2026, o blog do vLLM descreveu entradas em streaming e uma API WebSocket para aplicações de áudio, vídeo, robótica e baixa latência.
- há 17 dias x.com
VoxCPM: fala expressiva sem tokenizer
Publicado em 31 de janeiro de 2026, o post descreve um sistema de síntese de fala que usa representações contínuas, clonagem de voz zero-shot e geração expressiva.
Vamos avaliar seu projeto

Respondo com escopo e proposta.