


Notícias de IA e infraestrutura
Filtrar por tipo: Todos90
- há 18 dias sesame.com
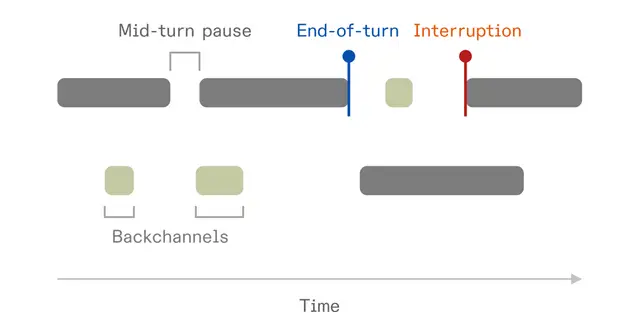
TurnBench avalia a alternância de turnos em diálogos falados
Benchmark aberto com 30 horas de fala diádica anotada por três pessoas, protocolo de pontuação baseado na análise da conversação e resultados de 14 sistemas, para medir a alternância de turnos.
- há 18 dias github.com
Como estruturar a transcrição de gravações longas
Descrição publicada em 17 de setembro de 2025 apresenta uma ferramenta em Python que divide áudio por detecção de atividade de voz, processa chamadas em paralelo e aceita vários formatos de mídia.
- há 18 dias x.com
App de voz passa a aceitar modelos personalizados em cinco idiomas
Uma publicação de 11 de novembro de 2024 informa que o app Gradio do e2-f5-tts passou a aceitar finetunes personalizados do F5-TTS para espanhol, húngaro, alemão, português e grego.
- há 18 dias x.com
ASR Moonshine chega à biblioteca Transformers
Post de 20 de janeiro de 2025 anuncia a integração do Moonshine ao Transformers: o modelo usa Rotary Position Embeddings e aceita áudio de qualquer duração.
- há 18 dias x.com
Áudio com raciocínio: benchmark marca 92%
Relatório da Artificial Analysis registra 92% para um modelo de áudio no Big Bench Audio e compara o tempo até o primeiro token com e sem raciocínio.
- há 18 dias huggingface.co
Avaliar síntese de voz em francês na empresa
Uma postagem de PHBJT, publicada em 25 de setembro de 2024, aponta para um modelo de síntese de voz em francês e menciona outras opções de text-to-speech.
- há 18 dias github.com
Codec de áudio para Speech LLMs: tokens paralelos e streaming
Em post publicado em 17 de outubro de 2025, a Meituan apresentou um codec de áudio de código aberto otimizado para Speech LLMs, com tokens semânticos e acústicos a 16,7 Hz e decodificação de streaming de baixa latência.
- há 18 dias x.com
Como avaliar inferência de voz em tempo real
Publicado em 18 de setembro de 2024, o artigo apresenta Moshi, um modelo de speech-to-speech com 7,6 bilhões de parâmetros, e o codec de áudio streaming Mimi.
- há 18 dias artificialanalysis.ai
Como comparar opções de speech-to-text por qualidade, velocidade e custo
Em 24 de junho de 2024, a Artificial Analysis publicou uma comparação de modelos de speech-to-text por taxa de erro de palavras, velocidade e preço, com um ranking voltado à escolha conforme o caso de uso.
- há 18 dias x.com
E2-F5-TTS inclui interface para ajustar modelos de voz
Em 21 de outubro de 2024, o repositório E2-F5-TTS apresentou um app Gradio para ajustar o modelo com áudio enviado pelo usuário e transcrever os clipes automaticamente.
- há 18 dias huggingface.co
Fala multilíngue: como avaliar o FireRedTTS 2
Publicado em 17 de setembro de 2025, o artigo apresenta um modelo aberto de síntese de fala com suporte a conversas longas, clonagem de voz multilíngue e geração de baixa latência.
- há 18 dias x.com
FireRedChat: voz full-duplex para assistentes
Post de 7 de outubro de 2025 descreve um sistema modular de interação por voz com modos em cascata e semicascata, interrupções, detecção de fim de fala e respostas em tempo real.
- há 18 dias github.com
Hibiki: tradução de fala em streaming
Repositório publicado em 6 de fevereiro de 2025 apresenta um modelo decoder-only para tradução simultânea de fala entre francês e inglês, treinado com dados sintéticos.
- há 18 dias
 arxiv.org
MaskGCT: síntese de fala com clonagem de voz zero-shot
Publicado em 24 de outubro de 2024, o artigo sobre o MaskGCT apresenta um modelo de texto para fala que, segundo a publicação, pode clonar uma voz usando cinco segundos de fala.
- há 18 dias x.com
Mini-Omni-Reasoner combina raciocínio e fala
Post de 22 de setembro de 2025 descreve uma arquitetura que intercala raciocínio silencioso e tokens falados, além de um novo conjunto de dados e ganhos relatados em matemática e compreensão contextual.
- há 18 dias x.com
Parler-TTS: modelos de voz controláveis para avaliar
Publicado em 8 de agosto de 2024, o anúncio apresenta os modelos Mini e Large v1, treinados com 45 mil horas de fala, e descreve controles de voz por prompts de texto.
- há 18 dias x.com
Piper oferece síntese de voz neural local e multilíngue
Publicado em 7 de janeiro de 2025, o texto descreve o Piper, sistema local que converte texto em fala com várias vozes, idiomas e opções personalizáveis.
- há 18 dias github.com
Qwen3-Omni: modelos multimodais com fala
Em 22 de setembro de 2025, a Qwen apresentou três modelos que combinam texto, imagem, áudio e vídeo, com entrada e saída de fala.
- há 18 dias modal.com
Transcrição de áudio em streaming: exemplo da Modal
Em 6 de agosto de 2025, a Modal apresentou um exemplo de implantação de um serviço de reconhecimento de fala em streaming com Kyutai STT.
- há 18 dias x.com
TTS em streaming abre caminho para diálogos com várias vozes
Um post de 15 de setembro de 2025 descreve um sistema de geração de fala de longa duração que intercala texto e áudio para diálogos contextuais com múltiplos speakers.
- há 18 dias x.com
TTS local com clonagem de voz: riscos e implementação
Em 15 de fevereiro de 2025, a Zonos anunciou um beta de síntese expressiva de fala com clonagem de voz, modelos abertos e um launcher local multiplataforma.
- há 18 dias github.com
Ultravox e aplicações de voz em tempo real
O repositório no GitHub apresenta o Ultravox, descrito como um LLM multimodal rápido para voz em tempo real. Publicado em 18 de novembro de 2024, o projeto tem código-fonte disponível para exame.
- há 18 dias x.com
VoiceCraft: edição de fala e síntese zero-shot
Publicado em 25 de agosto de 2024, o texto descreve o VoiceCraft, modelo que edita fala e gera voz a partir de alguns segundos de áudio de referência.
- há 18 dias x.com
XEUS: encoder de fala multilíngue com código e checkpoints
Em 1º de julho de 2024, a WavLab anunciou o XEUS, um encoder de fala treinado com mais de 1 milhão de horas de áudio e que abrange mais de 4.000 idiomas. Código, checkpoints e dados foram disponibilizados.
- há 19 dias github.com
Breeze TTS 2 abre os pesos do modelo
Em 26 de agosto de 2026, a BreezeBlue anunciou pesos abertos para o Breeze TTS 2 e afirmou que o modelo lidera uma arena de avaliação de vozes.
- há 19 dias x.com
Breeze TTS 2: voz multilíngue com geração em streaming
A publicação de 25 de agosto de 2026 descreve um modelo de síntese de voz com suporte a 50 idiomas, geração a partir de prompts de texto e saída em streaming.
- há 19 dias github.com
CocktailASR-1 transcreve uma voz selecionada em áudio sobreposto
Publicado pela Xiaomi em 16 de setembro de 2026, o CocktailASR-1 usa voiceprints de referência para transcrever um falante escolhido em áudio misto. A publicação informa suporte a inglês e chinês.
- há 19 dias arxiv.org
Como ampliar LLMs congelados para compreender áudio
Um paper datado de 28 de setembro de 2026 propõe injetar vetores condicionados por áudio no KV cache de um LLM congelado, sem ajustar os pesos do modelo.
- há 19 dias x.com
Diarização de fala: como avaliar a correção de rótulos
Artigo do Google publicado em 4 de outubro de 2026 descreve um modelo de 4 bilhões de parâmetros ajustado para corrigir rótulos de falantes e reduzir erros de diarização por palavra em quatro benchmarks.
- há 19 dias discourse.ubuntu.com
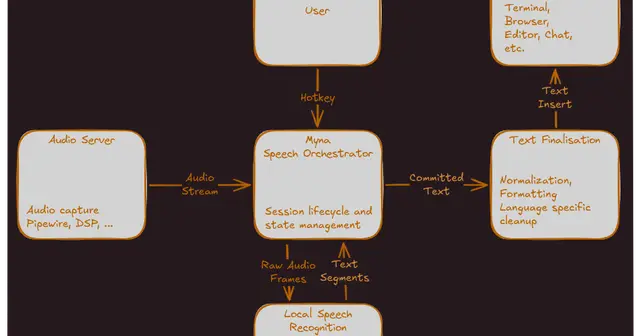
Ditado local no Ubuntu: como avaliar o Project Myna
Em publicação de 18 de junho de 2026, o Ubuntu descreve o Project Myna, recurso planejado para o Ubuntu 26.10 que pretende inserir ditado por voz no aplicativo ativo, com processamento local.
- há 19 dias github.com
FireRedAudio reúne cinco tarefas de fala em um modelo
Publicado em 27 de agosto de 2026, o FireRedAudio combina reconhecimento e compreensão de áudio, geração de fala e edição em um modelo com representações distintas para compreensão e geração.
- há 19 dias x.com
Índice compara modelos de fala em três capacidades
Publicado em 23 de junho de 2026, o índice da Artificial Analysis combina três conjuntos de avaliação para comparar modelos nativos de Speech-to-Speech.
- há 19 dias x.com
Limpeza de áudio local no Raspberry Pi 5: como avaliar a aplicação
Uma postagem de 22 de junho de 2026 apresenta um modelo de 49 mil parâmetros para cancelamento de eco, supressão de ruído e redução de reverberação, com desempenho declarado de 21× em tempo real em um núcleo do Raspberry Pi 5.
- há 19 dias x.com
NVIDIA apresenta diarização para falas sobrepostas
Anúncio datado de 23 de setembro de 2026: o Nemotron 3 Diarization identifica quem falou e quando, inclusive em falas sobrepostas, e suporta até oito interlocutores.
- há 19 dias github.com
OmniVoice: síntese e clonagem de voz em mais de 600 idiomas
Uma publicação de 6 de setembro de 2026 descreve um projeto Python de síntese de fala com clonagem zero-shot, compatível com mais de 600 idiomas e controles de voz configuráveis.
- há 19 dias x.com
Packed FlashAttention acelera vocoder Transformer
Uma publicação de 20 de julho de 2026 relata aumento de 48,64% no QPS de um vocoder Transformer após otimizações na reconstrução de waveform.
- há 19 dias arxiv.org
Phoenix-VAD: detectar o fim da fala em diálogos por voz
Artigo publicado em 4 de setembro de 2026 apresenta um modelo baseado em LLM para detectar semanticamente o fim da fala em interações de voz full-duplex em streaming, usando treinamento com janela deslizante.
- há 19 dias x.com
Phonon-1: transcrição local de áudio em avaliação
Post de 28 de agosto de 2026 apresenta o Phonon-1, modelo de reconhecimento de fala com 782 milhões de parâmetros, download de 415 MB e licença Apache 2.0.
- há 19 dias moondream.ai
Photon 2.1 amplia ASR em streaming para implantação própria
A Moondream afirma que o Photon 2.1 adiciona reconhecimento de fala em streaming para três modelos e supera os mecanismos de referência em todos os testes comparáveis.
- há 19 dias github.com
Plugin para ComfyUI oferece voz local e ajuste LoRA
Publicado em 25 de agosto de 2026, o repositório ComfyUI_VoxCPM_SM apresenta inferência do VoxCPM2 e ajuste fino com LoRA usando dados de voz personalizados, com suporte a pouca VRAM e modelos quantizados.
Vamos avaliar seu projeto

Respondo com escopo e proposta.