


Notícias de IA e infraestrutura
Filtrar por tipo: Artigo11
- há 17 dias models.handy.computer
Benchmark multilíngue de speech-to-text para modelos locais no transcribe.cpp em notebook
Site que compara precisão e velocidade de modelos de speech-to-text suportados pelo transcribe.cpp, medidos por idioma no conjunto FLEURS, com dados de um notebook com CPU/GPU 4750U.
- há 17 dias inworld.ai
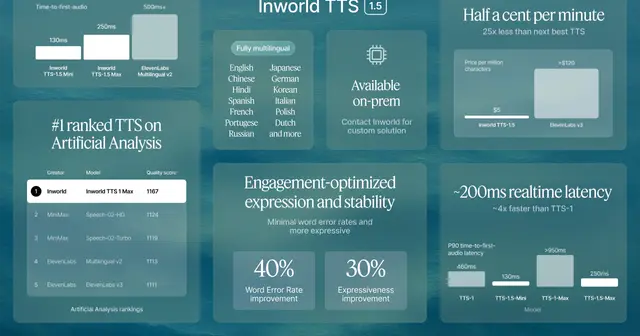
Avaliação humana destaca síntese de fala em quatro categorias
Em 6 de novembro de 2025, a Artificial Analysis informou que um modelo de síntese de fala liderava seu Speech Arena, uma avaliação cega de preferência humana em quatro categorias de fala do mundo real.
- há 17 dias ai.google.dev
Como planejar tradução ao vivo em experiências multilíngues
Documentação publicada em 9 de junho de 2026 aborda tradução ao vivo por API. Veja como avaliar uma implementação para os processos da sua empresa.
- há 17 dias lemas-project.github.io
LEMAS publica dataset de speech com 150 mil horas
Publicação de 12 de janeiro de 2026 apresenta um dataset de áudio com 150 mil horas em 10 idiomas, timestamps por palavra e os modelos generativos LEMAS-TTS e LEMAS-Edit.
- há 17 dias gradium.ai
TTS para pronunciar dados estruturados com mais precisão
Em publicação de 10 de junho de 2026, a Gradium afirma que uma atualização de seu modelo TTS melhora a pronúncia de palavras soletradas, siglas, e-mails, números de telefone e códigos.
- há 17 dias vllm.ai
vLLM relata streaming e API WebSocket em tempo real
Em 11 de fevereiro de 2026, o blog do vLLM descreveu entradas em streaming e uma API WebSocket para aplicações de áudio, vídeo, robótica e baixa latência.
- há 17 dias sesame.com
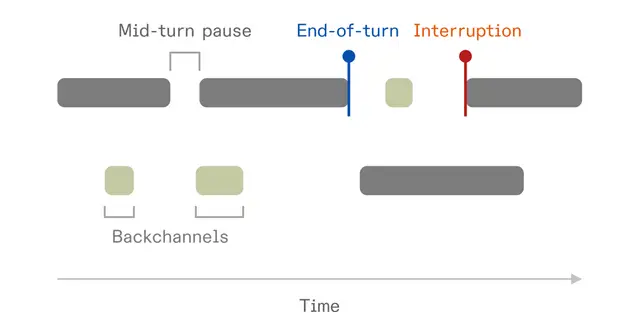
TurnBench avalia a alternância de turnos em diálogos falados
Benchmark aberto com 30 horas de fala diádica anotada por três pessoas, protocolo de pontuação baseado na análise da conversação e resultados de 14 sistemas, para medir a alternância de turnos.
- há 17 dias artificialanalysis.ai
Como comparar opções de speech-to-text por qualidade, velocidade e custo
Em 24 de junho de 2024, a Artificial Analysis publicou uma comparação de modelos de speech-to-text por taxa de erro de palavras, velocidade e preço, com um ranking voltado à escolha conforme o caso de uso.
- há 17 dias modal.com
Transcrição de áudio em streaming: exemplo da Modal
Em 6 de agosto de 2025, a Modal apresentou um exemplo de implantação de um serviço de reconhecimento de fala em streaming com Kyutai STT.
- há 18 dias discourse.ubuntu.com
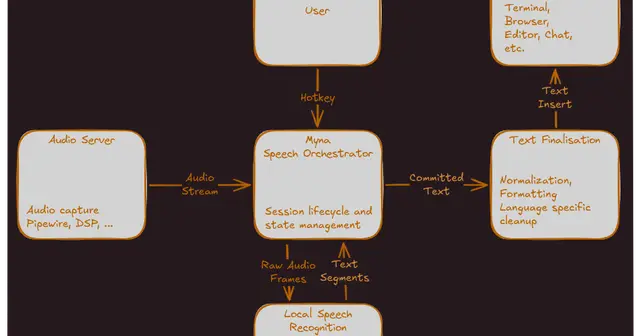
Ditado local no Ubuntu: como avaliar o Project Myna
Em publicação de 18 de junho de 2026, o Ubuntu descreve o Project Myna, recurso planejado para o Ubuntu 26.10 que pretende inserir ditado por voz no aplicativo ativo, com processamento local.
- há 18 dias moondream.ai
Photon 2.1 amplia ASR em streaming para implantação própria
A Moondream afirma que o Photon 2.1 adiciona reconhecimento de fala em streaming para três modelos e supera os mecanismos de referência em todos os testes comparáveis.
Vamos avaliar seu projeto

Respondo com escopo e proposta.