


Notícias de IA e infraestrutura
Filtrar por tipo: Pesquisa39
- há 16 dias
 arxiv.org
RoboJEPA: como a escala de modelos de mundo JEPA afeta o planejamento robótico
A Meta apresentou o RoboJEPA, um modelo de mundo latente baseado em JEPA, escalado de 22M para 8B de parâmetros e treinado com dados de 12 embodiments robóticos. O artigo testa se o erro de predição latente prevê o desempenho de planejamento posterior.
- há 17 dias arxiv.org
Roteamento de experts com eficiência de memória para treinamento distribuído de MoE
O artigo no arXiv propõe métodos para reduzir o pico de memória no treinamento distribuído de Mixture-of-Experts, em que o dispatch de experts domina o uso de memória.
- há 17 dias arxiv.org
Anti-grokking: sinais de perda de generalização nos pesos
Paper publicado em 4 de fevereiro de 2026 examina se matrizes de pesos podem revelar colapso tardio da generalização em dois experimentos com treinamento prolongado.
- há 17 dias arxiv.org
CE-GPPO busca preservar gradientes no RL de LLMs
Publicado em 30 de outubro de 2025, o paper apresenta o CE-GPPO, método que aborda gradientes de tokens de baixa probabilidade descartados pelo clipping do PPO e coordena a entropia da política durante o treinamento.
- há 17 dias arxiv.org
EB-JEPA explora modelos de mundo com previsões em embeddings
Publicado em 4 de fevereiro de 2026, o artigo apresenta a EB-JEPA, uma biblioteca open source modular para aprender representações e modelos de mundo com arquiteturas que preveem no espaço de representações, não no de pixels.
- há 17 dias arxiv.org
LoRA como memória de conhecimento: limites para avaliar
Publicado em 3 de março de 2026, o paper analisa adapters LoRA para atualizar o conhecimento de modelos de linguagem e examina capacidade, escalabilidade modular e interferência na mesclagem.
- há 17 dias arxiv.org
Megatron-LM divide modelos entre GPUs para viabilizar o treinamento
Um paper de 2019 da NVIDIA descreve o uso de model parallelism para treinar modelos de linguagem com bilhões de parâmetros, distribuindo os pesos entre GPUs quando não cabem em uma só.
- há 17 dias arxiv.org
Ouroboros testa LoRA condicionada à entrada em transformers recursivos
Publicado em 25 de abril de 2026, o paper explora um controlador compacto que modula um bloco compartilhado de transformer por etapa. No Qwen2.5-3B, relata menor training loss que um baseline de 17 camadas, com ganhos observados in-distribution.
- há 17 dias arxiv.org
RobustMerge consolida MLLMs especialistas sem retreinamento
Publicado em 15 de novembro de 2025, o post descreve um método para combinar modelos multimodais ajustados para tarefas específicas em um modelo multitarefa, sem novo treinamento.
- há 17 dias arxiv.org
SFT com taxas menores pode preservar capacidades gerais
Estudo publicado em 23 de outubro de 2025 relata que taxas de aprendizado menores podem manter capacidades gerais de LLMs sem perder desempenho especializado; também apresenta o método TALR.
- há 17 dias arxiv.org
SHINE gera adapters LoRA a partir de contexto em uma passagem
Publicado em 6 de abril de 2026, o paper apresenta uma hypernetwork que mapeia contextos para adapters LoRA, reutilizando os parâmetros congelados de um LLM.
- há 17 dias arxiv.org
VL-JEPA propõe outra forma de prever texto em tarefas visuais
Artigo publicado em 26 de dezembro de 2025 descreve o VL-JEPA, que prevê embeddings contínuos do texto-alvo e busca priorizar o significado da tarefa, reduzindo a sensibilidade a variações de formulação.
- há 17 dias arxiv.org
ESFT direciona o ajuste fino a experts relevantes em LLMs esparsos
Publicado em 5 de julho de 2024, o paper estuda ajuste fino eficiente em parâmetros para modelos Mixture-of-Experts e apresenta o ESFT, que treina experts selecionados por sua relevância para a tarefa.
- há 17 dias arxiv.org
RLPT usa dados de pré-treinamento para reforço
Publicado em 25 de setembro de 2025, o trabalho apresenta uma forma de aplicar aprendizado por reforço a dados de pré-treinamento, sem novas anotações humanas, e relata ganhos em benchmarks para o Qwen3-4B-Base.
- há 18 dias arxiv.org
Aprendizado contínuo: como avaliar modelos atualizados após o deployment
Uma publicação datada de 29 de setembro de 2026 descreve um modelo 7B atualizado com dados de mercados de previsão e avaliado em backtests contínuos por 390 dias.
- há 18 dias arxiv.org
Como distribuir o reinforcement learning entre camadas de LLMs
Preprint publicado em 15 de julho de 2026, investiga como a adaptação por reinforcement learning se distribui entre camadas transformer durante o post-training de LLMs.
- há 18 dias arxiv.org
Como reduzir divergências entre treino e inferência em RL para LLMs
Um artigo publicado em 30 de junho de 2026 aborda probabilidades inconsistentes entre engines de treino e inferência e descreve TIS e rejeição de checkpoints quando as recompensas divergem.
- há 18 dias arxiv.org
Compressão leve reduz vetores em sistemas ColBERT
Publicado em 8 de julho de 2026, o paper descreve um ajuste fino com consciência de pooling e k-means para reduzir vetores de tokens por documento em modelos ColBERT, sem perda de precisão segundo a publicação.
- há 18 dias arxiv.org
Destilação de LLMs black-box com GAD
Artigo datado de 13 de setembro de 2026 apresenta um método on-policy para destilar modelos usando apenas as respostas textuais de um teacher proprietário.
- há 18 dias arxiv.org
EnvACE ensaia o mundo para treinar agentes
Publicado em 9 de agosto de 2026, o artigo descreve um método de reinforcement learning que substitui interações com ambientes externos por ensaios internos durante o treinamento de agentes.
- há 18 dias arxiv.org
Escala da taxa de aprendizado em LLMs pode ser não linear
Artigo publicado em 30 de junho de 2026 avalia taxas de aprendizado em modelos GPT-2 de 22 milhões a 707 milhões de parâmetros, treinados com 5 bilhões a 100 bilhões de tokens.
- há 18 dias arxiv.org
JEPA-Anything explora aprendizado preditivo em sete domínios
O post, publicado em 6 de outubro de 2026, apresenta o JEPA-Anything como framework agnóstico a domínio para modelagem de mundos, baseado em fatoração preditiva ortogonal.
- há 18 dias arxiv.org
LoRA+ propõe taxas distintas para matrizes adapter
Artigo de 24 de setembro de 2026 analisa como a mesma taxa de aprendizado para as matrizes A e B pode prejudicar o aprendizado de features em modelos largos e propõe usar taxas diferentes no fine-tuning.
- há 18 dias arxiv.org
Mol-JEPA explora dados multimodais para modelos moleculares
Post publicado em 25 de agosto de 2026 relata que o Mol-JEPA aprende com estruturas moleculares, fenótipos celulares e afinidades de ligação, com ganhos fora da distribuição em pequenos conjuntos de dados de ADME.
- há 18 dias huggingface.co
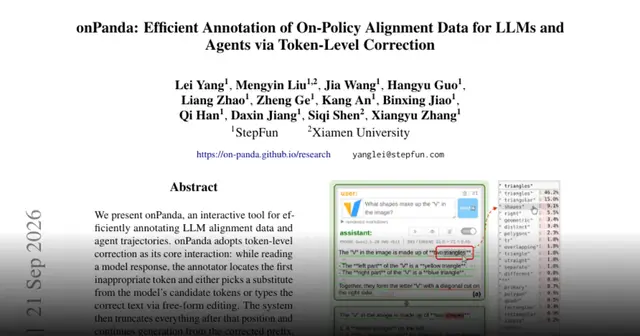
onPanda permite anotar tokens e inspecionar modelos
Publicado em 22 de setembro de 2026, o repositório onPanda apresenta uma ferramenta open source para anotação de dados de LLMs e inspeção de modelos.
- há 18 dias huggingface.co
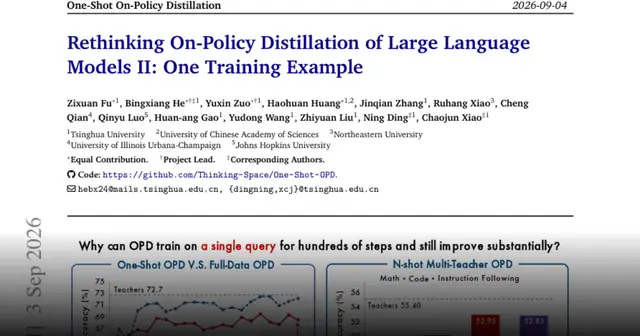
OPD com uma única consulta: o que o paper propõe
Datado de 29 de setembro de 2026, o paper testa destilação on-policy com uma única consulta em matemática, código, seguimento de instruções e uso de ferramentas por agentes.
- há 18 dias arxiv.org
ORPO reúne SFT e alinhamento de preferências em uma etapa
Publicado em 19 de setembro de 2026, o paper apresenta o ORPO, método que combina supervised fine-tuning e otimização de preferências sem um modelo de referência.
- há 18 dias arxiv.org
Paper aponta ganho ao redistribuir capacidade entre camadas
Pesquisa sobre modelos de linguagem relata que uma alocação cossenoidal de capacidade melhorou a perplexidade sem ampliar parâmetros ou FLOPs.
- há 18 dias kawine.github.io
Post-training e adaptação de modelos no mundo real
Slides de uma palestra introdutória, publicados em 21 de agosto de 2026, apresentam métodos de post-training e questões de adaptação para agentes em ambientes mutáveis.
- há 18 dias arxiv.org
PPO e GRPO: escolhas para treinamento de longo horizonte
Um post publicado em 21 de junho de 2026 discute limites de infraestrutura e de redução de variância do GRPO em sequências longas, em comparação com o PPO.
- há 18 dias arxiv.org
Pruning ou treino do zero para LLMs pequenos?
Paper compara seis métodos de pruning do Llama-3.1-8B com treino do zero em dois cenários de orçamento de tokens; a vantagem depende de como o orçamento é contabilizado.
- há 18 dias arxiv.org
QLoRA: fine-tuning de modelo de 65 bilhões em GPU de 48 GB
Paper sobre QLoRA, datado de 20 de setembro de 2026, relata fine-tuning de um modelo de 65 bilhões de parâmetros em uma única GPU de 48 GB, com desempenho preservado em tarefas de ajuste em 16 bits.
- há 18 dias arxiv.org
ResidencyRL explora treino clínico em consultas simuladas
Publicado em 10 de agosto de 2026, o artigo descreve o uso de reinforcement learning em ambientes clínicos simulados para treinar raciocínio além de benchmarks médicos estáticos.
- há 18 dias arxiv.org
RLSD ajusta atualizações de RLVR por token
Paper publicado em 11 de julho de 2026 apresenta um método de treinamento que combina recompensas do ambiente e self-distillation. Em cinco benchmarks de raciocínio multimodal, relata maior acurácia média que o modelo base e o GRPO.
- há 18 dias arxiv.org
RoLA propõe atenção linear de baixo rank para Diffusion Transformers
Publicado em 15 de setembro de 2026, o paper apresenta RoLA, um método que combina atenção linear de baixo rank e posição rotativa para enfrentar gargalos de escalonamento em Diffusion Transformers.
- há 18 dias arxiv.org
SFT em LLMs: como acompanhar efeitos e decidir quando parar
Um artigo publicado em 15 de junho de 2026 analisa por que o ajuste supervisionado pode beneficiar modelos menores, mas produzir efeitos inconsistentes ou prejudiciais em LLMs.
- há 18 dias arxiv.org
TAPA propõe atenção de fase sensível a tokens para contextos longos
Publicado em 26 de junho de 2026, o paper apresenta o Token-Aware Phase Attention (TAPA), um método de positional encoding com função de fase treinável, e o compara ao RoPE em contextos longos.
- há 18 dias arxiv.org
Turn-PPO e treinamento de agentes em múltiplos turnos
Artigo publicado em 21 de junho de 2026 apresenta o Turn-PPO, método de estimativa de vantagem por turno para usar PPO no treinamento por reforço de LLMs agentic, e examina limitações do GRPO em tarefas de longo horizonte.
- há 18 dias arxiv.org
Vocabulary Transfer para melhorar sparse retrieval
Paper de 2 de julho de 2026 atribui o desempenho inferior de encoders avançados em learned sparse retrieval a incompatibilidades entre vocabulários de tokenizers e propõe Vocabulary Transfer.
Vamos avaliar seu projeto

Respondo com escopo e proposta.