


Notícias de IA e infraestrutura
Filtrar por tipo: Pesquisa30
- há 12 dias
 arxiv.org
QwenGyre: RL elástico para treinar agentes de horizonte longo
A Alibaba Qwen apresentou o QwenGyre, um framework de RL elástico que realoca GPUs entre rollout e treinamento e agrupa execuções ramificadas de agentes em árvores de trajetórias com prefixos compartilhados, com speedup relatado de até 1,85× sobre Colocate.
- há 17 dias arxiv.org
Adaptação de modelos à linguagem Q, usada em finanças
Relatório técnico de 9 de janeiro de 2026 apresenta uma abordagem open source para adaptar modelos de linguagem à Q, uma linguagem de programação especializada em finanças quantitativas.
- há 17 dias arxiv.org
Agentes de busca podem verificar evidências contra ruído
Publicado em 28 de outubro de 2025, o paper descreve um agente que define objetivos de busca e verifica se as evidências encontradas os atendem, buscando resistir a pistas enganosas.
- há 17 dias arxiv.org
Auto-destilação pode apoiar aprendizado contínuo sem recompensa
Um post publicado em 16 de fevereiro de 2026 descreve uma técnica de auto-destilação para treinar modelos em novas tarefas sem função de recompensa e com foco em reduzir o esquecimento catastrófico.
- há 17 dias arxiv.org
BAPO busca estabilizar o treinamento off-policy de LLMs
Publicado em 23 de outubro de 2025, o paper apresenta o BAPO, método com otimização balanceada da política e clipping adaptativo para cenários de partial rollout e reaproveitamento de experiências.
- há 17 dias arxiv.org
CogRouter ajusta o raciocínio de agentes por etapa
Publicado em 16 de fevereiro de 2026, o material descreve quatro níveis cognitivos para agentes com LLMs e relata 82,3% de sucesso em benchmarks para um modelo de 7B.
- há 17 dias arxiv.org
Como estabilizar o reinforcement learning com LLMs
Artigo da equipe Qwen, publicado em 16 de dezembro de 2025, aborda instabilidades no reinforcement learning com modelos de linguagem e destaca diferenças entre treinamento e inferência, políticas antigas e novas, importance sampling e routing replay.
- há 17 dias arxiv.org
EditScore aplica reward models à edição de imagens
Post de 25 de outubro de 2025 apresenta uma família de modelos de recompensa para avaliar e orientar edições complexas de imagens, com resultados reportados no EditReward-Bench.
- há 17 dias arxiv.org
JustRL testa RL simples em modelos de raciocínio de 1,5B
Publicado em 4 de janeiro de 2026, o paper descreve treinamento em etapa única, com hiperparâmetros fixos, e relata acurácias médias de 54,9% e 64,3% em dois modelos de raciocínio de 1,5B.
- há 17 dias nature.com
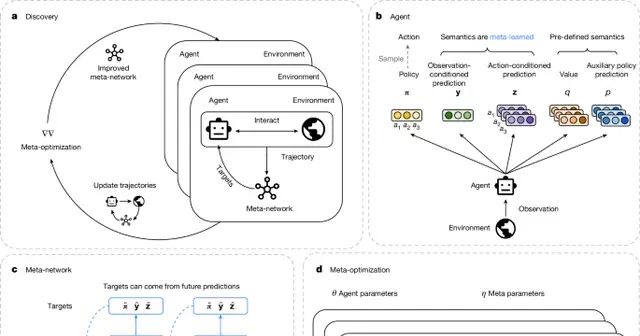
Meta-learning propõe regras de atualização para reinforcement learning
Publicado em 24 de outubro de 2025, o artigo apresenta o DiscoRL, método que aprende regras de atualização de reinforcement learning entre agentes e ambientes e relata resultados de ponta em benchmarks como Atari e ProcGen.
- há 17 dias arxiv.org
Regularização KL em RL pode não seguir a intuição sobre diversidade
Publicado em 24 de outubro de 2025, o artigo analisa regularização por reverse KL e forward KL em reinforcement learning e mostra que a distinção usual entre buscar modos e cobrir massa não necessariamente se aplica.
- há 17 dias arxiv.org
RL multimodal: estabilidade com rollout único
Publicação de 23 de dezembro de 2025 relata que advantage shaping com bônus de entropia estabilizou uma abordagem de rollout único para RL multimodal.
- há 17 dias arxiv.org
SA-RAG explora ativação em grafos para recuperar evidências
Publicado em 20 de dezembro de 2025, o paper apresenta o SA-RAG, que propaga ativação por conexões ponderadas em grafos de conhecimento para recuperar documentos ligados a entidades relevantes.
- há 17 dias arxiv.org
SAR como sinal de recompensa para LLMs
Publicação de 16 de janeiro de 2026 apresenta o Self-Aligned Reward, compatível com PPO e GRPO, para buscar melhor raciocínio com menos tokens.
- há 17 dias arxiv.org
SFT ou ajuste por reforço no pós-treinamento contínuo?
Artigo publicado em 11 de janeiro de 2026 compara SFT e ajuste fino por reforço no pós-treinamento contínuo de modelos fundacionais. Seu título afirma que o ajuste por reforço mitiga naturalmente o esquecimento.
- há 17 dias arxiv.org
Socratic-Zero gera currículos de raciocínio com agentes
Publicado em 28 de outubro de 2025, o paper apresenta um método de geração de dados de raciocínio sem rótulos humanos e relata resultados em sete benchmarks matemáticos.
Trajetórias de especialistas no treinamento de modelos de linguagem
Em 31 de outubro de 2025, uma publicação apresentou um método que usa trajetórias de especialistas para ensinar modelos de linguagem pequenos a raciocinar sobre problemas difíceis.
- há 18 dias arxiv.org
CodeMidas propõe gerar tarefas de RL a partir de código
Em 21 de setembro de 2026, a CodeMidas apresentou um pipeline que converte funcionalidades de projetos open source em ambientes executáveis de aprendizado por reforço para programação.
- há 18 dias arxiv.org
Como avaliar RL assíncrono no pós-treinamento de agentes
Um post publicado em 9 de julho de 2026 aborda RL assíncrono para pós-treinamento de modelos de linguagem, atualizações conforme chegam rollouts e técnicas de estabilidade.
- há 18 dias arxiv.org
Distilação em duas fases para modelos multitarefa
Paper de 30 de junho de 2026 estuda como consolidar especialistas de aprendizado por reforço em um modelo multitarefa usando distilação off-policy e on-policy.
- há 18 dias arxiv.org
DreamSmooth suaviza recompensas esparsas em RL
Apresentado em um paper da ICLR publicado em 28 de junho de 2026, o DreamSmooth aplica suavização temporal às recompensas em model-based RL e foi avaliado em RoboDesk e Shadow Hand.
- há 18 dias arxiv.org
EfficientRollout acelera rollouts de RL para LLMs
Paper de 5 de julho de 2026 descreve speculative decoding autoespeculativo com adaptação ao sistema e relata até 19,6% mais rapidez na geração de rollouts.
- há 18 dias arxiv.org
Informação privilegiada pode afetar raciocínios longos em modelos
Artigo datado de 7 de julho de 2026 relata degradação em trajetórias longas de raciocínio após self-distillation com informação privilegiada, em cinco modelos avaliados no AIME.
- há 18 dias arxiv.org
LED explora camadas intermediárias em modelos de raciocínio
Artigo publicado em 10 de julho de 2026 relata que o Latent Exploration Decoding usa distribuições de camadas intermediárias para ampliar a exploração sem treinamento adicional.
- há 18 dias arxiv.org
LENS combina raciocínio e segmentação de imagens com RL
O artigo apresenta o LENS, um framework que usa aprendizado por reforço para otimizar o raciocínio e a segmentação de imagens a partir de texto.
- há 18 dias arxiv.org
Paper avalia feedback de LLM-as-a-Judge no treinamento
Publicado em 19 de setembro de 2026, o paper estuda o uso do próprio modelo de linguagem para gerar feedback durante o treinamento e compara a abordagem a modelos de recompensa congelados, treinados com preferências humanas.
- há 18 dias arxiv.org
Positional encodings: como comparar alternativas ao RoPE
Estudo publicado em 29 de setembro de 2026 examina o viés do RoPE por tokens próximos e alternativas avaliadas em diferentes configurações.
- há 18 dias arxiv.org
Raciocínio verificado sem atualizar os pesos do modelo
Post publicado em 23 de junho de 2026 propõe manter um modelo de linguagem congelado e recuperar raciocínios verificados de um conjunto externo, com verificação lógica como desafio central.
- há 18 dias arxiv.org
Self-Distillation On-Policy para raciocínio em LLMs
Paper datado de 28 de setembro de 2026 descreve um método de treinamento que combina trajetórias geradas pelo student com supervisão densa de um teacher em cada token.
- há 18 dias github.com
WANDR: ambiente para avaliar busca agentic
Em post publicado em 14 de julho de 2026, a Perplexity afirma disponibilizar um ambiente de avaliação e aprendizado por reforço para busca agentic, sintetizado a partir de traces de produção com supervisão humana fraca.
Vamos avaliar seu projeto

Respondo com escopo e proposta.