


Notícias de IA e infraestrutura
Filtrar por tipo: Pesquisa273
- há 17 dias cdrdv2-public.intel.com
Intel atualiza a especificação AVX10.2 para a versão 6.0
Em post publicado em 11 de março de 2026, a Intel anunciou a versão 6.0 da especificação AVX10.2 e a renomeação de AVX10_VNNI_INT para AVX10_V1_AUX.
- há 17 dias cdrdv2-public.intel.com
Intel publica guia de tuning HPC para Xeon 6
Em 29 de dezembro de 2025, a Intel lançou a versão 1.2a de seu guia de tuning e otimização de aplicações de computação de alto desempenho para sistemas Xeon 6.
Interleaved Head Attention propõe comunicação entre heads
Em post publicado em 11 de abril de 2026, a Interleaved Head Attention explora a comunicação entre attention heads dentro de uma camada, com foco em raciocínio.
- há 17 dias ieeexplore.ieee.org
Inversão de gradientes no Federated Learning: riscos e defesas
Publicado em 16 de janeiro de 2026, o post apresenta um estudo sobre ataques de inversão de gradientes em Federated Learning. O texto afirma que o método de ataque mais prático ainda é pouco confiável e que o trabalho propõe uma defesa em três etapas.
- há 17 dias
 arxiv.org
JustRL testa RL simples em modelos de raciocínio de 1,5B
Publicado em 4 de janeiro de 2026, o paper descreve treinamento em etapa única, com hiperparâmetros fixos, e relata acurácias médias de 54,9% e 64,3% em dois modelos de raciocínio de 1,5B.
KArAt propõe uma atenção learnable sem softmax fixo
Publicado em 27 de outubro de 2025, o paper apresenta a KArAt, uma alternativa learnable à atenção com softmax. Relata resultados mistos em vision transformers e variantes low-rank para reduzir o uso de memória.
Kascade reduz o cálculo de atenção em contextos longos
Publicado em 18 de fevereiro de 2026, o artigo descreve uma técnica que reutiliza resultados de atenção entre camadas Transformer para reduzir trabalho durante a inferência, sem retreinar o modelo ou alterar seus pesos.
LightRetriever reduz o custo da recuperação com LLMs
Post publicado em 5 de março de 2026: o LightRetriever relata consultas codificadas 1.000× mais rápido e throughput 10× maior, mantendo 95% do desempenho nos benchmarks.
Limites geométricos para compressão em RAG
Artigo da NeurIPS 2026 estuda a compressão em RAG pela geometria dos embeddings e afirma que uma grandeza espectral define um limite mínimo para comprimir.
- há 17 dias arxiv.org
LoPA explora lookahead para acelerar inferência de modelos de difusão
Publicado em 11 de janeiro de 2026, o texto apresenta o LoPA, um algoritmo sem treinamento adicional que usa lookahead para escolher a ordem de preenchimento de tokens em modelos de linguagem de difusão.
- há 17 dias arxiv.org
LoRA como memória de conhecimento: limites para avaliar
Publicado em 3 de março de 2026, o paper analisa adapters LoRA para atualizar o conhecimento de modelos de linguagem e examina capacidade, escalabilidade modular e interferência na mesclagem.
Mamba-3 propõe estado fixo para modelar sequências
Publicado em 7 de maio de 2026, o post descreve uma arquitetura de linguagem não Transformer que comprime o contexto em um estado de tamanho fixo e afirma ter decodificação de tempo constante em relação ao comprimento da sequência.
MegaRAG propõe graphs multimodais para RAG
Publicado em 25 de dezembro de 2025, o paper descreve um método que cria automaticamente knowledge graphs a partir de documentos visuais para apoiar retrieval e raciocínio entre modalidades.
- há 17 dias arxiv.org
Megatron-LM divide modelos entre GPUs para viabilizar o treinamento
Um paper de 2019 da NVIDIA descreve o uso de model parallelism para treinar modelos de linguagem com bilhões de parâmetros, distribuindo os pesos entre GPUs quando não cabem em uma só.
- há 17 dias people.freebsd.org
Memória e desempenho: transformar conhecimento em diagnóstico
Publicado em 29 de março de 2026, o artigo de Ulrich Drepper aborda memória para programadores e oferece contexto para engenheiros que investigam comportamento da memória e desempenho.
- há 17 dias arxiv.org
Memória em camadas para agentes de pesquisa prolongada
Um post de 19 de abril de 2026 descreve o Hierarchical Cognitive Caching do ML-Master 2.0, com memória de curto, médio e longo prazo, e relata 56,44% de taxa de medalhas no MLE-Bench após uma execução de 24 horas.
- há 17 dias arxiv.org
MemRL aprende a priorizar memórias de agentes em runtime
A descrição publicada em 13 de janeiro de 2026 apresenta o MemRL, uma abordagem que aprende a utilidade de memórias episódicas sem alterar os pesos do modelo de linguagem.
- há 17 dias nature.com
Meta-learning propõe regras de atualização para reinforcement learning
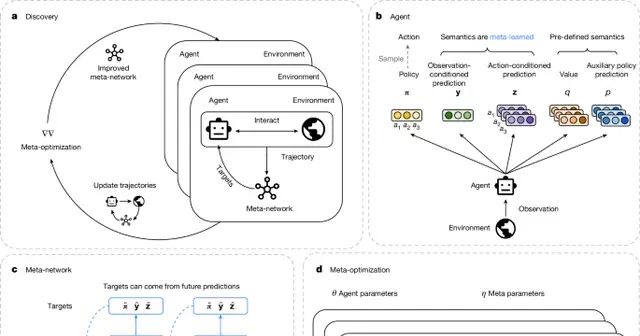
Publicado em 24 de outubro de 2025, o artigo apresenta o DiscoRL, método que aprende regras de atualização de reinforcement learning entre agentes e ambientes e relata resultados de ponta em benchmarks como Atari e ProcGen.
MoDA conecta a atenção entre camadas em LLMs
Publicado em 19 de abril de 2026, o paper apresenta o MoDA, mecanismo que combina pares key-value da camada atual com informações de camadas anteriores.
Modelos de difusão mascarada e a ordem dos tokens
Um artigo do ICML 2025 analisa por que modelos de difusão mascarada têm desempenho inferior em benchmarks de geração e aponta desafios no treinamento com subconjuntos de tokens.
- há 17 dias arxiv.org
Ouroboros testa LoRA condicionada à entrada em transformers recursivos
Publicado em 25 de abril de 2026, o paper explora um controlador compacto que modula um bloco compartilhado de transformer por etapa. No Qwen2.5-3B, relata menor training loss que um baseline de 17 camadas, com ganhos observados in-distribution.
- há 17 dias arxiv.org
PARE-Bench testa agentes proativos em apps com estado
Publicado em 25 de abril de 2026, o paper apresenta 143 tarefas para avaliar agentes que inferem objetivos, escolhem quando intervir e coordenam ações entre aplicativos.
RAG: ampliar documentos pode reduzir a dependência de LLMs maiores
Um paper de pesquisadores da CMU, datado de 14 de janeiro de 2026, avalia ampliar o corpus de recuperação como alternativa a aumentar o modelo. Segundo o post, um modelo médio com mais documentos pode igualar um modelo maior com um corpus menor.
- há 17 dias arxiv.org
ReCode combina planejamento e ação em agentes LLM
Publicado em 13 de dezembro de 2025, o artigo apresenta o ReCode, uma abordagem de geração recursiva de código que permite a agentes LLM alternar entre planejamento estratégico e ações detalhadas.
- há 17 dias arxiv.org
Regularização KL em RL pode não seguir a intuição sobre diversidade
Publicado em 24 de outubro de 2025, o artigo analisa regularização por reverse KL e forward KL em reinforcement learning e mostra que a distinção usual entre buscar modos e cobrir massa não necessariamente se aplica.
- há 17 dias arxiv.org
RL multimodal: estabilidade com rollout único
Publicação de 23 de dezembro de 2025 relata que advantage shaping com bônus de entropia estabilizou uma abordagem de rollout único para RL multimodal.
- há 17 dias arxiv.org
RobustMerge consolida MLLMs especialistas sem retreinamento
Publicado em 15 de novembro de 2025, o post descreve um método para combinar modelos multimodais ajustados para tarefas específicas em um modelo multitarefa, sem novo treinamento.
RouteRAG adapta buscas em texto e grafos durante o raciocínio
Publicado em 15 de dezembro de 2025, o material descreve um framework de RAG que usa aprendizado por reforço para escolher buscas e penaliza retrieval desnecessário.
- há 17 dias arxiv.org
SA-RAG explora ativação em grafos para recuperar evidências
Publicado em 20 de dezembro de 2025, o paper apresenta o SA-RAG, que propaga ativação por conexões ponderadas em grafos de conhecimento para recuperar documentos ligados a entidades relevantes.
- há 17 dias arxiv.org
SAR como sinal de recompensa para LLMs
Publicação de 16 de janeiro de 2026 apresenta o Self-Aligned Reward, compatível com PPO e GRPO, para buscar melhor raciocínio com menos tokens.
- há 17 dias arxiv.org
SFT com taxas menores pode preservar capacidades gerais
Estudo publicado em 23 de outubro de 2025 relata que taxas de aprendizado menores podem manter capacidades gerais de LLMs sem perder desempenho especializado; também apresenta o método TALR.
- há 17 dias arxiv.org
SFT ou ajuste por reforço no pós-treinamento contínuo?
Artigo publicado em 11 de janeiro de 2026 compara SFT e ajuste fino por reforço no pós-treinamento contínuo de modelos fundacionais. Seu título afirma que o ajuste por reforço mitiga naturalmente o esquecimento.
- há 17 dias arxiv.org
SHINE gera adapters LoRA a partir de contexto em uma passagem
Publicado em 6 de abril de 2026, o paper apresenta uma hypernetwork que mapeia contextos para adapters LoRA, reutilizando os parâmetros congelados de um LLM.
- há 17 dias tugraz.elsevierpure.com
Side channel de SSD no navegador pode revelar atividade
Artigo publicado em 29 de maio de 2026 relata que medições de latência do SSD pelo Origin Private File System podem identificar sites visitados e detectar aplicativos desktop iniciados.
Skill-RAG adapta a recuperação a lacunas de conhecimento detectadas
Publicado em 20 de abril de 2026, o paper apresenta um método que detecta possíveis falhas de conhecimento e encaminha consultas para estratégias especializadas de recuperação. A avaliação foi feita em HotpotQA, Natural Questions e TriviaQA.
- há 17 dias arxiv.org
Socratic-Zero gera currículos de raciocínio com agentes
Publicado em 28 de outubro de 2025, o paper apresenta um método de geração de dados de raciocínio sem rótulos humanos e relata resultados em sete benchmarks matemáticos.
- há 17 dias arxiv.org
StructMem propõe memória temporal hierárquica para agentes
Publicado em 24 de abril de 2026, o paper StructMem propõe uma memória hierárquica para agentes conversacionais de longo prazo, com relações entre eventos voltadas a raciocínio temporal e perguntas multi-hop.
- há 17 dias arxiv.org
TACO propõe compressão de contexto para agents de terminal
O paper descreve um framework que aprende regras de compressão de contexto a partir de interações de agents de terminal e relata testes em três benchmarks.
Tensor Product Attention propõe reduzir a memória do cache KV
Publicado em 27 de outubro de 2025, o artigo apresenta uma técnica de atenção com componentes contextuais de baixo rank para reduzir o consumo de memória do cache KV durante a inferência.
Trajetórias de especialistas no treinamento de modelos de linguagem
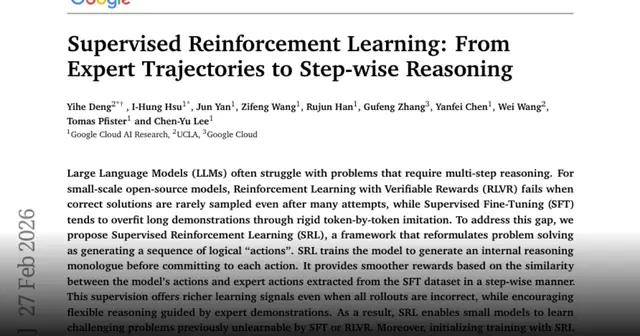
Em 31 de outubro de 2025, uma publicação apresentou um método que usa trajetórias de especialistas para ensinar modelos de linguagem pequenos a raciocinar sobre problemas difíceis.
Vamos avaliar seu projeto

Respondo com escopo e proposta.