


Notícias de IA e infraestrutura
Filtrar por tipo: Artigo292
- há 17 dias fgiesen.wordpress.com
Operações atômicas em sistemas com caches coerentes
Publicado em 3 de março de 2026, o artigo de Fabian Giesen aborda primitivas para construir sistemas sobre caches coerentes e dá sequência a um texto sobre como funciona a coerência de cache.
- há 17 dias eli.thegreenplace.net
Ordem de bibliotecas na linkedição estática
Em artigo publicado em 1º de março de 2026, Eli Bendersky aborda como a ordem das bibliotecas afeta a linkedição estática e pode ajudar a diagnosticar falhas.
Otimização de kernels GPU além das tabelas de latência SASS
Post de 25 de novembro de 2025 questiona a utilidade de tabelas de latência SASS extraídas pelo nvdisasm e aponta ganhos de 3–4% com reordenação de instruções, diante de um limite teórico de 10%.
- há 17 dias siboehm.com
Otimização iterativa de multiplicação de matrizes em CUDA
Em artigo publicado em 26 de fevereiro de 2026, Simon Boehm descreve a otimização de um kernel CUDA para se aproximar do desempenho do cuBLAS, sem pretender substituí-lo.
- há 17 dias lore.kernel.org
Patch propõe fila MPSC sem locks para o io_uring
Publicado em 11 de junho de 2026, o patch propõe uma fila FIFO lockless de múltiplos produtores e um consumidor para o io_uring do kernel Linux.
- há 17 dias cpppatterns.com
Patterns de C++ moderno como referência para equipes
O repositório comunitário C++ Patterns reúne padrões de código idiomático em C++ moderno para consulta por engenheiros. Veja como transformar referências de código em práticas internas.
- há 17 dias modernescpp.com
Patterns de software em C++: do conceito à arquitetura
Publicado em 24 de maio de 2026, o artigo apresenta uma visão inicial de design patterns e architectural patterns em C++, como ponto de partida para engenheiros explorarem padrões de design de software.
- há 17 dias videocardz.com
PC compacto da FEVM combina Core Ultra 300, 10GbE e três slots M.2
Em artigo publicado em 7 de março de 2026, a FEVM informa que prepara um PC ultrafino com processador Intel Core Ultra 300, rede 10GbE e três slots M.2. A configuração pode ser avaliada para instalações compactas que exigem rede rápida e vários SSDs NVMe.
- há 17 dias turingpost.com
Pesquisa em IA destaca memória e tarefas longas em agentes
Um roundup semanal publicado em 21 de abril de 2026 reúne pesquisas sobre design de agentes, execução de tarefas de longo prazo, transferência de memória em agentes de programação e destilação.
Pointer Compression no V8: heap até 43% menor
Artigo do V8, publicado em 1º de março de 2026, explica como a compressão de ponteiros pode reduzir em até 43% o tamanho do heap em uma engine JavaScript de produção.
- há 17 dias fgiesen.wordpress.com
Por que CPUs têm vários níveis de cache — e o que isso muda
Em artigo publicado em 27 de fevereiro de 2026, Fabian Giesen explora por que CPUs têm vários níveis de cache, assunto relevante para engenheiros que analisam desempenho.
Post aponta riscos em extração de dados judiciais e automação
Publicado em 17 de maio de 2026, o post alega que uma ferramenta extrai processos judiciais, enriquece dados com informações da Serasa e envia mensagens pelo WhatsApp. Também menciona licenciamento por HWID e contato com servidor central a cada 30 segundos.
Praetorian usa agentes de IA para gerar templates Nuclei de detecção de CVEs
A Praetorian descreve um pipeline multiagente que transforma pesquisas de CVEs em templates Nuclei validados, com agentes especializados e um ciclo de refinamento actor-critic.
- há 17 dias storagereview.com
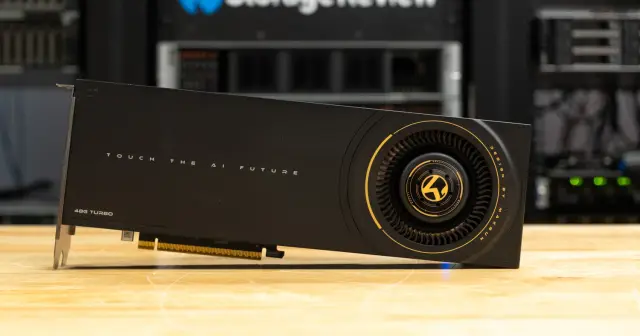
Preview do Battlematrix aponta 192 GB de memória GPU
Em 1º de dezembro de 2025, a StorageReview apresentou o Intel Project Battlematrix, um design de workstation com múltiplas GPUs e 192 GB de memória GPU para IA local.
- há 17 dias cnx-software.com
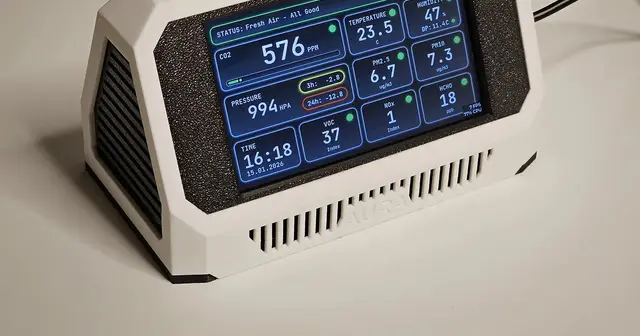
Project Aura: monitor de qualidade do ar com ESP32-S3
Projeto publicado em 16 de fevereiro de 2026 combina sensores ambientais, touchscreen e integração com Home Assistant em um monitor DIY baseado em ESP32-S3.
- há 17 dias blog.fal.ai
Quantização MXFP8 no B200 supera 6 TB/s
Post publicado em 27 de janeiro de 2026 descreve um quantizer MXFP8 em CuTeDSL para B200 que supera 6 TB/s ao gravar fatores de escala diretamente no layout compactado.
- há 17 dias guysrd.github.io
Race de use-after-free no epoll e correção com RCU
Post publicado em 26 de maio de 2026 descreve uma race em fs/eventpoll.c e a alteração que adiou a liberação de memória com RCU.
- há 17 dias fbb-git.gitlab.io
Referência ampla de C++ pode apoiar padrões internos
Publicado em 30 de maio de 2026, o livro de Frank B. Brokken reúne mais de 1.100 páginas sobre diversos tópicos de C++, e é descrito como atualizado.
- há 17 dias zeltser.com
REMnux integra agentes de IA a mais de 200 ferramentas de malware
Publicado em 9 de fevereiro de 2026, o artigo descreve um servidor MCP que conecta agentes de IA às ferramentas do REMnux e fornece orientação para escolhê-las e interpretar resultados.
- há 17 dias david.alvarezrosa.com
Ring buffer SPSC: sincronização e cache
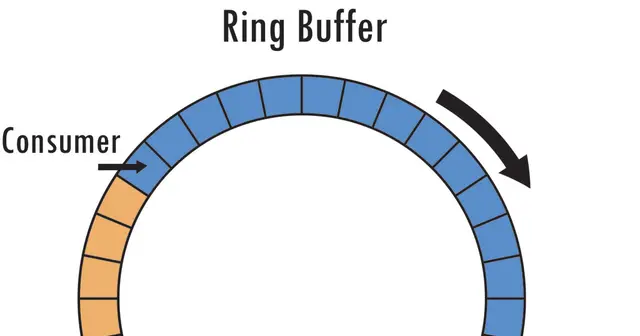
Artigo de 28 de março de 2026 analisa a otimização de um ring buffer SPSC, comparando mutexes, atomics e ajustes para reduzir a contenção de cache.
- há 17 dias
 hgpu.org
RL agentic para gerar kernels CUDA de alto desempenho
Post de 4 de março de 2026 apresenta o CUDA Agent, sistema de reinforcement learning agentic em larga escala para gerar kernels CUDA, uma tarefa que exige conhecimento especializado de hardware.
RL em sistemas de treinamento: desafios e resultados de pass@k
Artigo publicado em 21 de dezembro de 2025 reúne desafios de rollouts em treinamento por RL e resultados variados sobre desempenho pass@k.
- há 17 dias hgpu.org
RL online para geração de código HPC com benchmarks reais
Artigo publicado em 15 de fevereiro de 2026 descreve o uso de aprendizado por reforço online, recompensado por benchmarks em máquinas reais, para melhorar a geração de código HPC. O desempenho em execução do código gerado não é garantido.
RLHF em GPUs AMD: implantação com ROCm 7.0
Artigo da AMD, publicado em 2 de março de 2026, descreve o uso de verl para treinamento de RLHF em GPUs AMD, com otimizações para ROCm e scripts Docker, e apresenta resultados de throughput e convergência.
- há 17 dias huggingface.co
RoPE e decisões de arquitetura de modelos
Publicação de 12 de abril de 2026 apresenta um artigo como explicação de rotary positional embeddings (RoPE), voltada a engenheiros que estudam codificação posicional.
- há 17 dias videocardz.com
Seasonic anuncia fonte CRPS de 5.200 W para a Computex 2026
Em 28 de maio de 2026, a Seasonic informou que planeja apresentar na Computex 2026 uma fonte CRPS de 5.200 W com certificação 80 PLUS Ruby.
Sequential Attention propõe modelos mais enxutos
Em 9 de fevereiro de 2026, o Google Research apresentou a Sequential Attention, abordagem que seleciona recursos ou camadas durante o treinamento para buscar modelos mais rápidos e enxutos sem sacrificar a precisão.
- há 17 dias eprint.iacr.org
SHA-2: ataques de colisão chegam a 39 etapas
Um artigo publicado em 2 de junho de 2026 relata um procedimento aprimorado de busca para colisões em SHA-2 e situa o avanço diante de resultados anteriores de até 37 etapas.
- há 17 dias mcyoung.xyz
SIMD e Base64: como avaliar otimizações em processamento
Publicado em 7 de março de 2026, o artigo aborda o projeto de um algoritmo SIMD do zero, com foco em Base64, e apresenta um exemplo para engenheiros.
- há 17 dias cnx-software.com
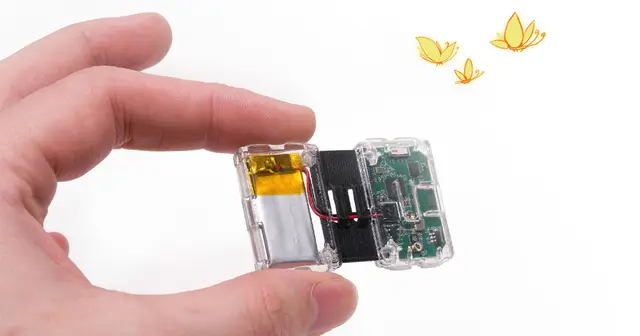
SlimeVR Butterfly combina IMU e rádio de baixo consumo
Publicado em 12 de fevereiro de 2026, o relato sobre os trackers open-hardware SlimeVR Butterfly descreve o uso de IMUs, do MCU nRF52833 e de um protocolo personalizado de 2,4 GHz para transmitir dados de movimento.
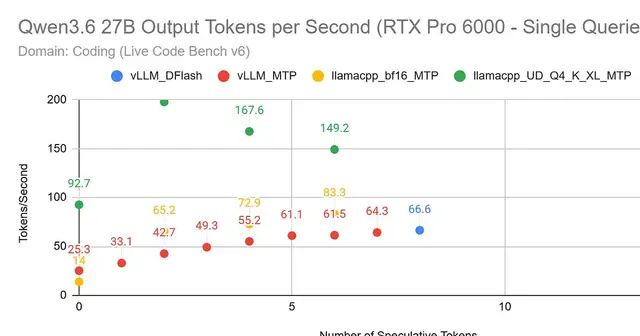
Speculative decoding: desempenho varia por modelo
Artigo publicado em 3 de junho de 2026 compara DFlash e MTP com vLLM e llama.cpp em matemática, programação e chat. Os resultados variam conforme o modelo e a carga de trabalho.
- há 17 dias wccftech.com
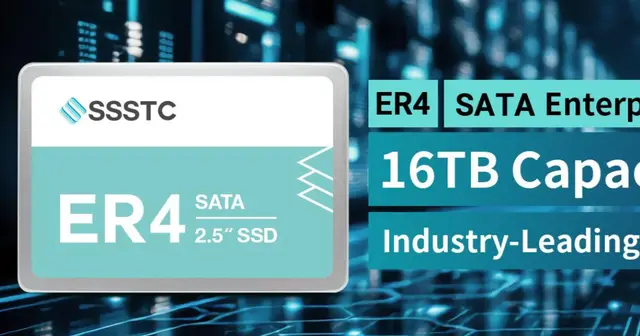
SSSTC apresenta SSDs SATA ER4 de até 16 TB
Em 27 de novembro de 2025, a SSSTC apresentou a linha de SSDs SATA corporativos ER4, com capacidades de até 16 TB e desempenho de até 98 mil IOPS.
- há 17 dias eli.thegreenplace.net
Stack frames em x86-64: aplicações para depuração
Artigo de Eli Bendersky, publicado em 2 de março de 2026, sobre como chamadas de função usam a stack em x86-64 e como se organiza um stack frame.
- há 17 dias khronos.org
Subgroups no Vulkan 1.1: paralelismo na GPU
Em tutorial publicado em 4 de março de 2026, a Khronos explica como subgroups no Vulkan 1.1 permitem compartilhar e manipular dados entre tarefas paralelas na GPU.
- há 17 dias servethehome.com
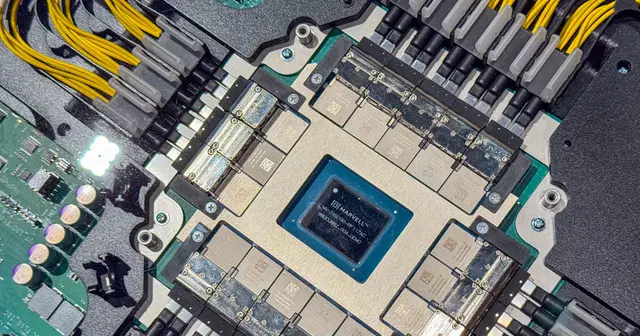
Switch CPO com refrigeração líquida: implicações para redes
A ServeTheHome relata a demonstração do switch CPO TX9190 da Marvell, com refrigeração líquida, na OCP 2025, em 21 de outubro de 2025.
- há 17 dias videocardz.com
TCL anuncia monitor OLED+ 4K de 240 Hz
Em 5 de março de 2026, a TCL anunciou o monitor 32X3A, com painel OLED+, resolução 4K, taxa de atualização de 240 Hz e design ultrafino.
- há 17 dias wccftech.com
TDIMM DDR5: como avaliar memória de alta capacidade
A Tachyum anunciou um padrão open source de memória TDIMM DDR5. A página vinculada menciona até 1 TB por DIMM e largura de banda de 231 GB/s, números que podem orientar avaliações de arquitetura.
- há 17 dias ithome.com
TDIMM DDR5: memória aberta para cargas de IA
Em post publicado em 26 de novembro de 2025, a Tachyum anunciou a tecnologia TDIMM de código aberto, compatível com DDR5, e declarou bandwidth de 281 GB/s, módulos de até 1 TB e nós de até 3 PB.
- há 17 dias huggingface.co
Técnicas para otimizar inferência de Transformers
Um post publicado em 24 de dezembro de 2025 descreve técnicas de inferência de Transformers: quantização MXFP4, paralelismo de tensores e especialistas e janelas deslizantes dinâmicas.
Técnicas para tornar o serving de LLMs mais eficiente
Notas de aula publicadas em 13 de maio de 2026 abordam quantização, sparsity, atenção, speculative decoding e batching para melhorar a inferência e o serving de LLMs.
Vamos avaliar seu projeto

Respondo com escopo e proposta.