


Notícias de IA e infraestrutura
Filtrar por tipo: Pesquisa273
- há 18 dias arxiv.org
FIBER propõe separar registradores da execução na GPU
Publicado em 21 de agosto de 2026, o artigo apresenta uma arquitetura de GPU que desacopla a propriedade de registradores das instâncias de execução paralela.
Filtragem de contexto na atenção para hardware limitado
Artigo da SAS, publicado em 16 de setembro de 2026, descreve um seletor treinado de ponta a ponta dentro do Softmax para filtrar contexto em mecanismos de atenção voltados a hardware com recursos computacionais limitados.
FlashAttention-3: otimização de attention em GPUs Hopper
O artigo, publicado em 24 de setembro de 2026, apresenta técnicas de execução assíncrona e baixa precisão para acelerar attention em GPUs Hopper, com foco em tráfego de memória e uso do hardware.
FlowTracer rastreia tokens influentes no raciocínio de LLMs
Publicado em 4 de julho de 2026, o artigo apresenta um método que usa atenção para rastrear a propagação de informação e direcionar a atribuição de crédito no treinamento por reforço.
Gated Linear Attention: atenção linear com gates
Publicado em 20 de setembro de 2026, o artigo apresenta uma formulação de transformer com atenção linear e gates dependentes dos dados, expressável também como uma RNN com estados ocultos matriciais.
- há 18 dias
 arxiv.org
Git como memória compartilhada para agentes de pesquisa
Um post publicado em 17 de setembro de 2026 descreve agentes que registram contribuições verificáveis em um histórico Git pesquisável, para compartilhar resultados e reduzir experimentos repetidos.
GOAT propõe priors treináveis para a attention
Publicado em 3 de outubro de 2026, o paper interpreta a attention padrão como um problema de transporte ótimo entrópico com prior uniforme implícito e apresenta o GOAT, com prior contínuo e treinável.
- há 18 dias arxiv.org
GPU-Tile-Sim propõe simulação de GPU para co-design de LLMs
Publicado em 14 de julho de 2026, o paper propõe um framework de simulação de GPU baseado em tiles para apoiar o co-design de hardware e software de LLMs.
Gradientes BF16 crescem no fim do treinamento
Um artigo relata aumento de 1.000 vezes na norma do gradiente após 25 bilhões de tokens em um transformer treinado com FlashAttention-3 em BF16.
GraphRAG para perguntas sobre coleções de documentos
Paper publicado em 24 de setembro de 2026 apresenta uma abordagem para responder a perguntas globais sobre um corpus, que a recuperação padrão de trechos pode não atender bem.
- há 18 dias arxiv.org
HarnessBank: evolução de harnesses de agentes
Artigo publicado em 17 de julho de 2026 descreve um método para melhorar agentes alterando prompts, ferramentas e loops de controle ao redor do modelo.
- há 18 dias arxiv.org
HASTE mostra como organizar skills para agentes de ML
O material sobre HASTE relata que, em oito competições, o carregamento hierárquico de skills alcançou 100% de medalhas, ante 62,5% com carregamento plano.
HiLS aprende a selecionar chunks para sparse attention
Publicado em 7 de julho de 2026, o artigo apresenta a HiLS, uma abordagem que aprende a selecionar chunks para sparse attention com a loss de modelagem de linguagem.
HOLA combina atenção linear com cache KV exato e limitado
Publicado em 3 de julho de 2026, o artigo apresenta o HOLA: uma arquitetura que combina estado recorrente e cache limitado de key-values, com ganhos relatados em perplexidade e recall de longo alcance.
HOLA combina estado recorrente e cache limitado para contextos longos
Post de 6 de julho de 2026 descreve o HOLA, que usa estado recorrente e um pequeno KV cache para memória exata. O método reduz a perplexidade em 16,1% e mantém recuperação robusta em 32 mil tokens.
HySparse2 reduz custo de contexto longo com reuso de KV
Publicado em 23 de setembro de 2026, o post descreve dois níveis de compartilhamento de KV para reduzir FLOPs de prefill e tamanho do cache, com melhores scores de retrieval que o Hybrid SWA do MiMo-V2.6 em contexto de 1 milhão de tokens.
iLLaDA: difusão mascarada em um modelo de 8B
Descrição publicada em 25 de junho de 2026 apresenta o iLLaDA, modelo de linguagem de difusão mascarada de 8B treinado do zero com atenção totalmente bidirecional.
- há 18 dias arxiv.org
Informação privilegiada pode afetar raciocínios longos em modelos
Artigo datado de 7 de julho de 2026 relata degradação em trajetórias longas de raciocínio após self-distillation com informação privilegiada, em cinco modelos avaliados no AIME.
- há 18 dias cdrdv2-public.intel.com
Intel atualiza paper sobre proteções de memória
Em 1º de julho de 2026, a Intel atualizou o paper técnico sobre proteções de memória da arquitetura Intel para confidential computing, documento 869103.
Interpretabilidade além dos conceitos humanos
Publicado em 22 de setembro de 2026, o paper investiga se modelos de linguagem usam representações internas que não correspondem adequadamente a conceitos humanos familiares.
IO Factory e a detecção de campanhas de influência adaptativas
Artigo publicado em 12 de agosto de 2026 descreve um framework de IA que simula campanhas coordenadas e adaptáveis, e aponta desafios para detectar esse tipo de atividade.
Jamba combina Transformer, Mamba e MoE
O artigo, publicado em 20 de setembro de 2026, descreve uma arquitetura híbrida que intercala blocos Transformer e Mamba e usa mixture-of-experts em algumas camadas.
- há 18 dias arxiv.org
JAZ explora agentes com uma única primitiva de código
Publicado em 26 de setembro de 2026, o post descreve o framework JAZ e relata resultados em StuLife e AppWorld, com custos menores que os das abordagens comparadas.
- há 18 dias arxiv.org
JEPA-Anything explora aprendizado preditivo em sete domínios
O post, publicado em 6 de outubro de 2026, apresenta o JEPA-Anything como framework agnóstico a domínio para modelagem de mundos, baseado em fatoração preditiva ortogonal.
- há 18 dias arxiv.org
JetSpec acelera speculative decoding com draft trees paralelas
Post publicado em 7 de julho de 2026 descreve o JetSpec, que usa um único forward pass para gerar draft trees coerentes e relata ganhos de até 9,64× no MATH-500 e 4,58× em conversas abertas.
- há 18 dias arxiv.org
JIT-Agent adapta harnesses de agentes à tarefa
O artigo sobre o JIT-Agent descreve a síntese sob demanda e a evolução de harnesses para agentes baseados em LLMs, com módulos de memória, planejamento, ações e ferramentas. Publicado em 27 de agosto de 2026.
KATA explora spherical packing para recall em linear attention
Artigo publicado em 16 de setembro de 2026 apresenta KATA, uma abordagem geométrica que formula o associative recall em linear attention como um problema de spherical packing.
KbSD propõe calibrar decisões de busca em agentes
Publicado em 30 de junho de 2026, o paper descreve um método de self-distillation para orientar agentes de busca entre usar a memória do modelo, evidências recuperadas ou abster-se.
KITE amplia Transformers sem aumentar o cálculo de KV
Publicado em 29 de setembro de 2026, o material descreve o KITE, uma abordagem que amplia componentes do decoder reutilizando um KV cache gerado por um prefiller menor.
- há 18 dias aclanthology.org
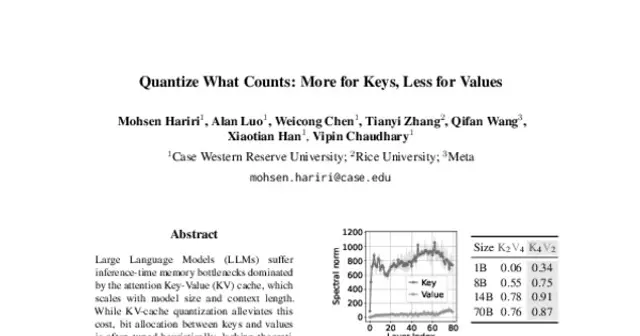
KV cache: mais bits para keys que para values
Artigo da ACL 2026 examina a compressão do KV cache e relata que usar 4 bits para keys e 2 para values pode funcionar bem, enquanto inverter essa distribuição degrada bastante a precisão.
- há 18 dias arxiv.org
LED explora camadas intermediárias em modelos de raciocínio
Artigo publicado em 10 de julho de 2026 relata que o Latent Exploration Decoding usa distribuições de camadas intermediárias para ampliar a exploração sem treinamento adicional.
- há 18 dias arxiv.org
LENS combina raciocínio e segmentação de imagens com RL
O artigo apresenta o LENS, um framework que usa aprendizado por reforço para otimizar o raciocínio e a segmentação de imagens a partir de texto.
LoopCD aproveita loops anteriores na decodificação
Publicado em 2 de outubro de 2026, o artigo apresenta o LoopCD, método sem treinamento que usa representações de loops anteriores para orientar a seleção de tokens em Looped Transformers.
Looped flows treinam atualizações recorrentes com denoising local
Paper publicado em 12 de setembro de 2026 propõe objetivos de denoising local para treinar atualizações recorrentes do estado oculto, inclusive quando o backpropagation cobre poucas etapas.
- há 18 dias arxiv.org
LoRA+ propõe taxas distintas para matrizes adapter
Artigo de 24 de setembro de 2026 analisa como a mesma taxa de aprendizado para as matrizes A e B pode prejudicar o aprendizado de features em modelos largos e propõe usar taxas diferentes no fine-tuning.
Mamba e Transformers: uma conexão por trás das arquiteturas
Artigo publicado em 24 de setembro de 2026 explora conexões teóricas entre modelos de espaço de estados, como Mamba, e variantes de attention.
MaxSim e a capacidade de representar produtos internos
Um artigo datado de 8 de julho de 2026 mostra que MaxSim pode replicar exatamente produtos internos entre vetores não negativos k-esparsos, oferecendo uma base teórica para sistemas de recuperação com late interaction.
Megalodon e a avaliação de sequências longas
Artigo publicado em 24 de setembro de 2026 apresenta uma arquitetura baseada no Mega, projetada para pré-treinamento e inferência eficientes com contexto ilimitado.
- há 18 dias arxiv.org
MemoHarness adapta agentes com histórico de execuções
Publicado em 17 de julho de 2026, o trabalho apresenta um método que ajusta seis dimensões do harness de agentes usando execuções anteriores. Em um benchmark de agentes de shell, obteve 0,806, ante 0,722 do baseline fixo mais forte.
- há 18 dias arxiv.org
Memória de agentes com modelo congelado
Em post publicado em 26 de agosto de 2026, a Recuris descreve dois loops de memória e um meta-agente fixo que propõe reparos com base nos traces de execução, sem alterar os pesos do modelo.
Vamos avaliar seu projeto

Respondo com escopo e proposta.