


Notícias de IA e infraestrutura
- Voz: TTS e ASRModelo
Fala multilíngue: como avaliar o FireRedTTS 2
Publicado em 17 de setembro de 2025, o artigo apresenta um modelo aberto de síntese de fala com suporte a conversas longas, clonagem de voz multilíngue e geração de baixa latência.
- Voz: TTS e ASRPublicação
FireRedChat: voz full-duplex para assistentes
Post de 7 de outubro de 2025 descreve um sistema modular de interação por voz com modos em cascata e semicascata, interrupções, detecção de fim de fala e respostas em tempo real.
- RAG e recuperação de contextoPublicação
Framework da Baidu torna RAG mais rastreável
Post da Baidu, publicado em 30 de julho de 2024, descreve um framework que avalia documentos recuperados, seleciona evidências e analisa trajetórias de raciocínio antes de responder.
- Treino e fine-tuningPublicação
GEPA para detectar código malicioso gerado por IA
Publicação de 5 de outubro de 2025 relata que prompts encontrados com GEPA detectaram comportamento malicioso em código gerado por IA, bloqueando 90% das submissões maliciosas com 1% do orçamento de auditoria.
- Atenção e arquitetura de modelosPesquisa
Gradiente descendente visto como atenção a exemplos
Artigo publicado em 6 de fevereiro de 2023 interpreta camadas lineares treinadas por gradiente como memórias de exemplos e descreve previsões como atenção não normalizada sobre a experiência de treino.
- RAG e recuperação de contextoPublicação
Graphiti: grafos temporais para dados em evolução
Publicado em 10 de dezembro de 2024, o projeto Graphiti descreve grafos de conhecimento dinâmicos que representam relações entre entidades ao longo do tempo e oferecem diferentes métodos de busca.
- Atenção e arquitetura de modelosPublicação
Grokking em adição modular: três etapas até generalizar
Post de 4 de outubro de 2025 descreve um artigo que propõe três etapas para o grokking em adição modular e um limiar de dados próximo a n log n, com weight decay e largura moderada favorecendo o aprendizado de features.
- Treino e fine-tuningArtigo
Post-training de LLMs: métodos e avaliação
Guia publicado em 12 de outubro de 2025 sobre adaptação de LLMs: de previsão de tokens a seguimento de instruções, com métodos de treino e avaliação.
- HardwarePublicação
High Bandwidth Flash: o que avaliar antes de 2026
Em artigo publicado em 12 de outubro de 2025, a SanDisk propõe uma memória baseada em NAND com capacidade de 8 a 16 vezes a da HBM. As primeiras amostras são esperadas para o segundo semestre de 2026.
- Voz: TTS e ASRProjeto
Hibiki: tradução de fala em streaming
Repositório publicado em 6 de fevereiro de 2025 apresenta um modelo decoder-only para tradução simultânea de fala entre francês e inglês, treinado com dados sintéticos.
- RAG e recuperação de contextoPublicação
HijackRAG expõe riscos em sistemas RAG
Publicado em 1º de dezembro de 2024, o post descreve um ataque que usa textos injetados, desvio de atenção e instruções para manipular respostas de sistemas RAG.
- SegurançaPesquisa
HPAC-IDS: detecção de intrusões com atenção hierárquica
Artigo publicado em 14 de janeiro de 2025 descreve um método que analisa segmentos de pacotes de rede e relata resultados promissores no CIC-IDS2017.
- Inferência de LLMsPublicação
Inferência concorrente de Llama 3.1 8B em uma RTX 3090
Post da Backprop, publicado em 16 de agosto de 2024, relata desempenho razoável em um benchmark com mais de 100 requisições simultâneas em uma única GPU.
- Inferência de LLMsPublicação
Inferência por camadas em GPUs com memória limitada
Em 25 de setembro de 2024, a publicação do AirLLM descreveu inferência que carrega uma camada do Transformer por vez a partir do disco, além de quantização em blocos e suporte à compressão.
- Inferência de LLMsPesquisa
InfLLM-V2 alterna atenção densa e esparsa
Publicado em 13 de outubro de 2025, o artigo apresenta um sistema de atenção alternável entre densa e esparsa, voltado a sequências curtas e longas.
- SegurançaArtigo
Internals do V8: segurança de navegadores em foco
Publicado em 20 de abril de 2025, o artigo inicia uma série de três partes sobre internals e exploração do Chrome, apresentando o V8 e os internals de JavaScript.
- Inferência de LLMsPublicação
Jamba 1.5: contexto de 256 mil tokens e avaliação de inferência
Em 22 de agosto de 2024, a AI21 Labs anunciou os modelos Jamba 1.5 Mini e Large, com arquitetura que combina Mamba e Joint Attention, contexto de 256 mil tokens e recursos como ExpertInt8 e saída JSON.
- Treino e fine-tuningPublicação
JEPA-SCORE estima densidade com encoders JEPA
Estudo publicado em 8 de outubro de 2025 apresenta uma forma de estimar probabilidades de amostras usando o Jacobiano do encoder, sem retreinamento.
- CUDA e programação de GPUArtigo
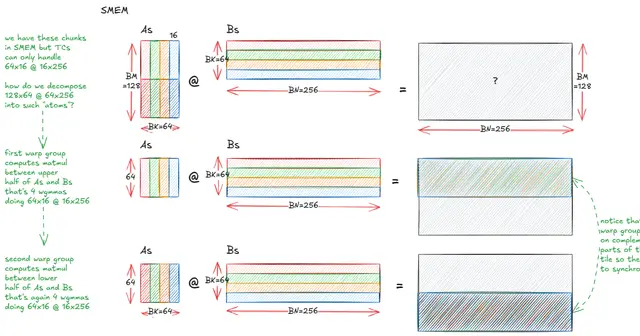
Kernels de multiplicação de matrizes em GPUs NVIDIA
Artigo publicado em 1º de outubro de 2025 sobre arquitetura de GPUs e técnicas de kernels para acelerar multiplicações de matrizes.
- RAG e recuperação de contextoPublicação
LazyGraphRAG combina busca vetorial e em grafos
Post de 29 de novembro de 2024 descreve uma abordagem que combina RAG vetorial com buscas breadth-first e best-first, sem sumarizar o índice.
- RAG e recuperação de contextoPesquisa
LightRAG combina grafos e recuperação em dois níveis
Descrição publicada em 13 de outubro de 2024 apresenta um framework de RAG que combina indexação de texto baseada em grafos com recuperação de baixo e alto nível para informações específicas de entidades e conceitos.
- HardwareProjeto
Linux-insides atualiza capítulo sobre a inicialização do kernel
Em 24 de setembro de 2025, o projeto linux-insides atualizou o quarto capítulo sobre a inicialização do kernel Linux para abordar versões modernas.
- Inferência de LLMsProjeto
LLM Compressor reúne técnicas para comprimir modelos usados com vLLM
Em post publicado em 16 de agosto de 2024, a Neural Magic apresentou uma biblioteca com técnicas de compressão que buscam reduzir a latência de inferência mantendo a precisão.
- Treino e fine-tuningPublicação
LoRA adapta um MLP com cerca de 9 mil parâmetros treináveis
Publicado em 30 de julho de 2024, o exemplo aplica LoRA a um MLP de 5 milhões de parâmetros para classificação e compara o desempenho com o adapter ativado e desativado.
- Treino e fine-tuningPublicação
LoRA em fine-tuning de reinforcement learning
Post da Thinky Machines, publicado em 29 de setembro de 2025, descreve configurações de LoRA para fine-tuning em reinforcement learning e afirma que rank 1 pode igualar o desempenho do fine-tuning completo quando bem configurado.
- Voz: TTS e ASRPesquisa
MaskGCT: síntese de fala com clonagem de voz zero-shot
Publicado em 24 de outubro de 2024, o artigo sobre o MaskGCT apresenta um modelo de texto para fala que, segundo a publicação, pode clonar uma voz usando cinco segundos de fala.
- RAG e recuperação de contextoPublicação
Memória em agentes de IA: critérios para projetos de longo prazo
Survey publicado em 11 de agosto de 2025 por pesquisadores da Renmin University of China e da Huawei aborda design, avaliação, aplicações, limitações e direções futuras da memória em agentes baseados em LLM.
- Agentes de IAArtigo
Meta apresenta modelo aberto de 32 bilhões de parâmetros para pesquisa em código
Em 24 de setembro de 2025, a Meta apresentou o Code World Model, um modelo de 32 bilhões de parâmetros com pesos abertos, voltado à pesquisa sobre geração de código com world models.
- Voz: TTS e ASRPublicação
Mini-Omni-Reasoner combina raciocínio e fala
Post de 22 de setembro de 2025 descreve uma arquitetura que intercala raciocínio silencioso e tokens falados, além de um novo conjunto de dados e ganhos relatados em matemática e compreensão contextual.
- Inferência de LLMsProjeto
Mirage compila LLMs em megakernels persistentes
Publicada em 19 de junho de 2025, a publicação descreve um compilador que transforma LLMs em megakernels persistentes e afirma reduzir a latência em 1,2 a 6,7 vezes.
- Atenção e arquitetura de modelosPesquisa
MoE-CL propõe adaptação contínua de LLMs
Publicado em 6 de outubro de 2025, o paper apresenta um método de ajuste contínuo com experts LoRA e relata avaliações nos benchmarks MTL5 e Tencent3, além de um teste A/B.
- Inferência de LLMsArtigo
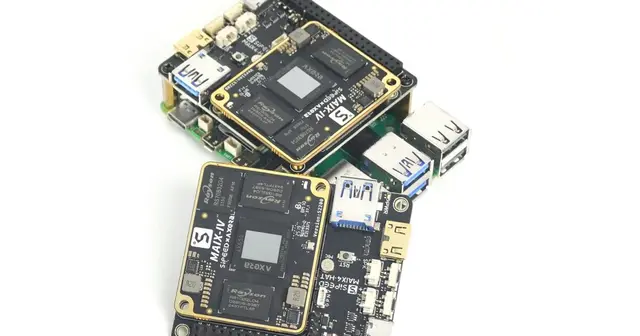
NPU de até 72 TOPS no Raspberry Pi 5
Em publicação de 11 de agosto de 2025, a Sipeed apresentou o Maix4-HAT, com NPU AXera AX650N, até 72 TOPS em INT4 ou 18 TOPS em INT8 e 8 GB de RAM LPDDR4x, para inferência de Transformers na edge.
- Atenção e arquitetura de modelosPublicação
O que os attention sinks revelam sobre LLMs
Experimentos com modelos de 410 milhões a 120 bilhões de parâmetros relacionam normas extremas de ativação do token inicial a compression valleys e attention sinks.
- RAG e recuperação de contextoProjeto
OpenScholar reúne código, modelos e 45 milhões de papers
Em 19 de novembro de 2024, o repositório OpenScholar apresentou código, checkpoints de modelos, um acervo com mais de 45 milhões de papers até outubro daquele ano e o benchmark ScholarQABench.
- CUDA e programação de GPUArtigo
Otimização de attention: lições do FlashAttention-4
Em post publicado em 26 de setembro de 2025, a Modal descreve técnicas de engenharia reversa do FlashAttention-4 e atribui a elas um ganho de performance de 20%.
- Voz: TTS e ASRPublicação
Parler-TTS: modelos de voz controláveis para avaliar
Publicado em 8 de agosto de 2024, o anúncio apresenta os modelos Mini e Large v1, treinados com 45 mil horas de fala, e descreve controles de voz por prompts de texto.
- Treino e fine-tuningPublicação
PEER recupera mais de um milhão de experts com product keys
A arquitetura PEER combina roteamento por product keys e experts MLP de um único neurônio para selecionar, de forma esparsa, os componentes usados em cada entrada.
- CUDA e programação de GPUArtigo
Penny e a comunicação entre GPUs: o que observar
Post de 21 de setembro de 2025 inicia um diário sobre o desenvolvimento manual da Penny, uma biblioteca de comunicação para GPUs.
- Agentes de IAPublicação
Pesquisa configurável como código: a abordagem da NVIDIA
Em 7 de setembro de 2025, uma publicação da NVIDIA descreveu um sistema que transforma estratégias de pesquisa em linguagem natural em funções executáveis, com busca, modelos intercambiáveis e execução em sandbox.
- Inferência de LLMsPublicação
PHLoRA extrai adapters LoRA de modelos ajustados
Publicado em 17 de setembro de 2025, o post descreve um método que extrai adapters de baixo rank de checkpoints ajustados, sem dados de treinamento ou gradientes.
 arxiv.org
 tokens-for-thoughts.notion.site
Vamos avaliar seu projeto

Respondo com escopo e proposta.