


Notícias de IA e infraestrutura
- Agentes de IAPublicação
Agentes de P&D precisam rever a estratégia de treinamento
Estudo publicado em 22 de agosto de 2026 analisou 1.338 trajetórias de pós-treinamento. A estratégia geral mudou em 74 de 3.557 experimentos adjacentes.
- Aprendizado por reforçoPublicação
Agentes de terminal treinados em ambientes RL Dockerizados
Post publicado em 24 de junho de 2026 descreve 14,6 mil ambientes Dockerizados de aprendizado por reforço e uma receita DPPO baseada apenas em resultados. Um modelo 9B alcançou 27% no Terminal-Bench 2.0.
- Atenção e arquitetura de modelosArtigo
Agentes otimizam kernels de atenção em GPU
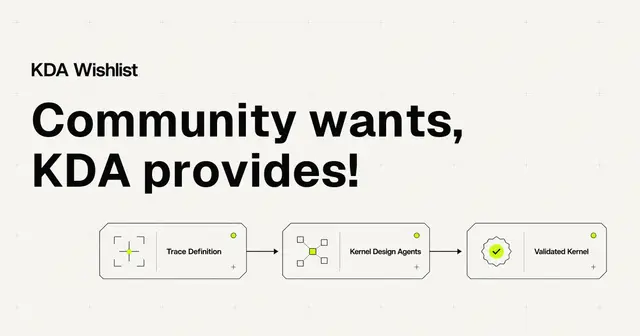
Post da NVIDIA, publicado em 28 de setembro de 2026, relata kernels de atenção com desempenho até 2,96 vezes maior que FlashKDA em B300 e um décimo do erro de estado.
- Agentes de IAArtigo
Agentes para reproduzir pesquisas e provisionar GPUs
O OpenResearch é descrito como uma ferramenta que usa agentes para reproduzir resultados de papers e provisionar GPUs na nuvem. O autor afirma que ela reproduziu seu paper de ponta a ponta.
- Agentes de IAPesquisa
Agentes podem decidir quando buscar mais contexto
Artigo publicado em 22 de agosto de 2026 modela a escolha de agentes interativos entre agir com suposições e buscar contexto, considerando os custos dessas ações.
- Agentes de IAPublicação
Agentes que atualizam seu modelo do ambiente durante a inferência
Post publicado em 30 de junho de 2026 sobre o ARC-AGI-3: o aprendizado durante a inferência leva agentes a construir e atualizar modelos de regras e mecânicas com novas evidências.
- Atenção e arquitetura de modelosArtigo
Algoritmos nos pesos de transformers: aplicações práticas
Publicado em 24 de junho de 2026, o artigo sobre The Transformer Cookbook descreve como codificar algoritmos de adição, busca e ramificação nos pesos de transformers, seguindo o trabalho sobre RASP.
- Aprendizado por reforçoProjeto
Ambientes de RL e código para treinar modelos de linguagem
Em 26 de setembro de 2026, a Xiaomi MiMo publicou ambientes de aprendizado por reforço, código de treinamento e um conjunto de dados para experimentos com modelos de linguagem.
- Aprendizado por reforçoProjeto
Amostragem de replay buffer com SQL
Post publicado em 16 de agosto de 2026 descreve amostragem ponderada top-k em SQL e relata selecionar 8.192 linhas entre 50 milhões em cerca de 1,1 segundo em um laptop.
- SegurançaArtigo
Análise black-box do chip seguro MJA1 da Xiaomi
Em 28 de junho de 2026, a Quarkslab descreveu uma análise do chip MJA1 que examinou hardware, tráfego I2C, memória flash e firmware, mapeando o protocolo de comandos e avaliando propriedades de segurança.
- Treino e fine-tuningPesquisa
Aprendizado contínuo: como avaliar modelos atualizados após o deployment
Uma publicação datada de 29 de setembro de 2026 descreve um modelo 7B atualizado com dados de mercados de previsão e avaliado em backtests contínuos por 390 dias.
- Atenção e arquitetura de modelosProjeto
Aprendizado contínuo em LLMs com iSDFT
Repositório publicado em 22 de setembro de 2026 apresenta um método de destilação própria para aprendizado contínuo em LLMs, com código de treinamento, checkpoints e avaliações.
- Atenção e arquitetura de modelosProjeto
Aprendizado contínuo em notebook com 8 GB de VRAM
O repositório mini-AGI descreve um modelo treinado do zero em um notebook com 8 GB de VRAM, usando batch 1, pesos paginados do disco e ajustes na taxa de aprendizado para reduzir o esquecimento.
- Agentes de IAPesquisa
AREAL2.0 conecta tarefas reais à evolução de agentes
Publicado em 10 de julho de 2026, o artigo apresenta uma arquitetura de aprendizado contínuo que transforma tarefas reais em dados de treinamento e aciona atualizações de políticas.
- Treino e fine-tuningPublicação
ARGUS diagnostica lentidão em treinamentos de grande escala
Paper publicado no arXiv em 19 de junho de 2026 descreve um sistema que combina dados de CPU, framework e GPU para investigar lentidão no treinamento, com overhead contínuo abaixo de 2%.
- C e C++Artigo
Aritmética de ponto flutuante construída do zero
Publicado em 6 de julho de 2026, o artigo aborda a construção de aritmética de ponto flutuante do zero como um projeto técnico avançado para engenheiros.
- Atenção e arquitetura de modelosPublicação
Arquiteturas híbridas além da atenção padrão
Post publicado em 8 de julho de 2026 compara as arquiteturas do Qwen 3.5 e do Nemotron 3 e aponta a evolução convergente entre atenção linear e modelos de espaço de estados.
- C e C++Artigo
Arrays multidimensionais: como o acesso afeta o desempenho
Em artigo publicado em 11 de julho de 2026, Eli Bendersky compara, com benchmarks, o desempenho de diferentes padrões de acesso a arrays multidimensionais.
- SegurançaPesquisa
Ataques práticos à privacidade e à disponibilidade em redes 4G/LTE
Um artigo de 2015 examina ataques práticos que afetam a privacidade e a disponibilidade em sistemas de comunicação móvel 4G/LTE.
- Atenção e arquitetura de modelosPesquisa
Atenção em Transformers de contexto longo
Publicado em 15 de setembro de 2026, o artigo analisa o colapso de posto da atenção à medida que o contexto cresce e estuda o reescalonamento de scores por um fator polilogarítmico.
- Atenção e arquitetura de modelosPesquisa
Atenção esparsa nativamente treinável para contextos longos
Artigo publicado em 26 de setembro de 2026 apresenta a NSA, uma abordagem de atenção esparsa que combina inovações algorítmicas e otimizações de hardware para modelar contextos longos com mais eficiência.
- Atenção e arquitetura de modelosPublicação
Atenção esparsa pode otimizar a seleção de blocos KV
Publicação da Tencent, datada de 14 de setembro de 2026, descreve um método que usa a perda de modelagem de linguagem para aprender quais blocos KV cada consulta deve acessar.
- Atenção e arquitetura de modelosPublicação
Atenção linear dinâmica ajusta memória à informação dos tokens
Post de 15 de junho de 2026: a Dynamic Linear Attention adapta os estados de memória à informação dos tokens, mantendo um cache fixo, e relata ganhos em benchmarks, throughput e memória.
- Atenção e arquitetura de modelosPublicação
Atenção linear e esparsa: o que avaliar em modelos de contexto longo
Um post de 26 de agosto de 2026 afirma que o GLM-5.3 intercala três camadas de atenção linear para cada camada de atenção esparsa, destacando trade-offs de eficiência computacional em contextos longos.
- Atenção e arquitetura de modelosArtigo
Atenção sob demanda pode equilibrar contexto longo e velocidade
Em publicação datada de 20 de setembro de 2026, a abordagem On-Demand Attention usa uma head leve para acionar o contexto completo quando necessário, buscando acelerar a decodificação sem perder tanto desempenho quanto a atenção local.
- Atenção e arquitetura de modelosPesquisa
Attention sinks e reescala em transformers
Artigo publicado em 5 de outubro de 2026 analisa attention sinks e residual sinks em grandes modelos de linguagem e propõe como esses outliers, a atenção softmax e RMSNorm reescalam outros componentes.
- CUDA e programação de GPUPesquisa
Atualização do guia CUDA da NVIDIA pede revisão técnica
A publicação da NVIDIA informa que o CUDA C++ Programming Guide foi atualizado em junho de 2026. Empresas que desenvolvem software para GPU podem revisar suas práticas e documentar os padrões usados nos projetos.
- Agentes de IAPesquisa
Autoaperfeiçoamento em agentes: como controlar a adaptação
Uma survey publicada em 16 de julho de 2026 analisa sistemas agentic modernos como modelos fundacionais integrados a prompts, memória e ferramentas. A visão sistêmica ajuda a identificar onde atualizações acontecem e como torná-las controláveis.
- Agentes de IAPublicação
Autodata estrutura agentes para criar e avaliar datasets
Publicado em 25 de junho de 2026, o material apresenta o Autodata, método em etapas no qual agentes de IA criam e analisam dados de treino e avaliação e aplicam meta-otimização.
- Agentes de IAPesquisa
Autodata gera dados de treino com loops de agentes
Publicado em 6 de julho de 2026, o método Autodata usa solvers fraco e forte para selecionar perguntas que distinguem o desempenho dos modelos.
- Aprendizado por reforçoPublicação
AutoDecompiler aplica RL à decompilação iterativa
Post de 25 de junho de 2026 descreve um modelo que usa aprendizado por reforço e feedback direto em várias etapas para decompilar código.
- Agentes de IAPesquisa
Automatizar a revisão científica sem abrir mão da supervisão humana
O artigo, publicado em 29 de junho de 2026, trata a escalabilidade da revisão científica como um desafio de sistemas e propõe quatro níveis de colaboração entre IA e humanos.
- Agentes de IAPublicação
AutoMem explora memória gerenciada por agentes
Post publicado em 6 de julho de 2026 descreve um paper sobre agentes que escrevem, pesquisam e organizam notas, com ganhos relatados de 2x a 4x em jogos longos.
- Agentes de IAPublicação
Autoresearch: agente supera harness manual após oito dias
Um post publicado em 14 de julho de 2026 relata que um agente de autoresearch se aprimorou ao longo de oito dias e superou um harness ajustado manualmente em benchmarks fora do treinamento.
- Agentes de IAArtigo
AutoResearch automatiza experimentos de aprendizado por reforço
Post publicado em 18 de junho de 2026 descreve um agente que planejou e executou experimentos de aprendizado por reforço em GPU, incluindo escrita de código, depuração e síntese de conclusões.
- SegurançaPesquisa
Backup seguro de chaves secretas de alto valor
Artigo publicado em 24 de setembro de 2026 aborda o backup de chaves secretas de alto valor e aponta a proteção dessas cópias como uma preocupação de segurança.
- SegurançaArtigo
Benchmark compara modelos na descoberta de vulnerabilidades
Publicado em 18 de julho de 2026, o benchmark DeepSec compara recall, precisão e custo de modelos em uma aplicação open-core para análise de segurança.
- Agentes de IAArtigo
Benchmark compara sete memórias self-hosted para Hermes Agent
Publicado em 9 de agosto de 2026, o benchmark da comunidade compara sete provedores de memória self-hosted para Hermes Agent, usando 71.060 turnos e 3.750 perguntas sobre fatos que mudam com o tempo.
- Atenção e arquitetura de modelosArtigo
BF16 no FlashAttention: monitore a estabilidade dos gradientes
Em 29 de setembro de 2026, um trabalho técnico relatou que o arredondamento BF16 no FlashAttention pode quebrar uma simetria do gradiente do softmax e causar explosões no fim do treinamento. Os autores propõem o GProj como correção.
- Agentes de IAPesquisa
BINEVAL torna avaliações de LLMs mais interpretáveis
Publicado em 27 de junho de 2026, o post descreve uma avaliação com perguntas binárias que igualou ou superou UniEval e G-Eval em três conjuntos de dados, sem treinamento.
 arxiv.org
Vamos avaliar seu projeto

Respondo com escopo e proposta.