


Notícias de IA e infraestrutura
- RAG e recuperação de contextoPublicação
Autoflow mostra Graph RAG com armazenamento vetorial no TiDB
Publicado em 22 de novembro de 2024, o repositório da PingCAP descreve o Autoflow, uma base de conhecimento conversacional com Graph RAG que usa TiDB Serverless para armazenamento vetorial.
- Agentes de IAPublicação
AutoToS usa testes e busca em largura para refinar funções
Em 23 de agosto de 2024, um artigo descreveu como o AutoToS refina funções de sucessor e de teste de objetivo com feedback de testes unitários e busca em largura.
- HardwareArtigo
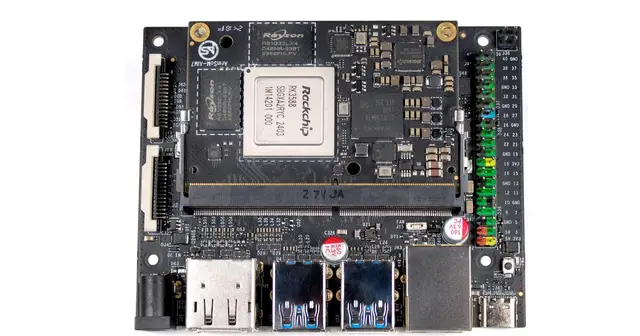
Avaliar o módulo BPI-AIM7 para IA na borda
Uma publicação de 11 de outubro de 2025 descreve o BPI-AIM7 como um módulo de IA de baixo consumo baseado no RK3588 e compatível com o ecossistema Jetson Nano.
- Voz: TTS e ASRModelo
Avaliar síntese de voz em francês na empresa
Uma postagem de PHBJT, publicada em 25 de setembro de 2024, aponta para um modelo de síntese de voz em francês e menciona outras opções de text-to-speech.
- RAG e recuperação de contextoPublicação
Busca vetorial local com SQLite e sqlite-vec
Publicação de 2 de agosto de 2024 apresenta uma extensão em C, sem dependências, que adiciona busca vetorial ao SQLite.
- Atenção e arquitetura de modelosPublicação
CCA: atenção em espaço latente comprimido
Post de 7 de outubro de 2025 descreve uma arquitetura que calcula atenção em um espaço latente menor e relata reduções de memória, parâmetros e operações em testes com H100.
- Atenção e arquitetura de modelosPublicação
Circuitos internos ajudam a prever erros de raciocínio
Post de 13 de outubro de 2025 descreve uma técnica que usa grafos de atribuição para identificar raciocínios incorretos em tarefas aritméticas, com melhora nas métricas de detecção.
- C e C++Projeto
ckit.h: utilitários reutilizáveis para projetos em C
Publicado em 2 de outubro de 2025, o repositório ckit.h se apresenta como um pequeno kit de itens essenciais para projetos em C. A pauta propõe avaliar sua adequação e integração ao código da empresa.
- Voz: TTS e ASRProjeto
Codec de áudio para Speech LLMs: tokens paralelos e streaming
Em post publicado em 17 de outubro de 2025, a Meituan apresentou um codec de áudio de código aberto otimizado para Speech LLMs, com tokens semânticos e acústicos a 16,7 Hz e decodificação de streaming de baixa latência.
- HardwarePublicação
Como avaliar aceleradores para workloads paralelos
Em post publicado em 18 de setembro de 2025, a Graphcore descreve a arquitetura da IPU e seus recursos para computação baseada em grafos e workloads irregulares e esparsos.
- Agentes de IAPublicação
Como avaliar agentes de IA em tarefas de trabalho
O TheAgentCompany reúne tarefas de desenvolvimento de software, gestão de projetos, administração e ciência de dados para avaliar agentes de IA.
- SegurançaProjeto
Como avaliar ferramentas que contornam inspeção de rede
Uma publicação de 30 de agosto de 2024 cita três ferramentas open source para contornar inspeção profunda de pacotes e aponta um uso prático: avaliar controles de filtragem de rede.
- Voz: TTS e ASRPublicação
Como avaliar inferência de voz em tempo real
Publicado em 18 de setembro de 2024, o artigo apresenta Moshi, um modelo de speech-to-speech com 7,6 bilhões de parâmetros, e o codec de áudio streaming Mimi.
- HardwareArtigo
Como avaliar uma plataforma RISC-V aberta em FPGA
Publicado em 10 de julho de 2024, o projeto propõe um computador RISC-V de 64 bits em FPGA, capaz de executar Linux e hospedar seu próprio desenvolvimento.
- Voz: TTS e ASRArtigo
Como comparar opções de speech-to-text por qualidade, velocidade e custo
Em 24 de junho de 2024, a Artificial Analysis publicou uma comparação de modelos de speech-to-text por taxa de erro de palavras, velocidade e preço, com um ranking voltado à escolha conforme o caso de uso.
- RAG e recuperação de contextoProjeto
Como criar um pipeline de RAG para PDFs
Um notebook publicado em 28 de novembro de 2024 demonstra uma receita de RAG sobre PDFs com Docling e Weaviate, usando conversão de documentos para Markdown ou JSON.
- CUDA e programação de GPUPublicação
Como desenvolver kernels CUDA de matmul de alto desempenho
Publicado em 29 de setembro de 2025, o guia aborda hierarquia de memória de GPU, programação CUDA e inspeção de PTX/SASS para orientar o desenvolvimento de kernels de matmul.
- Atenção e arquitetura de modelosPublicação
Como equilibrar adaptação e memória no treinamento de modelos
Estudo publicado em 5 de outubro de 2025 relata que um modelo treinado em 12.000 tarefas pequenas combinou ideias novas e aponta diferenças entre lições estruturadas e mistas.
- Atenção e arquitetura de modelosPublicação
Como observar o fluxo de informação em LLMs
Publicada em 9 de outubro de 2025, a publicação propõe três etapas para o fluxo de informação em LLMs e relaciona ativações massivas a attention sinks e compression valleys.
- HardwarePesquisa
Computação em fluxo: o modelo de Brook para GPUs
O artigo de 2004 descreve kernels que processam elementos em streams como alternativa a APIs gráficas e shaders, um modelo que ajuda a orientar avaliações de cargas em GPU.
- Atenção e arquitetura de modelosPesquisa
Continuous Thought Machines exploram dinâmica entre neurônios
Publicado em 6 de outubro de 2025, o artigo apresenta um modelo que usa processamento e sincronização em nível de neurônio como representações centrais, inspirado na dinâmica neural biológica.
- Agentes de IAPublicação
Curadoria de dados e autonomia de agentes: o que testar
Post publicado em 23 de setembro de 2025 descreve o LIMI: 78 demonstrações selecionadas alcançaram 73,5% no AgencyBench, acima de modelos treinados com 10 mil amostras.
- Treino e fine-tuningProjeto
DeepSpeed Domino e o treinamento distribuído de LLMs
Post de 26 de novembro de 2024 descreve um mecanismo de paralelismo de tensores voltado a reduzir a sobrecarga de comunicação no treinamento de LLMs.
- Treino e fine-tuningArtigo
Detecção de elementos do basquete com visão computacional
Uma publicação de 24 de setembro de 2025 descreve o ajuste fino de um modelo de detecção para identificar jogadores, números, árbitros, bola e aro em partidas de basquete.
- Atenção e arquitetura de modelosPublicação
Dicas curtas de raciocínio para avaliar sistemas de IA
Um paper publicado em 5 de outubro de 2025 descreve um gerador de dicas e um solver treinados por reinforcement learning. Em matemática, relata 44% mais acurácia no AIME 2025 do que o RL com cadeias longas.
- SegurançaProjeto
DocEx testa defesas contra exfiltração de documentos
Publicado em 20 de abril de 2025, o texto descreve o DocEx, ferramenta de emulação de APT que simula a exfiltração de arquivos DOCX, PPTX, XLSX e PDF para avaliar defesas de segurança.
- Atenção e arquitetura de modelosPublicação
Dragon Hatchling explora memória local em modelos de linguagem
Publicado em 3 de outubro de 2025, o post descreve uma arquitetura com neurônios simples e conexões que armazenam memória de curto prazo por aprendizado Hebbiano.
- Atenção e arquitetura de modelosPublicação
Dragon Hatchling propõe arquitetura de LLM interpretável
Publicado em 1º de outubro de 2025, o post descreve uma arquitetura de LLM baseada em partículas neuronais de interação local e afirma que ela rivaliza com o desempenho do GPT-2.
- HardwareArtigo
Dream Router 7: Wi-Fi 7 e 10GbE em um gateway
Em 4 de junho de 2025, a StorageReview publicou uma análise do gateway integrado Dream Router 7, com Wi-Fi 7, 10GbE, PoE, aplicativos UniFi e ferramentas de segurança para casas e pequenas e médias empresas.
- Treino e fine-tuningDocumentação
Otimização reflexiva de prompts com DSPy GEPA
Um cookbook publicado em 16 de outubro de 2025 apresenta otimização reflexiva de prompts com DSPy GEPA e relata ganho de 11% na precisão do NuminaMath-1.5 por menos de US$ 0,50 no total.
- Voz: TTS e ASRPublicação
E2-F5-TTS inclui interface para ajustar modelos de voz
Em 21 de outubro de 2024, o repositório E2-F5-TTS apresentou um app Gradio para ajustar o modelo com áudio enviado pelo usuário e transcrever os clipes automaticamente.
- RAG e recuperação de contextoPesquisa
EfficientRAG reduz chamadas de LLM em perguntas multi-hop
Artigo publicado em 17 de agosto de 2024 apresenta um método de recuperação que gera consultas iterativamente sem chamar um LLM a cada etapa.
- RAG e recuperação de contextoArtigo
Embeddings generativos e busca de documentos: temas para avaliar
A seleção semanal de artigos, em seu volume 124, foi publicada em 5 de outubro de 2025 e destaca embeddings generativos com escalonamento em tempo de teste e sistemas eficientes de busca em documentos visuais.
- Treino e fine-tuningPesquisa
ESFT direciona o ajuste fino a experts relevantes em LLMs esparsos
Publicado em 5 de julho de 2024, o paper estuda ajuste fino eficiente em parâmetros para modelos Mixture-of-Experts e apresenta o ESFT, que treina experts selecionados por sua relevância para a tarefa.
- Atenção e arquitetura de modelosPublicação
Estudo compara attention em 13 LLMs e encontra melhor resultado com 17%
Publicado em 12 de outubro de 2025, o estudo relata experimentos com 13 LLMs e diferentes proporções de attention convencional e DeltaNet linear attention. A configuração com 17% de attention — duas de 12 camadas — obteve o melhor resultado nos testes.
- SegurançaArtigo
Evasão do Defender: como avaliar e reforçar detecções
Publicado em 19 de abril de 2025, o artigo apresenta uma série em duas partes sobre evasão do Windows Defender, incluindo direct syscalls e XOR. A primeira parte oferece código básico para experimentação e aponta a avaliação de defesas e o desenvolvimento de detecções como aplicações defensivas.
- RAG e recuperação de contextoPublicação
Expansão de consultas com grafos de conhecimento
Uma publicação de 13 de novembro de 2024 descreve um fluxo que combina entidades extraídas de consultas, documentos recuperados e relações de grafos de conhecimento para gerar expansões contextuais.
- OCR e IA para documentosPublicação
Extração de texto de PDFs com olmOCR
Em post publicado em 25 de fevereiro de 2025, a AllenAI apresentou o olmOCR, ferramenta open source para extrair texto simples de diferentes tipos de PDFs, executável em uma GPU.
- RAG e recuperação de contextoPesquisa
FACT propõe reescrita iterativa para recuperar vários fatos
Publicado em 30 de outubro de 2024, o paper apresenta uma abordagem de reescrita de contexto para recuperar múltiplos fatos e examina respostas incompletas diante de contextos extensos.
- Voz: TTS e ASRModelo
Fala multilíngue: como avaliar o FireRedTTS 2
Publicado em 17 de setembro de 2025, o artigo apresenta um modelo aberto de síntese de fala com suporte a conversas longas, clonagem de voz multilíngue e geração de baixa latência.
 arxiv.org
Vamos avaliar seu projeto

Respondo com escopo e proposta.