


Notícias de IA e infraestrutura
- HardwareArtigo
SSSTC apresenta SSDs SATA ER4 de até 16 TB
Em 27 de novembro de 2025, a SSSTC apresentou a linha de SSDs SATA corporativos ER4, com capacidades de até 16 TB e desempenho de até 98 mil IOPS.
- C e C++Artigo
Stack frames em x86-64: aplicações para depuração
Artigo de Eli Bendersky, publicado em 2 de março de 2026, sobre como chamadas de função usam a stack em x86-64 e como se organiza um stack frame.
- Agentes de IAProjeto
Stop hooks podem manter agentes em tarefas longas
Post da Anthropic, de 27 de dezembro de 2025, descreve o uso de um stop hook para pedir que um agente continue após parar e aponta a técnica como apoio à orquestração de tarefas mais longas.
- Agentes de IAPesquisa
StructMem propõe memória temporal hierárquica para agentes
Publicado em 24 de abril de 2026, o paper StructMem propõe uma memória hierárquica para agentes conversacionais de longo prazo, com relações entre eventos voltadas a raciocínio temporal e perguntas multi-hop.
- CUDA e programação de GPUArtigo
Subgroups no Vulkan 1.1: paralelismo na GPU
Em tutorial publicado em 4 de março de 2026, a Khronos explica como subgroups no Vulkan 1.1 permitem compartilhar e manipular dados entre tarefas paralelas na GPU.
- Inferência de LLMsPublicação
SWAA propõe inferência mais eficiente com contexto longo
Post de 15 de dezembro de 2025 descreve receitas sem treinamento para adaptar modelos de linguagem com atenção completa a uma escala linear e recuperar desempenho.
- HardwareArtigo
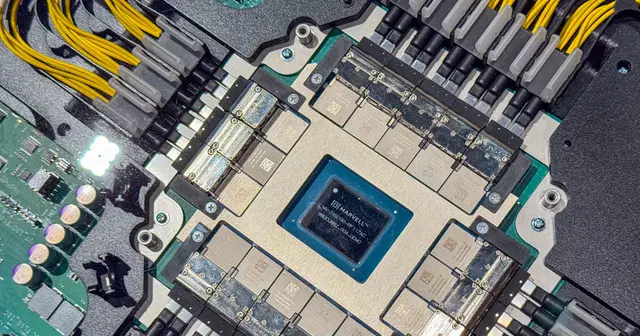
Switch CPO com refrigeração líquida: implicações para redes
A ServeTheHome relata a demonstração do switch CPO TX9190 da Marvell, com refrigeração líquida, na OCP 2025, em 21 de outubro de 2025.
- Agentes de IAPesquisa
TACO propõe compressão de contexto para agents de terminal
O paper descreve um framework que aprende regras de compressão de contexto a partir de interações de agents de terminal e relata testes em três benchmarks.
- Treino e fine-tuningPublicação
TC-JEPA: legendas orientam o aprendizado visual
Post publicado em 9 de maio de 2026 descreve um método self-supervised que usa legendas para orientar a previsão de patches mascarados em imagens. Segundo o post, a abordagem melhora a estabilidade do treinamento e o raciocínio visual em comparação com métodos contrastivos.
- HardwareArtigo
TCL anuncia monitor OLED+ 4K de 240 Hz
Em 5 de março de 2026, a TCL anunciou o monitor 32X3A, com painel OLED+, resolução 4K, taxa de atualização de 240 Hz e design ultrafino.
- HardwareArtigo
TDIMM DDR5: como avaliar memória de alta capacidade
A Tachyum anunciou um padrão open source de memória TDIMM DDR5. A página vinculada menciona até 1 TB por DIMM e largura de banda de 231 GB/s, números que podem orientar avaliações de arquitetura.
- HardwareArtigo
TDIMM DDR5: memória aberta para cargas de IA
Em post publicado em 26 de novembro de 2025, a Tachyum anunciou a tecnologia TDIMM de código aberto, compatível com DDR5, e declarou bandwidth de 281 GB/s, módulos de até 1 TB e nós de até 3 PB.
- Inferência de LLMsArtigo
Técnicas para otimizar inferência de Transformers
Um post publicado em 24 de dezembro de 2025 descreve técnicas de inferência de Transformers: quantização MXFP4, paralelismo de tensores e especialistas e janelas deslizantes dinâmicas.
- Atenção e arquitetura de modelosArtigo
Técnicas para tornar o serving de LLMs mais eficiente
Notas de aula publicadas em 13 de maio de 2026 abordam quantização, sparsity, atenção, speculative decoding e batching para melhorar a inferência e o serving de LLMs.
- Inferência de LLMsProjeto
Tencent apresenta operadores HPC-Ops para inferência de LLMs
Em 27 de janeiro de 2026, a Tencent apresentou a biblioteca open source HPC-Ops, com operadores para inferência de LLMs e suporte a operações em GPUs e comunicação multinó.
- Atenção e arquitetura de modelosPesquisa
Tensor Product Attention propõe reduzir a memória do cache KV
Publicado em 27 de outubro de 2025, o artigo apresenta uma técnica de atenção com componentes contextuais de baixo rank para reduzir o consumo de memória do cache KV durante a inferência.
- HardwareArtigo
Testes de CPU com Python e cocotb: da simulação à validação
Publicado em 11 de dezembro de 2025, o artigo apresenta uma forma de testar a CPU Mrav com cocotb e scripts em Python, incluindo uma classe para modelar a RAM.
- Treino e fine-tuningArtigo
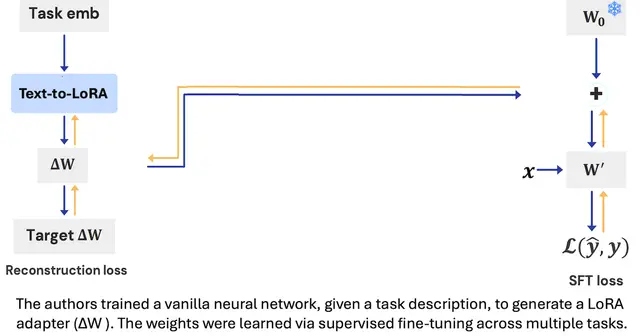
Text-to-LoRA gera adapters a partir de descrições
Publicado em 21 de outubro de 2025, o estudo da Sakana AI apresenta um método que gera adapters LoRA para tarefas a partir de descrições em linguagem natural e avalia seus resultados em 479 tarefas.
- Treino e fine-tuningPublicação
Tile Kernels otimizam operações de LLM em GPU
Em 23 de abril de 2026, a empresa publicou kernels de GPU desenvolvidos com TileLang para operações de LLM e informou que alguns são usados em treinamento e inferência internos.
- Inferência de LLMsArtigo
TokenSpeed destaca otimizações de inferência para agentes
Publicado em 24 de maio de 2026, o texto descreve um engine de inferência para workloads agentic, com paralelismo apoiado por compiler, scheduler de alto desempenho, reutilização restrita de recursos KV e kernels plugáveis para aceleradores heterogêneos.
- Inferência de LLMsArtigo
Tool calling com modelos locais: do guia à aplicação
Publicado em 5 de fevereiro de 2026, o guia da Unsloth apresenta exemplos de chamadas a ferramentas com modelos abertos locais, incluindo Python, terminal e matemática.
- Aprendizado por reforçoPesquisa
Trajetórias de especialistas no treinamento de modelos de linguagem
Em 31 de outubro de 2025, uma publicação apresentou um método que usa trajetórias de especialistas para ensinar modelos de linguagem pequenos a raciocinar sobre problemas difíceis.
- Atenção e arquitetura de modelosPublicação
Transformer em loop alcança 100% no Sudoku-Extreme
Uma publicação datada de 1º de junho de 2026 descreve um transformer compacto com loop, de 800 mil parâmetros, que obteve 100% no Sudoku-Extreme após 15 minutos de treinamento.
- CUDA e programação de GPUDocumentação
Transposição de matrizes em CUDA com memória compartilhada
Em post publicado em 26 de fevereiro de 2026, Mark Harris, no blog da NVIDIA, explica como a memória compartilhada pode melhorar o desempenho da transposição de matrizes em CUDA C/C++.
- Aprendizado por reforçoArtigo
Treinamento com RL: riscos de dados e infraestrutura
Publicada em 5 de novembro de 2025, a publicação aponta que feedback ruidoso e uma infraestrutura complexa podem tornar o treinamento com RL instável.
- CUDA e programação de GPUPublicação
Treinamento de LLMs em escala: escolhas de paralelismo
Playbook publicado em 6 de abril de 2026 descreve estratégias de paralelismo para treinar LLMs em clusters de GPUs, com dados de 4.000 experimentos em até 512 GPUs.
- CUDA e programação de GPUArtigo
Treinamento FP4 de modelos MoE em GPUs Hopper
A página, publicada em 8 de março de 2026, aborda treinamento FP4 de modelos MoE de grande escala em GPUs Hopper e aponta memória de ativações e comunicação entre especialistas como gargalos.
- Inferência de LLMsProjeto
Treinar redes neurais no Neural Engine: como avaliar o repositório ANE
Publicado em 2 de março de 2026, o repositório ANE descreve treinamento de redes neurais com APIs privadas obtidas por engenharia reversa do Neural Engine da Apple. Veja como avaliar essa abordagem antes de adotá-la.
- Voz: TTS e ASRArtigo
TTS para pronunciar dados estruturados com mais precisão
Em publicação de 10 de junho de 2026, a Gradium afirma que uma atualização de seu modelo TTS melhora a pronúncia de palavras soletradas, siglas, e-mails, números de telefone e códigos.
- C e C++Artigo
Tutoriais de C++ por tópico podem orientar a formação técnica
Em 27 de maio de 2026, o LearnCpp apresentou tutoriais gratuitos de C++ organizados por categorias. Empresas podem usar essa estrutura para planejar trilhas internas de aprendizagem e acompanhar competências.
- RAG e recuperação de contextoArtigo
UltraRAG 3.0 organiza workflows de RAG com YAML
Publicado em 27 de janeiro de 2026, o repositório UltraRAG 3.0 apresenta um framework leve, voltado à pesquisa, que combina servidores MCP e workflows configuráveis em YAML.
- Voz: TTS e ASRProjeto
UNITTS reúne inferência e benchmarking de voz sintética
Post datado de 9 de junho de 2026 apresenta o UNITTS, toolkit para inferência e benchmarking de modelos TTS open source, com suporte a Chatterbox e Fish Audio s2-pro.
- RAG e recuperação de contextoPesquisa
UniversalRAG direciona consultas para recuperação multimodal
Publicado em 14 de janeiro de 2026, o texto descreve um framework que encaminha consultas a corpora específicos por modalidade e recupera conhecimento em diferentes modalidades e granularidades.
- Treino e fine-tuningArtigo
Unsloth: ajuste fino de modelos de embeddings
Em 22 de janeiro de 2026, a documentação da Unsloth apresentou um guia de fine-tuning de modelos de embeddings, com um notebook Colab para um modelo de 300 milhões de parâmetros.
- Atenção e arquitetura de modelosPublicação
URM combina recorrência e não linearidade no raciocínio
Um post sobre pesquisa em Universal Transformers atribui ganhos de raciocínio ao viés recorrente e à forte não linearidade, e descreve escolhas para mistura local de tokens e treinamento.
- C e C++Artigo
Valgrind: diagnóstico de memória, threads e desempenho
O manual do Valgrind descreve ferramentas para detectar problemas de gerenciamento de memória e de threading e para fazer profiling detalhado de programas.
- C e C++Artigo
Value speculation e otimização de código sensível à latência
Artigo de Francesco Mazzoli, publicado em 1º de março de 2026, discute value speculation como técnica para superar limitações do cache L1 e otimizar código sensível à latência.
- Treino e fine-tuningArtigo
Variantes de LoRA: como comparar estratégias de ajuste eficiente
Publicado em 26 de abril de 2026, o artigo da Turing Post apresenta mais de 15 variantes de LoRA, como QLoRA, DoRA e Mixture-of-LoRA-Experts, e acompanha a evolução do ajuste eficiente em parâmetros para grandes modelos de linguagem.
- HardwareArtigo
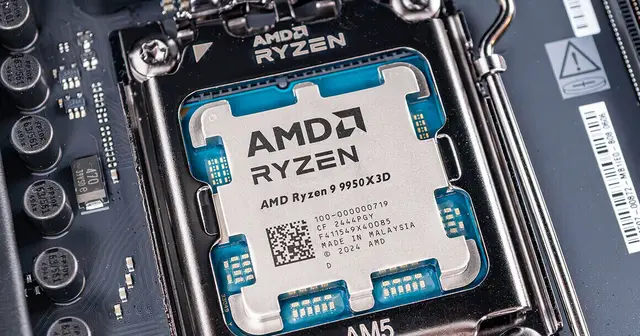
Vazamento cita Ryzen 9 com 192 MB de cache L3
Reportagem da TechPowerUp, publicada em 21 de outubro de 2025, relata um possível processador de 16 núcleos com 192 MB de cache L3 e TDP de 200 W.
- C e C++Pesquisa
Verificação de limites de stack em programas C
Artigo de 2014 de Q. Carbonneaux e coautores aborda a verificação end-to-end de limites de uso da stack em programas C e aponta um tema prático para equipes que precisam controlar recursos de memória.
 arxiv.org
 unsloth.ai
 hgpu.org
Vamos avaliar seu projeto

Respondo com escopo e proposta.