


Notícias de IA e infraestrutura
- CUDA e programação de GPUArtigo
HPC++ automatiza paralelização de C++ para CPUs e GPUs
Publicado em 22 de fevereiro de 2026, o texto apresenta um framework baseado em LLVM que converte programas sequenciais em C++ em implementações paralelas para CPUs multicore e GPUs compatíveis com OpenCL.
- Atenção e arquitetura de modelosPesquisa
HybridGen propõe atenção híbrida para contexto longo
Paper publicado em 21 de abril de 2026 apresenta o HybridGen, framework que coordena atenção entre CPU e GPU com memória CXL para inferência de modelos de linguagem com contexto longo.
- HardwareArtigo
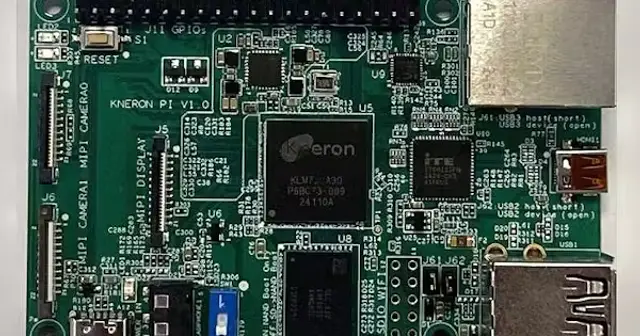
IA on-device na educação: do investimento à implantação
Em 18 de novembro de 2025, uma publicação informou que a Kneron investiu na Innovedeus para levar às escolas uma plataforma semelhante ao Raspberry Pi voltada a ML e IA on-device.
- SegurançaArtigo
IA para detectar lacunas na cobertura de ameaças
Em artigo publicado em 31 de janeiro de 2026, a Microsoft descreve um fluxo de IA que extrai TTPs de relatórios, compara-os com detecções existentes e aponta possíveis lacunas, com revisão humana.
- Aprendizado por reforçoPublicação
IA pode descobrir algoritmos de reinforcement learning
Artigo publicado na Nature em 28 de outubro de 2025 relata a descoberta autônoma de algoritmos de reinforcement learning e aponta uma possível nova abordagem para engenheiros.
- RAG e recuperação de contextoPublicação
Iceberg amplia a avaliação de busca vetorial
Em 21 de dezembro de 2025, pesquisadores do Alibaba e parceiros apresentaram o Iceberg, uma suíte com oito datasets que avalia busca vetorial por seus efeitos em tarefas downstream, além de recall e latência.
- Inferência de LLMsArtigo
Inference não vinculável para proteger a identidade de usuários
Em post publicado em 26 de fevereiro de 2026, a OpenAnonymity descreve uma camada para impedir que provedores de IA associem chamadas de inference a usuários individuais.
- Inferência de LLMsArtigo
Inferência de IA em produção exige engenharia de ponta a ponta
Publicado em 3 de março de 2026, o livro de Philip Kiely aborda hardware, software, técnicas e infraestrutura para sistemas de inferência em produção, com foco principal em modelos de linguagem e algum conteúdo sobre diffusion.
- Inferência de LLMsProjeto
Inferência de Llama 70B em uma RTX 3090 com ntransformer
Em 22 de fevereiro de 2026, a página do repositório ntransformer afirma que o engine de inferência em C++/CUDA executa Llama 70B em uma RTX 3090, com transferência de NVMe para GPU sem passar pela CPU.
- Voz: TTS e ASRProjeto
Inferência em C abre caminho para transcrição de voz integrada
O repositório antirez/qwen-asr oferece inferência em C para modelos de reconhecimento de fala de 0,6B e 1,7B, com aplicação potencial em bots de transcrição e interfaces por voz.
- Inferência de LLMsPublicação
Inferência local: desempenho e consumo na RTX 3090
Testes de oito LLMs locais em uma RTX 3090 compararam throughput e eficiência energética com limites de potência entre 100 W e 450 W.
- CUDA e programação de GPUArtigo
Inferência ONNX: CPU e GPU em comparação
Publicado em 11 de março de 2026, o artigo compara inferência com ONNX Runtime em uma GPU NVIDIA L4 e uma CPU AMD EPYC 9965. O autor relata que OCaml e o posicionamento de memória com libnuma aceleraram a inferência em CPU frente ao uso de GPUs escassas no TESSERA.
- Atenção e arquitetura de modelosPesquisa
Instabilidade em Flash Attention de baixa precisão
Publicado em 15 de março de 2026, o paper analisa explosões catastróficas da loss no treinamento de baixa precisão com Flash Attention e as relaciona a padrões internos semelhantes nos dados de attention e a erros de arredondamento enviesados que se acumulam.
- C e C++Pesquisa
Integer overflow em C e C++: controles para reduzir riscos
Artigo de 2012 da University of Utah aborda integer overflow em C e C++, um risco relevante na escrita e revisão de código nessas linguagens.
- HardwareArtigo
Intel Arc Pro B60: 24 GB para avaliar em workstations
Artigo de 6 de novembro de 2025 informa que a GPU Intel Arc Pro B60, com 24 GB de memória, deveria chegar à Europa entre meados e o fim de novembro, a partir de €769.
- C e C++Pesquisa
Intel atualiza a especificação AVX10.2 para a versão 6.0
Em post publicado em 11 de março de 2026, a Intel anunciou a versão 6.0 da especificação AVX10.2 e a renomeação de AVX10_VNNI_INT para AVX10_V1_AUX.
- C e C++Artigo
Intel documenta acesso a instruções de processadores por funções C
Publicada em 17 de fevereiro de 2026, a documentação da Intel apresenta funções no estilo C que permitem acessar instruções do processador sem escrever assembly.
- HardwarePesquisa
Intel publica guia de tuning HPC para Xeon 6
Em 29 de dezembro de 2025, a Intel lançou a versão 1.2a de seu guia de tuning e otimização de aplicações de computação de alto desempenho para sistemas Xeon 6.
- Atenção e arquitetura de modelosPesquisa
Interleaved Head Attention propõe comunicação entre heads
Em post publicado em 11 de abril de 2026, a Interleaved Head Attention explora a comunicação entre attention heads dentro de uma camada, com foco em raciocínio.
- SegurançaArtigo
Invasão na AWS: credenciais expostas levam do S3 ao Bedrock
Em artigo publicado em 4 de fevereiro de 2026, a Sysdig descreve uma invasão na AWS que começou com credenciais expostas no S3, passou pelo Lambda e chegou ao acesso ao Bedrock. O texto destaca uma regra do Elastic para detectar layers externos adicionados a funções Lambda.
- SegurançaPesquisa
Inversão de gradientes no Federated Learning: riscos e defesas
Publicado em 16 de janeiro de 2026, o post apresenta um estudo sobre ataques de inversão de gradientes em Federated Learning. O texto afirma que o método de ataque mais prático ainda é pouco confiável e que o trabalho propõe uma defesa em três etapas.
- HardwarePublicação
IPUs e batches pequenos: custo versus facilidade de uso
Post publicado em 29 de dezembro de 2025 descreve as IPUs da Graphcore como aceleradores massivamente paralelos, adequados a batches pequenos, e aponta que unidades usadas podem custar pouco, mas são difíceis de usar.
- C e C++Documentação
Jump threading no GCC: como avaliar seus efeitos no código
Artigo da Red Hat Developer, publicado em 2 de abril de 2026, explica como o jump threading busca reduzir saltos executados dinamicamente em diferentes caminhos do fluxo de controle.
- Aprendizado por reforçoPesquisa
JustRL testa RL simples em modelos de raciocínio de 1,5B
Publicado em 4 de janeiro de 2026, o paper descreve treinamento em etapa única, com hiperparâmetros fixos, e relata acurácias médias de 54,9% e 64,3% em dois modelos de raciocínio de 1,5B.
- Atenção e arquitetura de modelosPesquisa
KArAt propõe uma atenção learnable sem softmax fixo
Publicado em 27 de outubro de 2025, o paper apresenta a KArAt, uma alternativa learnable à atenção com softmax. Relata resultados mistos em vision transformers e variantes low-rank para reduzir o uso de memória.
- Atenção e arquitetura de modelosPublicação
Kascade acelera inferência com atenção esparsa
Publicado em 24 de dezembro de 2025, o paper descreve um método sem treinamento que reutiliza padrões de chaves entre camadas. Relata geração até 4,1× mais rápida e prefill 2,2× mais rápido em GPUs H100.
- Atenção e arquitetura de modelosPesquisa
Kascade reduz o cálculo de atenção em contextos longos
Publicado em 18 de fevereiro de 2026, o artigo descreve uma técnica que reutiliza resultados de atenção entre camadas Transformer para reduzir trabalho durante a inferência, sem retreinar o modelo ou alterar seus pesos.
- CUDA e programação de GPUArtigo
Kernel CUDA para soma de arrays: do exemplo à prática
Publicado em 16 de novembro de 2025, o artigo da Tensara apresenta a iniciantes a escrita de um kernel CUDA simples para somar arrays. O exemplo pode servir de base para avaliar cargas de trabalho em GPU.
- CUDA e programação de GPUArtigo
Kernel de matmul em CUDA/PTX relata ganho de 6% no B200
Post publicado em 27 de abril de 2026 descreve um kernel de multiplicação de matrizes em CUDA/PTX puro que, no B200 e com M=N=K=8192, teria superado o desempenho do cuBLAS em 6%.
- C e C++Artigo
Kernel mínimo de time-sharing em Zig para RISC-V
Artigo publicado em 12 de maio de 2026 descreve a criação de um kernel mínimo de time-sharing em Zig para RISC-V sobre OpenSBI, com traps em S-mode e troca de contexto acionada por timer.
- Atenção e arquitetura de modelosProjeto
Kernels Triton e operadores PyTorch para AttnRes
Publicado em 3 de maio de 2026, o repositório reúne kernels Triton e operadores PyTorch para Block Attention Residuals (AttnRes).
- HardwareArtigo
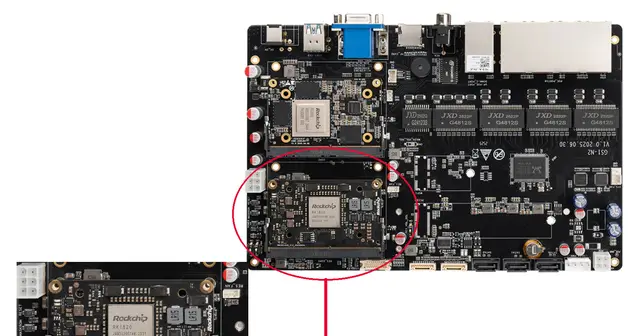
Kit embarcado combina módulos e aceleradores de IA
Publicado em 30 de dezembro de 2025, o artigo descreve um kit que combina módulos de computação e aceleração para avaliar cargas de trabalho de LLMs e VLMs em sistemas embarcados.
- Inferência de LLMsArtigo
KV cache: menos recálculo na inferência de LLMs
Publicado em 9 de maio de 2026, o artigo explica como o KV cache reutiliza valores já calculados e por que isso importa para memória e computação na inferência.
- Aprendizado por reforçoPublicação
LaSeR explora recompensas pelo último token em LLMs
Em post publicado em 19 de outubro de 2025, a Tencent apresenta o LaSeR, algoritmo de reinforcement learning que alinha scores do último token a recompensas reais e usa uma inferência adicional de token.
- CUDA e programação de GPUDocumentação
Layouts CuTe ajudam a entender shapes e strides
Post da NVIDIA, publicado em 3 de fevereiro de 2026, recomenda tutoriais de álgebra de layouts para compreender como o CuTe representa tensores.
- SegurançaProjeto
Leaker e a enumeração passiva de credenciais expostas
Publicado em 12 de janeiro de 2026, o repositório descreve uma ferramenta para localizar, em fontes online passivas, vazamentos de credenciais associados a endereços de e-mail.
- Treino e fine-tuningPublicação
LeJEPA: chunks de SIGReg reduzem VRAM e tempo
Relato publicado em 4 de março de 2026 aponta que dividir 256 slices de SIGReg em chunks de 32 usou oito vezes menos VRAM e terminou mais rápido em uma GPU 4090 MaxQ.
- Treino e fine-tuningArtigo
LeJEPA combina predição latente e regularização
Publicado em 22 de novembro de 2025, o post descreve o LeJEPA, que combina a perda de predição em espaço latente do JEPA com o SIGReg para moldar embeddings em uma distribuição gaussiana isotrópica.
- Voz: TTS e ASRArtigo
LEMAS publica dataset de speech com 150 mil horas
Publicação de 12 de janeiro de 2026 apresenta um dataset de áudio com 150 mil horas em 10 idiomas, timestamps por palavra e os modelos generativos LEMAS-TTS e LEMAS-Edit.
- Treino e fine-tuningPublicação
LeWorldModel: JEPA compacto treinado a partir de pixels
Publicação de 9 de maio de 2026 descreve um JEPA de 15 milhões de parâmetros treinado de ponta a ponta com pixels brutos e relata planejamento até 48 vezes mais rápido que world models baseados em modelos fundacionais em tarefas de controle.
 hgpu.org
 arxiv.org
Vamos avaliar seu projeto

Respondo com escopo e proposta.