


Notícias de IA e infraestrutura
- C e C++Artigo
Linkers em C e C++: como diagnosticar falhas de build
Um guia publicado em 27 de maio de 2026 explica o processo de linking e sua utilidade para diagnosticar problemas de build e de linker em C e C++.
- C e C++Artigo
Linking dinâmico ou estático: avalie inicialização e disco
Artigo de Jordan Rose, publicado em 2 de março de 2026, discute o equilíbrio entre tempo de inicialização e espaço em disco nas estratégias de linking dinâmico e estático.
- C e C++Publicação
Linux Device Drivers e a comunicação com hardware
Post publicado em 25 de maio de 2026 recomenda Linux Device Drivers como introdução à comunicação entre o kernel Linux e o hardware, para leitores com noções de C e chamadas de sistema Unix.
- C e C++Artigo
Linux documenta detecção de bus locks no x86
Publicada em 11 de abril de 2026, a documentação do kernel Linux aborda a detecção e o tratamento de bus locks no x86. Split locks podem afetar o desempenho do sistema.
- HardwareArtigo
Lisuan inicia envios das GPUs 7G100 de 6 nm
Em 30 de dezembro de 2025, a Lisuan informou que começou a enviar suas GPUs 7G100, fabricadas em 6 nm, aos primeiros clientes.
- C e C++Artigo
Livro gratuito aborda programação de sistemas em C
Publicado em 31 de março de 2026, o livro Dive into Systems trata de programação de sistemas, otimização de código e assembly em várias arquiteturas, com base em C.
- Inferência de LLMsProjeto
llama.cpp adiciona suporte a Multi-Token Prediction
Em 17 de maio de 2026, um pull request do llama.cpp adicionou suporte a heads de MTP. O relato cita 65 tokens por segundo para o Qwen3.6-27B em uma RTX 3090, contra 38 sem MTP.
- Inferência de LLMsProjeto
llmfit ajuda a avaliar modelos para hardware local
O repositório llmfit, publicado no GitHub em 21 de fevereiro de 2026, analisa hardware local para identificar modelos compatíveis e estimar a velocidade de inferência.
- Inferência de LLMsPublicação
LMCache reutiliza cache KV entre GPU, CPU e disco
Em 30 de janeiro de 2026, a descrição do projeto open source LMCache apresentou uma extensão para serving de LLMs que reaproveita estados KV entre GPUs, CPUs e discos locais, inclusive para fragmentos de texto repetidos que não sejam apenas prefixos.
- Voz: TTS e ASRProjeto
Local Studio propõe suporte a ROCm, voz, imagens e vídeos
Um pull request do repositório Local Studio, publicado em 9 de fevereiro de 2026, descreve suporte proposto a ROCm, entrada e saída de voz, imagens e vídeos.
- C e C++Documentação
Locking no Linux Kernel: práticas para revisar concorrência
A documentação do Linux Kernel, publicada em 9 de junho de 2026, apresenta um guia sobre locking no kernel e práticas de concorrência. Empresas podem aplicar uma revisão estruturada de sincronização em sistemas críticos.
- C e C++Artigo
Locks no kernel do Ubuntu em tempo real: concorrência e SMP
Em 10 de junho de 2026, a documentação do Real-time Ubuntu explicou como locks do kernel protegem regiões críticas contra troca de contexto e preempção, inclusive em sistemas multiprocessadores.
- HardwareArtigo
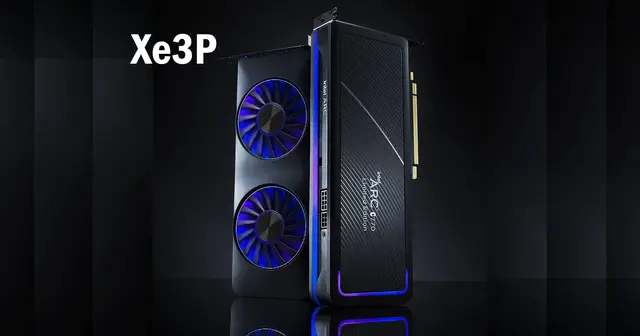
Log aponta variantes Intel Xe3P para GPUs discretas
Artigo da Wccftech, publicado em 6 de novembro de 2025, relata que um log vazado indica uma variante Xe3P HPM para GPUs discretas e uma variante LPM possivelmente ligada ao Nova Lake.
- Inferência de LLMsPesquisa
LoPA explora lookahead para acelerar inferência de modelos de difusão
Publicado em 11 de janeiro de 2026, o texto apresenta o LoPA, um algoritmo sem treinamento adicional que usa lookahead para escolher a ordem de preenchimento de tokens em modelos de linguagem de difusão.
- Treino e fine-tuningPublicação
LoRA como memória: como avaliar dados e rank
Post de 4 de março de 2026 resume um estudo sobre como a memória de conhecimento armazenada por LoRA escala e satura conforme o rank. QA e resumos geraram mais memória por token do que passagens brutas.
- Treino e fine-tuningPesquisa
LoRA como memória de conhecimento: limites para avaliar
Publicado em 3 de março de 2026, o paper analisa adapters LoRA para atualizar o conhecimento de modelos de linguagem e examina capacidade, escalabilidade modular e interferência na mesclagem.
- Aprendizado por reforçoArtigo
LoRA para RLVR: média de especialistas supera gate nos testes
Em 3 de janeiro de 2026, um trabalho sobre estratégias práticas de PEFT para RLVR em múltiplos domínios relatou interferência no treinamento conjunto. Nos experimentos descritos, a média dos pesos de LoRAs especialistas, seguida de treinamento contínuo, superou o método de gating testado.
- Inferência de LLMsProjeto
Lucebox explora speculative inference em GPUs de consumo
Publicada em 9 de maio de 2026, a postagem apresenta o Lucebox, servidor de speculative inference para hardware heterogêneo, e afirma que o Qwen3.6-27B alcança 120–200 tokens por segundo em uma RTX 3090.
- Atenção e arquitetura de modelosPesquisa
Mamba-3 propõe estado fixo para modelar sequências
Publicado em 7 de maio de 2026, o post descreve uma arquitetura de linguagem não Transformer que comprime o contexto em um estado de tamanho fixo e afirma ter decodificação de tempo constante em relação ao comprimento da sequência.
- C e C++Artigo
Manuais Intel detalham arquiteturas 64 e IA-32
Publicados em 25 de dezembro de 2025, os manuais oficiais da Intel descrevem a arquitetura e o ambiente de programação Intel 64 e IA-32, como referência para engenharia de baixo nível.
- Aprendizado por reforçoPublicação
MaxRL propõe outra forma de treinar RL com recompensa binária
Publicado em 9 de fevereiro de 2026, o post descreve o MaxRL e relata até 20 vezes mais eficiência em tempo de teste que o GRPO.
- Atenção e arquitetura de modelosArtigo
Mecanismos de atenção: como comparar arquiteturas de Transformers
Um artigo publicado em 19 de abril de 2026 apresenta mais de 13 mecanismos de atenção e explica como eles influenciam o processamento de contexto e memória em Transformers e LLMs.
- C e C++Artigo
Medir memória e desvios para entender o desempenho do software
Um artigo publicado em 1º de março de 2026 examina como o subsistema de memória interage com a previsão de desvios e influencia o desempenho do software.
- RAG e recuperação de contextoPesquisa
MegaRAG propõe graphs multimodais para RAG
Publicado em 25 de dezembro de 2025, o paper descreve um método que cria automaticamente knowledge graphs a partir de documentos visuais para apoiar retrieval e raciocínio entre modalidades.
- Treino e fine-tuningPesquisa
Megatron-LM divide modelos entre GPUs para viabilizar o treinamento
Um paper de 2019 da NVIDIA descreve o uso de model parallelism para treinar modelos de linguagem com bilhões de parâmetros, distribuindo os pesos entre GPUs quando não cabem em uma só.
- Treino e fine-tuningProjeto
Melhorias no GRPO em um notebook PyTorch
Notebook de 15 de fevereiro de 2026 analisa melhorias para uma implementação de GRPO, incluindo razões de política limitadas, termo KL e recompensas de formato.
- C e C++Pesquisa
Memória e desempenho: transformar conhecimento em diagnóstico
Publicado em 29 de março de 2026, o artigo de Ulrich Drepper aborda memória para programadores e oferece contexto para engenheiros que investigam comportamento da memória e desempenho.
- C e C++Artigo
Memória e processos: conceitos úteis para diagnosticar programas
A série da Byte Lab publicada em 24 de dezembro de 2025 apresenta memória virtual, espaços de endereçamento, processos, registradores, stacks, threads e alocação na stack e no heap.
- Agentes de IAPesquisa
Memória em camadas para agentes de pesquisa prolongada
Um post de 19 de abril de 2026 descreve o Hierarchical Cognitive Caching do ML-Master 2.0, com memória de curto, médio e longo prazo, e relata 56,44% de taxa de medalhas no MLE-Bench após uma execução de 24 horas.
- C e C++Artigo
Memória virtual e desempenho em sistemas intensivos em dados
Publicado em 11 de maio de 2026, o artigo aborda page faults, tabelas de páginas, TLBs, topologia NUMA e internals do Linux como ferramentas para analisar memória e desempenho.
- C e C++Artigo
Memória virtual: fundamentos úteis para equipes de C e C++
Artigo introdutório publicado em 22 de maio de 2026, que aborda paginação, tradução de endereços e o papel da MMU na memória virtual.
- Agentes de IAPesquisa
MemRL aprende a priorizar memórias de agentes em runtime
A descrição publicada em 13 de janeiro de 2026 apresenta o MemRL, uma abordagem que aprende a utilidade de memórias episódicas sem alterar os pesos do modelo de linguagem.
- Aprendizado por reforçoPesquisa
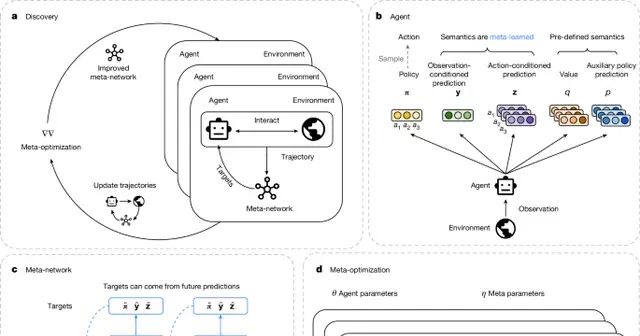
Meta-learning propõe regras de atualização para reinforcement learning
Publicado em 24 de outubro de 2025, o artigo apresenta o DiscoRL, método que aprende regras de atualização de reinforcement learning entre agentes e ambientes e relata resultados de ponta em benchmarks como Atari e ProcGen.
- Aprendizado por reforçoArtigo
Métodos de RL para modelos de raciocínio
Artigo publicado em 16 de março de 2026 reúne métodos de aprendizado por reforço usados com modelos de linguagem, oferecendo uma base para comparação por equipes de engenharia.
- Atenção e arquitetura de modelosProjeto
microGPT em C explora otimizações de baixo nível
Publicado em 3 de maio de 2026, o repositório apresenta uma implementação do microGPT em C puro, sem dependências, com intrinsics AVX2, produtos escalares de largura fixa e uma aproximação rápida da função exponencial.
- Voz: TTS e ASRPublicação
Microsoft anuncia transcrição de áudio longo com diarização
Artigo publicado em 2 de março de 2026 descreve um modelo que, segundo a Microsoft, transcreve até 60 minutos de áudio em uma passagem e oferece suporte a mais de 50 idiomas.
- Atenção e arquitetura de modelosPesquisa
MoDA conecta a atenção entre camadas em LLMs
Publicado em 19 de abril de 2026, o paper apresenta o MoDA, mecanismo que combina pares key-value da camada atual com informações de camadas anteriores.
- OCR e IA para documentosModelo
Modelo de OCR amplia tarefas de compreensão documental
Em post publicado em 25 de novembro de 2025, a Tencent apresentou um modelo de compreensão de documentos com 1 bilhão de parâmetros, voltado a parsing, perguntas sobre imagens e tradução.
- Atenção e arquitetura de modelosPesquisa
Modelos de difusão mascarada e a ordem dos tokens
Um artigo do ICML 2025 analisa por que modelos de difusão mascarada têm desempenho inferior em benchmarks de geração e aponta desafios no treinamento com subconjuntos de tokens.
- C e C++Artigo
Modelos de memória e concorrência em software
Em artigo publicado em 1º de março de 2026, Russ Cox apresenta modelos de memória de hardware como o primeiro tema de uma série sobre modelos de memória.
 arxiv.org
Vamos avaliar seu projeto

Respondo com escopo e proposta.