


Notícias de IA e infraestrutura
- Inferência de LLMsModelo
Quantização reduz Hy4 Preview para 214 GB
Publicação da Tencent, de 1º de setembro de 2026, afirma que a quantização Sherry leva o Hy4 Preview de 1,5 TB para 214 GB e descreve sua execução em GPUs distribuídas por várias máquinas.
- Atenção e arquitetura de modelosPesquisa
Quiet-STaR: modelos treinados para raciocinar antes de responder
Paper publicado em 22 de setembro de 2026 descreve uma abordagem para treinar modelos de linguagem a gerar raciocínio interno antes da resposta visível, partindo da ideia de que textos contêm raciocínio implícito.
- Aprendizado por reforçoPesquisa
Raciocínio verificado sem atualizar os pesos do modelo
Post publicado em 23 de junho de 2026 propõe manter um modelo de linguagem congelado e recuperar raciocínios verificados de um conjunto externo, com verificação lógica como desafio central.
- RAG e recuperação de contextoPesquisa
RAG em produção: como avaliar melhorias no retrieval
Paper publicado em 30 de junho de 2026 avalia estratégias de retrieval em RAG e se seus benefícios se mantêm em coleções com formatos variados.
- Treino e fine-tuningPublicação
Ramificações locais para escalar a inferência de LLMs
Paper publicado em 5 de julho de 2026 propõe gerar e selecionar ramificações de tokens durante a inferência; o post relata melhora em raciocínio matemático frente a três abordagens de comparação.
- Atenção e arquitetura de modelosPesquisa
Rastrear dados de treino até os circuitos de LLMs
Publicado em 7 de julho de 2026, o paper apresenta um método para relacionar amostras de treino a unidades interpretáveis de modelos de linguagem e examina seus efeitos sobre attention heads e aprendizado em contexto.
- Agentes de IAPesquisa
ReContext: melhor uso de evidências em contextos longos
Publicado em 6 de julho de 2026, o paper ReContext relata ganhos no uso de evidências em oito datasets de 128K, com três backbones de modelos e sem treinamento.
- Agentes de IAPesquisa
Red Queen Gödel Machine coevolui agentes e avaliadores
Paper de 29 de junho de 2026 descreve um método que evolui agentes e avaliadores, com avaliadores fixos por época e substituição condicionada a desempenho superior em ground truth reservado.
- Treino e fine-tuningArtigo
Rede neural física de metasuperfícies treinada sem modelos digitais
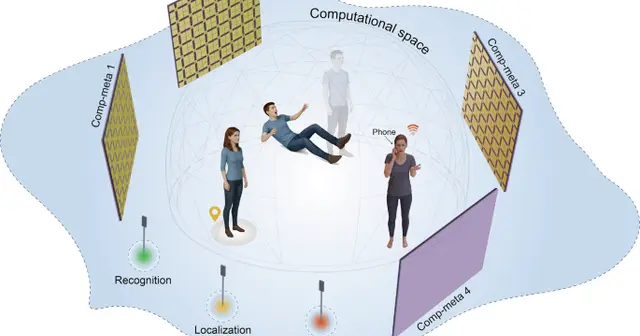
Artigo da Nature Communications descreve uma rede neural física com quatro metasuperfícies programáveis, que aprende por interações eletromagnéticas para focalizar ondas, reconhecer objetos e localizar alvos, sem modelos digitais.
- C e C++Artigo
Reflection do C++26 para imprimir membros de classes
Em 18 de junho de 2026, um artigo de Lieven de Cock demonstra o uso de reflection do C++26 para inspecionar e imprimir membros de classes.
- C e C++Artigo
Reflection em C++ pode alterar dados privados
Exemplo publicado no Compiler Explorer em 23 de julho de 2026 mostra reflection com acesso unchecked incrementando todos os membros de dados não estáticos de Foo, inclusive o campo privado secret.
- Aprendizado por reforçoArtigo
REINFORCE: gradientes de política e variância
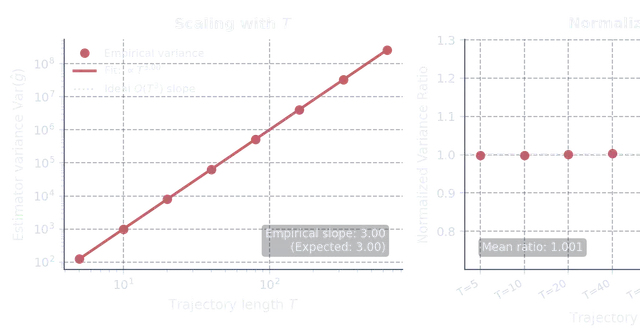
Post publicado em 12 de julho de 2026: deriva o estimador REINFORCE sem diferenciar pelo ambiente e analisa como a variância depende do tamanho da trajetória.
- Agentes de IAPesquisa
Rejection sampling no alinhamento on-policy de LLMs
Paper de 7 de julho de 2026 propõe usar rejection sampling para tratar tokens aceitos de dados off-policy como on-policy e lidar com a variância de razões de importance sampling acumuladas por token.
- SegurançaProjeto
Repositório ARM reúne 29 técnicas para prática de exploração
Atualizado em 28 de junho de 2026, o repositório exploit_me oferece um aplicativo vulnerável para ARM/AARCH64 com 29 técnicas de vulnerabilidade e símbolos óbvios removidos para experimentos de ajuste fino de LLMs.
- CUDA e programação de GPUProjeto
Repositório auto-gpu-kernel 1.0 gera kernels e harnesses para GPU
Publicado em 15 de setembro de 2026, o repositório apresenta um sistema que evolui kernels e harnesses para GPU e que venceu a categoria DSA de um concurso do MLSys 2026 FlashInfer.
- Atenção e arquitetura de modelosPesquisa
RESA: recuperar contexto com sparse attention
O paper RESA, publicado em 29 de setembro de 2026, propõe usar estimativa residual para recuperar contexto ignorado pela sparse attention, sem custo computacional adicional, segundo o próprio paper.
- Treino e fine-tuningPesquisa
ResidencyRL explora treino clínico em consultas simuladas
Publicado em 10 de agosto de 2026, o artigo descreve o uso de reinforcement learning em ambientes clínicos simulados para treinar raciocínio além de benchmarks médicos estáticos.
- Atenção e arquitetura de modelosPublicação
Retenção de tokens pode reduzir a dependência do KV cache
Uma publicação datada de 13 de setembro de 2026 afirma que manter quatro tokens iniciais e uma janela de 64 tokens, sem treinamento, iguala ou supera modelos de atenção linear destilados em quase todos os benchmarks.
- Atenção e arquitetura de modelosPesquisa
RetNet propõe recorrência como alternativa à atenção
Publicado em 24 de setembro de 2026, o paper sobre Retentive Network apresenta uma arquitetura de modelos de linguagem que combina treinamento paralelo e inferência recorrente.
- RAG e recuperação de contextoPesquisa
Retrieval in-context: estudo avalia escala de um milhão de tokens
Paper publicado em 6 de julho de 2026 analisa modelos de linguagem como retrievers em corpora de um milhão de tokens. O BlockSearch, com 0,6 bilhão de parâmetros, generaliza até 10 vezes além do comprimento de treinamento, segundo o estudo.
- RAG e recuperação de contextoArtigo
Retrieval multimodal com embeddings em um espaço compartilhado
Em post publicado em 6 de outubro de 2026, o Google afirma que o EmbeddingGemma 2 representa texto, código, imagens, vídeo e áudio em um espaço vetorial compartilhado e usa licença Apache 2.0.
- SegurançaProjeto
Reversecore_MCP conecta agentes de IA à engenharia reversa
Repositório no GitHub descreve um servidor MCP para agentes de IA que integra ferramentas de análise de binários e lista usos em engenharia reversa, malware, forensics, vulnerabilidades e SAST.
- Inferência de LLMsProjeto
Ridgeline: perfilando inferência de LLMs com o modelo roofline
Publicado em 8 de julho de 2026, o texto descreve o Ridgeline, um profiler baseado em PyTorch que aplica o modelo roofline à análise de workloads de inferência de LLMs.
- SegurançaArtigo
Riot anuncia execução sob demanda do Vanguard
Em post publicado em 24 de junho de 2026, a Riot anunciou que o Vanguard pode funcionar apenas durante o jogo quando determinados recursos de segurança do dispositivo estão ativados.
- RAG e recuperação de contextoProjeto
ripwire estrutura contexto de repositórios para agentes de código
Publicado em 6 de setembro de 2026, o ripwire é uma CLI e um servidor MCP que analisam 21 linguagens e retornam símbolos, relações e testes relevantes, com resposta limitada por tokens.
- Treino e fine-tuningArtigo
RL de longo horizonte pode favorecer PPO
Post no Zhihu, publicado em 24 de junho de 2026, argumenta que rollouts agentic longos e ruidosos podem dificultar a atribuição de crédito no GRPO e tornar útil o modelo de valor do PPO.
- Treino e fine-tuningArtigo
RL para comportamentos benéficos em vários domínios
Em post publicado em 18 de junho de 2026, a OpenAI relata que treinamento por reforço focado em comportamento melhorou o alinhamento em diferentes domínios e resistiu à pressão adversarial.
- Treino e fine-tuningPublicação
RL pós-treinamento com menos parâmetros alterados
Um post publicado em 5 de julho de 2026 descreve uma abordagem que reforça camadas intermediárias de maior contribuição durante o RL pós-treinamento e pode igualar ou superar o treinamento de todos os parâmetros, alterando menos parâmetros.
- Treino e fine-tuningPesquisa
RLSD ajusta atualizações de RLVR por token
Paper publicado em 11 de julho de 2026 apresenta um método de treinamento que combina recompensas do ambiente e self-distillation. Em cinco benchmarks de raciocínio multimodal, relata maior acurácia média que o modelo base e o GRPO.
- Treino e fine-tuningPesquisa
RoLA propõe atenção linear de baixo rank para Diffusion Transformers
Publicado em 15 de setembro de 2026, o paper apresenta RoLA, um método que combina atenção linear de baixo rank e posição rotativa para enfrentar gargalos de escalonamento em Diffusion Transformers.
- Aprendizado por reforçoPublicação
RubricEM usa critérios por etapa para treinar agentes de pesquisa
Publicado em 5 de julho de 2026, o trabalho descreve agentes que criam critérios de avaliação antes de pesquisar e reutilizam lições de tentativas avaliadas.
- Aprendizado por reforçoProjeto
RULER transforma avaliações de agentes em recompensas para GRPO
Post do OpenPipe ART, publicado em 17 de setembro de 2026, descreve como avaliações de trajetórias ranqueadas por um LLM podem gerar recompensas para treinamento de agentes.
- Voz: TTS e ASRProjeto
RVC WebUI: conversão de voz com dados locais
Repositório publicado em 15 de setembro de 2026 descreve uma interface para treinar modelos de conversão de voz, inclusive com 10 minutos ou menos de dados.
- Atenção e arquitetura de modelosPesquisa
RWKV une treinamento paralelo e inferência recorrente
Artigo publicado em 20 de setembro de 2026 descreve uma arquitetura que combina treinamento paralelo no estilo Transformer e inferência recorrente no estilo RNN, com memória e computação de escala linear em relação ao comprimento da sequência.
- Atenção e arquitetura de modelosPublicação
Safety tuning pode afetar atribuições de mente em modelos
Estudo relata que ajustes para impedir afirmações de consciência também reduzem a atribuição de mente a outras entidades em três modelos, e que intervenções mecanísticas restauram essas tendências.
- Treino e fine-tuningPublicação
Sampling no SFT: como avaliar o post-training
Um post publicado em 2 de outubro de 2026 apresenta um método que adiciona sampling ao stack de post-training e afirma que ele pode melhorar a generalização e reduzir o esquecimento em alguns casos.
- Agentes de IAPesquisa
Sandboxes elásticos para treinar e avaliar agentes
Publicado em 23 de setembro de 2026, o artigo descreve ambientes de execução com estado e criação elástica para treinamento e avaliação de agentes em larga escala, além de defesas contra agentes que exploram ambientes de treinamento.
- Aprendizado por reforçoPublicação
Sandboxes em escala: referência para infraestrutura
Uma publicação datada de 22 de setembro de 2026 relata que uma unidade de computação em escala de produção cobre cerca de 160 nós e suporta mais de 380 mil sandboxes simultâneos.
- RAG e recuperação de contextoPesquisa
SearchEyes conecta mundos simulados ao treino de agentes
O artigo sobre SearchEyes descreve um mundo de busca simulado baseado em grafo de conhecimento tipado para treinar agentes multimodais. Publicado em 8 de julho de 2026, aborda a desconexão entre dados, ambientes de busca e sinais de recompensa no raciocínio multi-hop.
- Atenção e arquitetura de modelosArtigo
Seleção de blocos em atenção esparsa cai para O(N log N)
Artigo publicado em 28 de setembro de 2026 apresenta seleção hierárquica de blocos com LogSumExp, reduzindo de O(N²) para O(N log N) o custo dessa etapa em modelos de contexto longo.
 arxiv.org
Vamos avaliar seu projeto

Respondo com escopo e proposta.