


Notícias de IA e infraestrutura
- Aprendizado por reforçoPesquisa
Self-Distillation On-Policy para raciocínio em LLMs
Paper datado de 28 de setembro de 2026 descreve um método de treinamento que combina trajetórias geradas pelo student com supervisão densa de um teacher em cada token.
- Treino e fine-tuningArtigo
Self-play para pré-treinar modelos sem dados naturais
Paper publicado em 26 de setembro de 2026 investiga pré-treinamento com sequências de bytes geradas por programas e relata transferência para modalidades e tarefas não vistas.
- Treino e fine-tuningPublicação
Self-play sem dados reais: como avaliar a abordagem
Um trabalho datado de 25 de setembro de 2026 explora o pré-treinamento por self-play sem dados reais e relata reduções previsíveis na loss de validação zero-shot em várias modalidades.
- Agentes de IAProjeto
Semantica: grafos de conhecimento e rastros de agentes
Em 8 de agosto de 2026, a publicação sobre o projeto open source Semantica descreve uma infraestrutura self-hosted para transformar dados em grafos de conhecimento e registrar decisões de agentes.
- Agentes de IAPublicação
Serving de agentes: medir gargalos além da inferência
Paper publicado em 21 de agosto de 2026 apresenta o AgentSysBench, com 10 aplicações agentic, e indica que a inferência nem sempre é o principal gargalo de serving.
- Inferência de LLMsPesquisa
Serving de LLM: cache e balanceamento após um ano em produção
Paper publicado em 21 de agosto de 2026 analisa um ano de tráfego de LLM em produção e examina reutilização de prefixos, localidade do cache KV e balanceamento de carga.
- Inferência de LLMsPublicação
Servir modelos entre GPU, RAM e NVMe
Post de 12 de setembro de 2026 relata a execução de um modelo em uma RTX 5090 com 125,7 GiB de RAM e parte dos pesos em NVMe.
- Treino e fine-tuningPesquisa
SFT em LLMs: como acompanhar efeitos e decidir quando parar
Um artigo publicado em 15 de junho de 2026 analisa por que o ajuste supervisionado pode beneficiar modelos menores, mas produzir efeitos inconsistentes ou prejudiciais em LLMs.
- RAG e recuperação de contextoPesquisa
SHIFT propõe gates para conflitos de conhecimento em RAG
Publicado em 29 de junho de 2026, o artigo apresenta uma intervenção nas ativações de redes FFN para equilibrar evidências recuperadas e conhecimento interno do modelo.
- Treino e fine-tuningPublicação
SIGReg de JEPA: conceitos e loop de treinamento
Publicado em 24 de julho de 2026, o guia apresenta números complexos, a fórmula de Euler, o teorema de Cramér–Wold e um loop funcional de treinamento relacionados ao SIGReg de JEPA.
- Treino e fine-tuningPublicação
SIGReg e a repulsão entre pares no treinamento de JEPA
Post datado de 28 de setembro de 2026 descreve como o regularizador SIGReg aproxima um sliced MMD e introduz repulsão entre amostras no batch durante o treinamento de JEPA.
- Treino e fine-tuningProjeto
slime: framework aberto para pós-treinamento de LLMs
Publicado em 19 de junho de 2026, o repositório da THUDM apresenta um framework para pós-treinamento de modelos de linguagem com aprendizado por reforço e scaling.
- Atenção e arquitetura de modelosPesquisa
Softmax Linear Attention busca seleção mais relevante com custo linear
Publicado em 16 de setembro de 2026, o artigo propõe aplicar softmax no nível das heads para recuperar a competição global na linear attention, mantendo a complexidade linear.
- Inferência de LLMsPesquisa
Speculative decoding pode reduzir etapas na inferência
Um artigo datado de 20 de setembro de 2026 descreve uma técnica que combina propostas de um modelo eficiente com verificação paralela por um modelo maior para acelerar a geração sem alterar a distribuição de saída.
- C e C++Artigo
Spinlocks: reduzir trocas de contexto sem ignorar contenção
Artigo de 11 de setembro de 2026 sobre otimização de spinlocks: manter threads ocupadas na CPU pode evitar chamadas de sistema e trocas de contexto, mas exige avaliar os efeitos no desempenho.
- RAG e recuperação de contextoPesquisa
STEB compara embeddings de estilo em 96 conjuntos de dados
Publicado em 1º de julho de 2026, o post apresenta um benchmark open source que avalia embeddings de estilo em 96 conjuntos de dados e sete idiomas.
- Inferência de LLMsProjeto
Strata leva inferência local de MoE a GPUs com 8 GB
Em 1º de outubro de 2026, a página do repositório Strata descreveu a execução do modelo MoE Qwen3.8-Flash-Next, de 125 bilhões de parâmetros, em GPUs NVIDIA com pelo menos 8 GB de VRAM.
- Inferência de LLMsPesquisa
StreamDQ leva desquantização de LLMs para a memória HBM
Paper publicado em 13 de julho de 2026 apresenta uma arquitetura que desquantiza pesos de LLMs em tempo real no die base da HBM, preservando a semântica convencional de load da GPU.
- Agentes de IAPublicação
Survey mapeia autoaperfeiçoamento de agentes de IA
Publicado em 19 de julho de 2026, o survey analisa 239 papers sobre melhorias em agentes por meio de atualizações do modelo ou de componentes como prompts, memória e ferramentas.
- Inferência de LLMsPesquisa
SVD-LLM propõe compressão de modelos com ajuste após truncamento
O artigo, publicado em 26 de setembro de 2026, apresenta um método de compressão de LLMs com SVD que atualiza os pesos comprimidos após o truncamento de valores singulares.
- Atenção e arquitetura de modelosPublicação
SwiLA propõe alternar entre mapas lineares de atenção
Paper apresentado como trabalho da COLM 2026 e datado de 5 de outubro de 2026, descreve uma abordagem que alterna entre múltiplos mapas lineares e destaca o trade-off entre expressividade e memória.
- Inferência de LLMsPesquisa
Switch Attention alterna atenção full e windowed
Paper datado de 16 de setembro de 2026 apresenta uma abordagem dinâmica e granular para combinar atenção full e sliding window em transformers híbridos.
- CUDA e programação de GPUArtigo
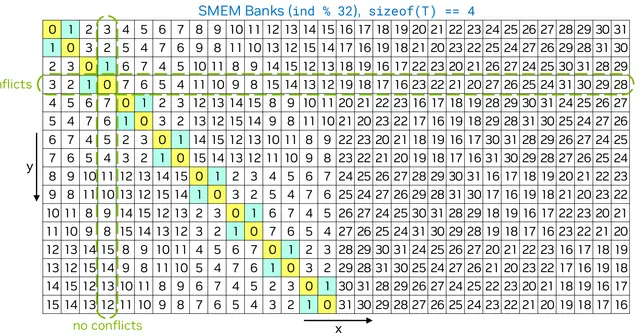
Swizzling para reduzir conflitos na shared memory CUDA
Artigo técnico datado de 13 de agosto de 2026 aborda o uso de swizzling para lidar com conflitos de bancos na shared memory do CUDA, que podem afetar o desempenho de kernels.
- CUDA e programação de GPUProjeto
Symmetric memory pode otimizar comunicação em GPU
Post do Machine Learning Engineering Open Book, publicado em 5 de outubro de 2026, aborda symmetric memory no NCCL e no PyTorch e seu potencial para payloads pequenos e médios e para sobrepor comunicação e computação.
- Treino e fine-tuningPesquisa
TAPA propõe atenção de fase sensível a tokens para contextos longos
Publicado em 26 de junho de 2026, o paper apresenta o Token-Aware Phase Attention (TAPA), um método de positional encoding com função de fase treinável, e o compara ao RoPE em contextos longos.
- RAG e recuperação de contextoProjeto
Tencent lança modelos multimodais WeMM-Embedding
Em 26 de agosto de 2026, a Tencent anunciou uma família de modelos de embeddings para busca e recomendação de texto, imagens e vídeos. Empresas podem avaliar a recuperação multimodal em seus próprios dados.
- Atenção e arquitetura de modelosPesquisa
Teoria do deep learning para analisar o comportamento de modelos
Livro publicado em 24 de junho de 2026 apresenta uma estrutura teórica para relacionar arquitetura e treinamento de redes neurais profundas às saídas dos modelos.
- C e C++Artigo
The Deadlock Empire transforma concorrência em jogo
Publicado em 12 de setembro de 2026, o texto apresenta um jogo em que participantes assumem o papel de scheduler e exploram programas com falhas para aprender sobre concorrência.
- Treino e fine-tuningBase de dados
The Stack v3: dataset de código com 5 trilhões de tokens
O The Stack v3 reúne cerca de 5 trilhões de tokens de código em 713 linguagens filtradas e 224 milhões de repositórios, com coleta do GitHub concluída até agosto de 2025.
- Agentes de IAPublicação
ThetaEvolve: aprendizado em tempo de teste
Publicado em 11 de julho de 2026, o framework open source ThetaEvolve combina aprendizado in-context e aprendizado por reforço em tempo de teste para explorar problemas abertos de otimização.
- Treino e fine-tuningPublicação
TinyLoRA testa ajuste por reforço com 13 parâmetros
Post publicado em 17 de setembro de 2026 descreve uma técnica que usa 13 parâmetros treináveis e relata ganhos em três benchmarks matemáticos.
- Inferência de LLMsProjeto
TinyRouter explora roteamento entre modelos abertos
Publicação datada de 4 de julho de 2026 descreve um roteador de cerca de 10 mil parâmetros e relata resultados em benchmarks, com necessidade de mais experimentos.
- SegurançaPublicação
Tokens do Windows e riscos de escalada de privilégios
Publicado em 27 de junho de 2026, o texto explica como a estrutura _TOKEN do kernel do Windows representa identidade e atributos de segurança e como sua substituição foi usada historicamente para obter privilégios SYSTEM.
- Treino e fine-tuningPublicação
TR-DPO limita desvios no treinamento com DPO
Publicação de 21 de setembro de 2026 descreve uma penalidade de divergência KL na loss do DPO para limitar o desvio em relação ao modelo de referência e estabilizar o treinamento offline.
- SegurançaArtigo
Tradecraft Garden apresenta ferramenta para testar evasão e detecção
Em 30 de junho de 2026, a Tradecraft Garden publicou um post sobre o Crystal Palace, um linker que transforma e randomiza código, gera regras YARA e oferece módulos reutilizáveis de tradecraft.
- Voz: TTS e ASRPublicação
Transcrição de fala: como avaliar um novo modelo
Em artigo publicado em 3 de setembro de 2026, a Microsoft apresenta o MAI-Transcribe-2, com suporte a 60 idiomas, diarização de falantes e timestamps por palavra.
- Voz: TTS e ASRDemonstração
Transcrição de um locutor em fala sobreposta
Um Space publicado em 15 de setembro de 2026 demonstra transcrição condicionada por locutor: um trecho de áudio ajuda a isolar a voz desejada quando há falas simultâneas.
- Voz: TTS e ASRPublicação
Transcrição e diarização em um modelo de streaming
Uma publicação de 3 de setembro de 2026 descreve um modelo de streaming que reúne transcrição de fala e diarização, identificando quem fala, em um único modelo.
- Atenção e arquitetura de modelosPesquisa
Transformer: da atenção à implementação
O capítulo 8 de Speech and Language Processing percorre os componentes do Transformer, da intuição à formulação matricial, e oferece uma base para avaliar como essa arquitetura se relaciona a aplicações empresariais.
- Atenção e arquitetura de modelosPesquisa
Transformers: atenção e custos computacionais
Artigo publicado em 2 de agosto de 2026 explica componentes matemáticos dos Transformers e aborda técnicas para reduzir custos de processamento e memória na attention.
 arxiv.org
Vamos avaliar seu projeto

Respondo com escopo e proposta.