


Notícias de IA e infraestrutura
- Atenção e arquitetura de modelosPesquisa
Memory Attention propõe memória de tokens para calcular valores
Em post publicado em 25 de setembro de 2026, Memory Attention combina memória de tokens específica por camada e keys contextuais para formar os valores da atenção, com possível redução do KV cache e offloading para CPU.
- Atenção e arquitetura de modelosPublicação
Memory Attention: reutilizar keys em V=K+M
Publicação de 27 de setembro de 2026 relata resultados preliminares de ablação que apontam V=K+M como uma escolha arquitetural eficaz; falta validar a abordagem em escalas maiores.
- HardwarePublicação
Meta descreve técnicas para acelerar o armazenamento
Publicada em 5 de julho de 2026, a publicação da Meta apresenta uma arquitetura de armazenamento e técnicas de desempenho, incluindo localidade de dados, caches unificados e prefetch.
- Atenção e arquitetura de modelosPesquisa
MiniCPM-SALA combina atenção esparsa e linear para contextos longos
Um paper apresenta uma arquitetura híbrida de 9 bilhões de parâmetros e relata bons resultados em benchmarks de contexto longo, com inferência escalável até 1 milhão de tokens.
- Atenção e arquitetura de modelosPesquisa
Mixture-of-Depths ajusta o compute por token em Transformers
Artigo de 22 de setembro de 2026 apresenta um método que distribui o compute entre posições da sequência e limita a participação de tokens em cada camada.
- Agentes de IAPesquisa
Modelos byte e token: resultados de escala até 1 trilhão de bytes
Paper publicado em 14 de setembro de 2026 compara modelos byte e token destilados e relata um teto de desempenho maior para modelos byte conforme cresce o compute.
- Atenção e arquitetura de modelosPublicação
Modelos de fluxo refinam raciocínio em etapas
Paper datado de 17 de setembro de 2026 transforma um modelo de fluxo em modelo recorrente: previsões são realimentadas para refinamento iterativo, com uma função de perda local em cada etapa e sem retropropagação ao longo do tempo.
- Atenção e arquitetura de modelosArtigo
Modelos de linguagem por difusão: técnicas e aplicações
Publicado em 8 de julho de 2026, o post do Kuleshov Group apresenta modelos de linguagem por difusão e aborda masked diffusion, refinamento iterativo, pós-treinamento e geração de comprimento variável.
- Treino e fine-tuningPesquisa
Mol-JEPA explora dados multimodais para modelos moleculares
Post publicado em 25 de agosto de 2026 relata que o Mol-JEPA aprende com estruturas moleculares, fenótipos celulares e afinidades de ligação, com ganhos fora da distribuição em pequenos conjuntos de dados de ADME.
- C e C++Projeto
Movfuscator limita código C à instrução MOV
Publicado em 17 de agosto de 2026, o repositório apresenta um compilador de C que gera assembly Turing-completo usando apenas MOV, um caso útil para avaliar ferramentas de análise de código.
- RAG e recuperação de contextoPesquisa
NapMem propõe navegação ativa pela memória conversacional
Artigo publicado em 8 de julho de 2026 apresenta o NapMem, framework que organiza o histórico do usuário em uma pirâmide de memória vinculada e com múltiplas granularidades.
- Atenção e arquitetura de modelosPesquisa
Native Hybrid Attention e o equilíbrio em contextos longos
Artigo publicado em 5 de outubro de 2026 apresenta Native Hybrid Attention, uma abordagem voltada ao equilíbrio entre velocidade em contextos longos e retenção de detalhes. Empresas podem avaliar a proposta com benchmarks ligados às suas tarefas.
- Agentes de IAPesquisa
NatureBench avalia agentes de programação em pesquisa
Publicado em 24 de junho de 2026, o post descreve um benchmark com 90 tarefas baseadas em artigos da família Nature. O melhor agente superou o resultado publicado de referência em 17,8% das tarefas.
- RAG e recuperação de contextoPesquisa
Negativos difíceis para retrieval two-tower
Paper publicado em 2 de julho de 2026 propõe usar clusters de itens derivados de LLM para gerar, em tempo real, negativos difíceis em modelos two-tower de recomendação.
- Atenção e arquitetura de modelosPublicação
NextLat explora previsão do próximo estado latente
Publicação de 16 de junho de 2026 descreve um método de treinamento para transformers e afirma que ele pode viabilizar modelos compactos e inferência até 3,3 vezes mais rápida.
- Treino e fine-tuningPublicação
NoRA propõe normalizar A na inicialização do LoRA
Post de 2 de setembro de 2026 descreve uma inicialização que normaliza as colunas de A no LoRA e relata resultados médios superiores aos de vários métodos de adaptação em SFT e RLVR.
- Agentes de IAProjeto
Notebooks de código exploram padrões de design de agentes
Publicado em 25 de agosto de 2026, o guia de Antonio Gulli apresenta notebooks para explorar padrões como encadeamento de prompts, roteamento, reflexão, uso de ferramentas, planejamento e sistemas multiagentes.
- Agentes de IAPesquisa
NOVA aplica agents verificados a sistemas de recomendação
Descrição publicada em 26 de junho de 2026 apresenta um harness de agents para evoluir arquiteturas de recomendação, respeitando restrições de domínio, interface, recursos e serving.
- OCR e IA para documentosPublicação
Novos modelos de OCR ampliam opções para documentos
Post publicado em 18 de setembro de 2026 apresenta WeVisDoc 2B e 4B, sob Apache 2.0, e jina-ocr-v1, com licença não comercial. WeVisDoc-4B obteve 95,38 no OmniDocBench v1.6; NaviDC-OCR é apontado como o atual SOTA.
- Voz: TTS e ASRPublicação
NVIDIA apresenta diarização para falas sobrepostas
Anúncio datado de 23 de setembro de 2026: o Nemotron 3 Diarization identifica quem falou e quando, inclusive em falas sobrepostas, e suporta até oito interlocutores.
- Atenção e arquitetura de modelosArtigo
O papel da cadeia de pensamento em tarefas seriais
Artigo de 1º de outubro de 2026 investiga se a cadeia de pensamento contribui para o cálculo em Transformers e relata queda de precisão quando ela é removida de tarefas seriais.
- CUDA e programação de GPUPublicação
O que acontece ao lançar um kernel CUDA
Post publicado em 11 de julho de 2026 sobre a comunicação entre CPU e GPU necessária para lançar um kernel CUDA e o trabalho envolvido nessa operação.
- Treino e fine-tuningArtigo
O que o pré-treinamento de um modelo MoE exige na prática
Publicado em 20 de agosto de 2026, o relato documenta uma tentativa de pré-treinar um modelo MoE de 1,02 bilhão de parâmetros em uma H200, incluindo pipeline de dados, falhas e ajustes de throughput.
- SegurançaProjeto
Obfuscação de C em tempo de compilação no Windows
O repositório obfus.h descreve um macro header para ofuscar código C em tempo de compilação no Windows x86/x64 com tcc, incluindo virtualização, anti-debugging e ofuscação do fluxo de controle.
- OCR e IA para documentosProjeto
OCR de documentos longos em uma única passagem
Post publicado em 23 de junho de 2026 descreve um modelo de OCR que processa documentos com mais de 40 páginas em uma passagem e mantém constante o tamanho do KV Cache.
- OCR e IA para documentosProjeto
OCR local no iPhone com acesso por API na rede
Post publicado em 26 de agosto de 2026 descreve o iOS-OCR-Server, projeto open source que usa o framework Vision da Apple para processar OCR localmente em um iPhone e expor uma API a dispositivos na mesma rede.
- Agentes de IAProjeto
Octop combina agentes multiusuário e hospedagem própria
Post da Tencent Cloud, publicado em 15 de setembro de 2026, apresenta o Octop, uma plataforma open source e self-hosted de assistentes de IA com dados locais e integrações para equipes.
- Voz: TTS e ASRProjeto
OmniVoice: síntese e clonagem de voz em mais de 600 idiomas
Uma publicação de 6 de setembro de 2026 descreve um projeto Python de síntese de fala com clonagem zero-shot, compatível com mais de 600 idiomas e controles de voz configuráveis.
- Treino e fine-tuningPesquisa
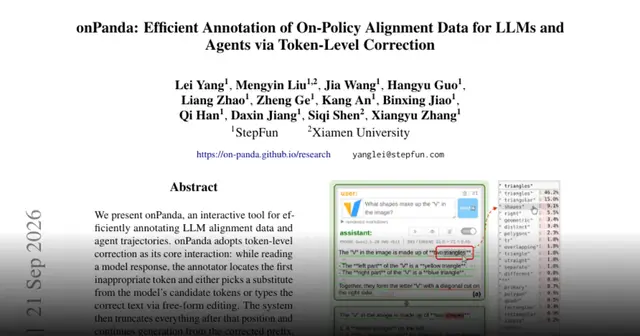
onPanda permite anotar tokens e inspecionar modelos
Publicado em 22 de setembro de 2026, o repositório onPanda apresenta uma ferramenta open source para anotação de dados de LLMs e inspeção de modelos.
- Atenção e arquitetura de modelosArtigo
OPAL reduz o custo de attention em contextos longos
Post de 29 de setembro de 2026 descreve o OPAL, método que treina modelos de linear attention com as próprias saídas e relata recuperação total em retrieval e 83–93% do desempenho em raciocínio matemático.
- Treino e fine-tuningPesquisa
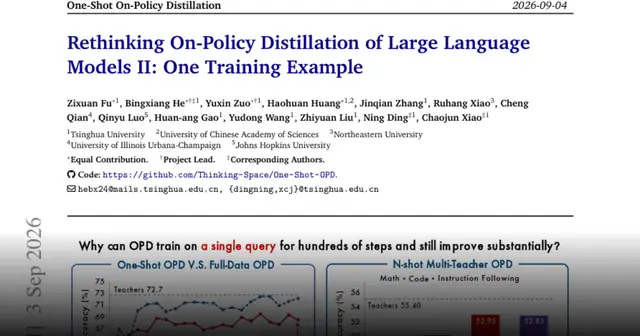
OPD com uma única consulta: o que o paper propõe
Datado de 29 de setembro de 2026, o paper testa destilação on-policy com uma única consulta em matemática, código, seguimento de instruções e uso de ferramentas por agentes.
- Atenção e arquitetura de modelosProjeto
OpenMythos explora Transformer de profundidade recorrente
Publicado em 19 de junho de 2026, o repositório apresenta uma reconstrução teórica de código aberto com profundidade recorrente, roteamento MoE e halting adaptativo por token.
- Agentes de IAProjeto
OpenShell propõe runtime seguro para agentes autônomos
Publicado em 28 de setembro de 2026, o repositório no GitHub descreve o OpenShell como um runtime voltado à segurança e à privacidade de agentes de IA autônomos.
- Aprendizado por reforçoArtigo
Operadores de contração em RL: do conceito ao aprendizado interno
Artigo publicado em 12 de setembro de 2026 apresenta uma abordagem visual e concisa para explicar operadores de contração, conceito fundamental de aprendizado por reforço.
- Agentes de IAArtigo
Ornith-1.0: modelos abertos para agentes de programação
Anunciada em 25 de junho de 2026, a família Ornith-1.0 reúne modelos de 9B a 397B parâmetros, treinados com aprendizado por reforço para otimizar código e estruturas de orientação dos agentes.
- Treino e fine-tuningPesquisa
ORPO reúne SFT e alinhamento de preferências em uma etapa
Publicado em 19 de setembro de 2026, o paper apresenta o ORPO, método que combina supervised fine-tuning e otimização de preferências sem um modelo de referência.
- Agentes de IAPesquisa
Orquestração de agentes pode reduzir custos e latência
Publicado em 13 de julho de 2026, o paper relata que mudanças na orquestração reduziram custos e latência, mantendo qualidade equivalente em 22 tarefas e seis modelos.
- Treino e fine-tuningPublicação
Ostris AI Toolkit passa a treinar LoRAs para MiniMax H3
Em 3 de agosto de 2026, o repositório Ostris AI Toolkit anunciou suporte ao treinamento de LoRAs para MiniMax H3, limitado a fluxos de texto para vídeo e imagem para vídeo, com uso de pesos quantizados do Comfy.
- Aprendizado por reforçoArtigo
Otimizar objetivos avaliáveis sem recorrer a RL
Post de 27 de agosto de 2026 inicia uma série sobre alternativas ao aprendizado por reforço e apresenta métodos de amostragem para otimizar objetivos avaliáveis.
- Agentes de IAPesquisa
PACE prevê desempenho de agentes com poucas tarefas
Post de 6 de julho de 2026 apresenta um método para estimar resultados de agentes com um conjunto pequeno de tarefas e custo menor que o de uma avaliação completa.
 arxiv.org
Vamos avaliar seu projeto

Respondo com escopo e proposta.