


Notícias de IA e infraestrutura
- Agentes de IAPesquisa
JAZ explora agentes com uma única primitiva de código
Publicado em 26 de setembro de 2026, o post descreve o framework JAZ e relata resultados em StuLife e AppWorld, com custos menores que os das abordagens comparadas.
- Treino e fine-tuningPesquisa
JEPA-Anything explora aprendizado preditivo em sete domínios
O post, publicado em 6 de outubro de 2026, apresenta o JEPA-Anything como framework agnóstico a domínio para modelagem de mundos, baseado em fatoração preditiva ortogonal.
- Inferência de LLMsPesquisa
JetSpec acelera speculative decoding com draft trees paralelas
Post publicado em 7 de julho de 2026 descreve o JetSpec, que usa um único forward pass para gerar draft trees coerentes e relata ganhos de até 9,64× no MATH-500 e 4,58× em conversas abertas.
- Agentes de IAPesquisa
JIT-Agent adapta harnesses de agentes à tarefa
O artigo sobre o JIT-Agent descreve a síntese sob demanda e a evolução de harnesses para agentes baseados em LLMs, com módulos de memória, planejamento, ações e ferramentas. Publicado em 27 de agosto de 2026.
- Atenção e arquitetura de modelosPesquisa
KATA explora spherical packing para recall em linear attention
Artigo publicado em 16 de setembro de 2026 apresenta KATA, uma abordagem geométrica que formula o associative recall em linear attention como um problema de spherical packing.
- RAG e recuperação de contextoPesquisa
KbSD propõe calibrar decisões de busca em agentes
Publicado em 30 de junho de 2026, o paper descreve um método de self-distillation para orientar agentes de busca entre usar a memória do modelo, evidências recuperadas ou abster-se.
- Atenção e arquitetura de modelosArtigo
Kernel de atenção paginada em Triton para inspeção técnica
Publicação de 10 de julho de 2026 compartilha um kernel de atenção paginada em Triton atribuído a um modelo de IA e um arquivo de solução no KernelBench.
- Atenção e arquitetura de modelosPesquisa
KITE amplia Transformers sem aumentar o cálculo de KV
Publicado em 29 de setembro de 2026, o material descreve o KITE, uma abordagem que amplia componentes do decoder reutilizando um KV cache gerado por um prefiller menor.
- Treino e fine-tuningProjeto
KohakuFA propõe alternativa para precisão no backward
Em 3 de outubro de 2026, uma publicação apresenta o kernel KohakuFA como alternativa diante de problemas de precisão atribuídos a cuDNN, FA4 e FlexAttention nos backward passes.
- Inferência de LLMsPesquisa
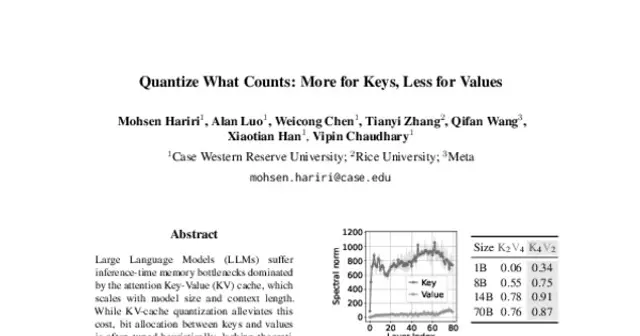
KV cache: mais bits para keys que para values
Artigo da ACL 2026 examina a compressão do KV cache e relata que usar 4 bits para keys e 2 para values pode funcionar bem, enquanto inverter essa distribuição degrada bastante a precisão.
- Inferência de LLMsPublicação
KV Cache: por que queries não ficam armazenadas
Post de 30 de agosto de 2026 distingue o uso temporário de queries do armazenamento de keys e values no KV cache durante a inferência.
- Treino e fine-tuningProjeto
Kyutai abre o stack de treinamento do Pocket TTS
Em 25 de agosto de 2026, a Kyutai publicou o stack de treinamento do Pocket TTS, com pipeline de dados, receitas de treinamento e avaliações para um modelo de síntese de fala executável em CPU.
- CUDA e programação de GPUPublicação
Latency hiding em GPUs: medir antes de otimizar
Capítulo de Vasily Volkov, da UC Berkeley, publicado em 4 de julho de 2026, sobre como GPUs ocultam latência e conceitos de arquitetura ligados ao desempenho.
- Aprendizado por reforçoPesquisa
LED explora camadas intermediárias em modelos de raciocínio
Artigo publicado em 10 de julho de 2026 relata que o Latent Exploration Decoding usa distribuições de camadas intermediárias para ampliar a exploração sem treinamento adicional.
- Aprendizado por reforçoPesquisa
LENS combina raciocínio e segmentação de imagens com RL
O artigo apresenta o LENS, um framework que usa aprendizado por reforço para otimizar o raciocínio e a segmentação de imagens a partir de texto.
- C e C++Documentação
Libuv: event loops e código assíncrono em C e C++
Um post publicado em 8 de agosto de 2026 apresenta o event loop do libuv, aponta semelhanças conceituais com outros sistemas de event loop e destaca sua utilidade para analisar código assíncrono em C e C++.
- Atenção e arquitetura de modelosArtigo
LiFT amplia a inferência iterativa com um núcleo DiT compartilhado
Publicada em 6 de outubro de 2026, a pesquisa relata que LiFT supera um baseline DiT denso no ImageNet 256×256 com cerca de 60% menos parâmetros.
- Voz: TTS e ASRPublicação
Limpeza de áudio local no Raspberry Pi 5: como avaliar a aplicação
Uma postagem de 22 de junho de 2026 apresenta um modelo de 49 mil parâmetros para cancelamento de eco, supressão de ruído e redução de reverberação, com desempenho declarado de 21× em tempo real em um núcleo do Raspberry Pi 5.
- C e C++Artigo
Linux perf: profiling e tracing de desempenho
Post de 27 de junho de 2026 apresenta exemplos de Linux perf (perf_events) para análise de desempenho e debugging, usando tracepoints, kprobes/uprobes, PMCs e eventos de software.
- Inferência de LLMsProjeto
Livro aberto reúne 12 capítulos sobre infraestrutura de IA
Publicado em 13 de setembro de 2026, o livro percorre arquiteturas de modelos, aceleradores, inferência e treinamento. Sua abrangência ajuda empresas a identificar desafios concretos de infraestrutura.
- CUDA e programação de GPUArtigo
Livro da CMU aborda programação de GPUs para sistemas de ML
Publicado em 23 de junho de 2026, o livro online reúne material de uma minissérie do curso de ML Systems da CMU sobre técnicas de programação de GPUs.
- Atenção e arquitetura de modelosPesquisa
LoopCD aproveita loops anteriores na decodificação
Publicado em 2 de outubro de 2026, o artigo apresenta o LoopCD, método sem treinamento que usa representações de loops anteriores para orientar a seleção de tokens em Looped Transformers.
- Atenção e arquitetura de modelosArtigo
LoopCD refina a decodificação de Transformers sem novo treinamento
O artigo, publicado em 2 de outubro de 2026, apresenta uma técnica que compara previsões de estados recorrentes iniciais e finais para refinar a decodificação. Relata maior acurácia no AIME 2024 com Ouro-2.6B-Thinking.
- Atenção e arquitetura de modelosArtigo
Looped-DiT reutiliza blocos para reduzir computação
Um post publicado em 1º de outubro de 2026 afirma que o Looped-DiT superou um modelo 6,5 vezes maior em benchmarks de geração de imagens, com 4,9 vezes menos computação na inferência.
- Atenção e arquitetura de modelosPesquisa
Looped flows treinam atualizações recorrentes com denoising local
Paper publicado em 12 de setembro de 2026 propõe objetivos de denoising local para treinar atualizações recorrentes do estado oculto, inclusive quando o backpropagation cobre poucas etapas.
- Treino e fine-tuningPesquisa
LoRA+ propõe taxas distintas para matrizes adapter
Artigo de 24 de setembro de 2026 analisa como a mesma taxa de aprendizado para as matrizes A e B pode prejudicar o aprendizado de features em modelos largos e propõe usar taxas diferentes no fine-tuning.
- Treino e fine-tuningProjeto
MaAI amplia os dados de treino do modelo VAP em inglês
Em post publicado em 6 de setembro de 2026, a MaAI informa que treinou seu modelo VAP em inglês com uma escala maior de dados. O projeto prevê sinais de conversação e movimentos de cabeça em tempo real.
- Atenção e arquitetura de modelosPesquisa
Mamba e Transformers: uma conexão por trás das arquiteturas
Artigo publicado em 24 de setembro de 2026 explora conexões teóricas entre modelos de espaço de estados, como Mamba, e variantes de attention.
- Atenção e arquitetura de modelosArtigo
Matryoshka Attribution localiza pesos ligados a comportamentos de modelos
Em post publicado em 28 de setembro de 2026, Matryoshka Attribution é apresentada como uma técnica para classificar representações neurais e mudanças de pesos por sua influência no comportamento.
- RAG e recuperação de contextoPesquisa
MaxSim e a capacidade de representar produtos internos
Um artigo datado de 8 de julho de 2026 mostra que MaxSim pode replicar exatamente produtos internos entre vetores não negativos k-esparsos, oferecendo uma base teórica para sistemas de recuperação com late interaction.
- Atenção e arquitetura de modelosPesquisa
Megalodon e a avaliação de sequências longas
Artigo publicado em 24 de setembro de 2026 apresenta uma arquitetura baseada no Mega, projetada para pré-treinamento e inferência eficientes com contexto ilimitado.
- Agentes de IAPesquisa
MemoHarness adapta agentes com histórico de execuções
Publicado em 17 de julho de 2026, o trabalho apresenta um método que ajusta seis dimensões do harness de agentes usando execuções anteriores. Em um benchmark de agentes de shell, obteve 0,806, ante 0,722 do baseline fixo mais forte.
- Atenção e arquitetura de modelosArtigo
Memória compartilhada reduz o uso de memória em Transformers recorrentes
Artigo publicado em 5 de outubro de 2026 relata redução de 76–79% na memória de contexto e melhora de qualidade em modelos de 150 milhões a 1 bilhão de parâmetros.
- Agentes de IAPesquisa
Memória de agentes com modelo congelado
Em post publicado em 26 de agosto de 2026, a Recuris descreve dois loops de memória e um meta-agente fixo que propõe reparos com base nos traces de execução, sem alterar os pesos do modelo.
- Atenção e arquitetura de modelosPesquisa
Memória esparsa amplia o estado de RNNs sem elevar o compute por token
Publicado em 11 de julho de 2026, o post descreve a Sparse Delta Memory, que combina uma RNN com memória explícita de endereçamento esparso para aumentar a capacidade de estado mantendo constante o compute por token.
- CUDA e programação de GPUArtigo
Memória heterogênea: verificações de capacidade no compilador
Em post publicado em 28 de setembro de 2026, Vx descreve um modelo de máquinas baseado em capacidade, conexões e visibilidade e relata dois erros de capacidade encontrados em um laptop sem GPU.
- Atenção e arquitetura de modelosArtigo
Memória indexada por token muda a atenção em Transformers
Um post publicado em 25 de setembro de 2026 descreve uma arquitetura que soma chaves contextuais e vetores de memória indexados por token, específicos de cada camada, e permite manter a memória na CPU.
- Agentes de IAPesquisa
Memória proativa para agentes de horizonte longo
Um paper descreve um agente de memória separado que mantém registros estruturados e decide quando apresentar lembretes ao agente de ação. A abordagem foi avaliada no Terminal-Bench 2.0 e no tau-squared-Bench.
- Agentes de IAPesquisa
Memória recorrente para agentes de contexto longo
Paper publicado em 29 de setembro de 2026 identifica a retenção como gargalo em agentes com memória recorrente e apresenta uma abordagem sem treinamento que seleciona um memory head e preserva os demais.
- Atenção e arquitetura de modelosPesquisa
Memory Attention propõe memória de tokens para calcular valores
Em post publicado em 25 de setembro de 2026, Memory Attention combina memória de tokens específica por camada e keys contextuais para formar os valores da atenção, com possível redução do KV cache e offloading para CPU.
 arxiv.org
Vamos avaliar seu projeto

Respondo com escopo e proposta.