


Notícias de IA e infraestrutura
- C e C++Artigo
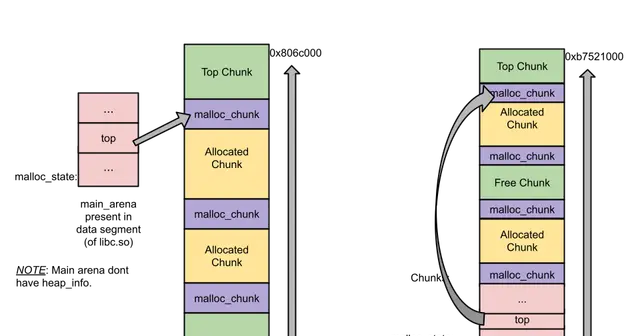
glibc malloc: como observar o uso de memória
Artigo publicado em 25 de junho de 2026 aborda como o glibc malloc obtém memória do kernel e gerencia a heap. A pauta propõe transformar esse conhecimento em observabilidade para serviços que usam memória intensivamente.
- Atenção e arquitetura de modelosPublicação
GLM-5.3-Flash: visão geral da arquitetura
Publicada em 26 de agosto de 2026, a visão geral descreve uma arquitetura híbrida com attention 3:1, backbone sparse MoE menor, residual path mHC com quatro streams e vision encoder nativo.
- Atenção e arquitetura de modelosPesquisa
GOAT propõe priors treináveis para a attention
Publicado em 3 de outubro de 2026, o paper interpreta a attention padrão como um problema de transporte ótimo entrópico com prior uniforme implícito e apresenta o GOAT, com prior contínuo e treinável.
- CUDA e programação de GPUPublicação
GPU de dois núcleos em FPGA de US$ 30: o que avaliar
Publicado em 9 de julho de 2026, o artigo descreve uma GPU de dois núcleos implementada em FPGA de US$ 30, capaz de executar inferência de IA a 81 MHz.
- CUDA e programação de GPUPesquisa
GPU-Tile-Sim propõe simulação de GPU para co-design de LLMs
Publicado em 14 de julho de 2026, o paper propõe um framework de simulação de GPU baseado em tiles para apoiar o co-design de hardware e software de LLMs.
- Atenção e arquitetura de modelosPesquisa
Gradientes BF16 crescem no fim do treinamento
Um artigo relata aumento de 1.000 vezes na norma do gradiente após 25 bilhões de tokens em um transformer treinado com FlashAttention-3 em BF16.
- RAG e recuperação de contextoPesquisa
GraphRAG para perguntas sobre coleções de documentos
Paper publicado em 24 de setembro de 2026 apresenta uma abordagem para responder a perguntas globais sobre um corpus, que a recuperação padrão de trechos pode não atender bem.
- Aprendizado por reforçoArtigo
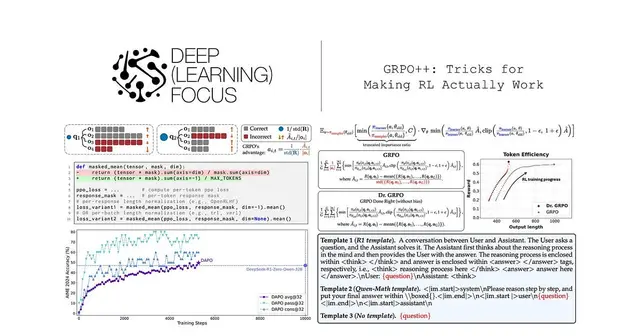
GRPO e OPD: caminhos práticos para post-training
Publicação de 26 de agosto de 2026 apresenta dois recursos sobre post-training com aprendizado por reforço: um sobre escalar o GRPO vanilla e outro dedicado a OPD.
- Aprendizado por reforçoArtigo
GRPO no treinamento de modelos de raciocínio: o guia da Unsloth
Publicado em 26 de setembro de 2026, o guia da Unsloth percorre reinforcement learning do nível iniciante ao avançado e apresenta o uso de GRPO no treinamento de modelos de raciocínio.
- Aprendizado por reforçoArtigo
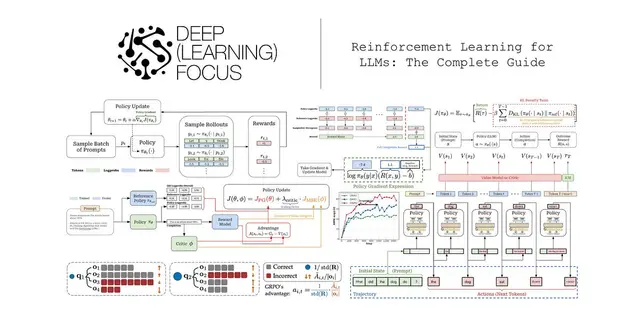
Guia de reinforcement learning para modelos de linguagem
Publicado em 24 de agosto de 2026, o guia relaciona fundamentos de reinforcement learning a métodos de treinamento de modelos de linguagem, incluindo policy gradients, REINFORCE e diferentes formas de definir estados e recompensas.
- Treino e fine-tuningProjeto
GuppyLM: experimento com um modelo de 9 milhões de parâmetros
Em post publicado em 19 de setembro de 2026, o autor descreve o GuppyLM, um modelo de cerca de 9 milhões de parâmetros que, segundo ele, pode ser treinado do zero em cinco minutos.
- Agentes de IAProjeto
Harness amplia opções para agentes usarem browser e computador
A versão v0.1.6-alpha.1, publicada em 15 de setembro de 2026, adiciona terminais persistentes, múltiplas abas, recursos MCP e opções experimentais para uso de browser e computador.
- Agentes de IAArtigo
Harness engineering e os limites do autoaperfeiçoamento de IA
Em artigo publicado em 7 de julho de 2026, Lilian Weng analisa o autoaperfeiçoamento recursivo e aponta o design e a otimização do harness como um ponto de partida prático, com desafios de avaliação, diversidade e segurança.
- Agentes de IAPesquisa
HarnessBank: evolução de harnesses de agentes
Artigo publicado em 17 de julho de 2026 descreve um método para melhorar agentes alterando prompts, ferramentas e loops de controle ao redor do modelo.
- Agentes de IAPesquisa
HASTE mostra como organizar skills para agentes de ML
O material sobre HASTE relata que, em oito competições, o carregamento hierárquico de skills alcançou 100% de medalhas, ante 62,5% com carregamento plano.
- Atenção e arquitetura de modelosPesquisa
HiLS aprende a selecionar chunks para sparse attention
Publicado em 7 de julho de 2026, o artigo apresenta a HiLS, uma abordagem que aprende a selecionar chunks para sparse attention com a loss de modelagem de linguagem.
- Atenção e arquitetura de modelosPesquisa
HOLA combina atenção linear com cache KV exato e limitado
Publicado em 3 de julho de 2026, o artigo apresenta o HOLA: uma arquitetura que combina estado recorrente e cache limitado de key-values, com ganhos relatados em perplexidade e recall de longo alcance.
- Atenção e arquitetura de modelosPesquisa
HOLA combina estado recorrente e cache limitado para contextos longos
Post de 6 de julho de 2026 descreve o HOLA, que usa estado recorrente e um pequeno KV cache para memória exata. O método reduz a perplexidade em 16,1% e mantém recuperação robusta em 32 mil tokens.
- Inferência de LLMsArtigo
Hooks de inferência permitem bloquear prompts antes da execução
Material datado de 11 de agosto de 2026 descreve hooks que enviam prompts a um servidor de segurança da organização, onde são permitidos ou negados antes da inferência.
- Atenção e arquitetura de modelosPublicação
HydraHead combina dois tipos de atenção por head
Publicado em 30 de junho de 2026, o post sobre HydraHead descreve uma arquitetura que combina Full Attention e Linear Attention no nível dos heads para buscar mais eficiência em modelos de contexto longo.
- Atenção e arquitetura de modelosArtigo
HySparse2 propõe compartilhamento de KV em dois níveis
Datado de 27 de setembro de 2026, o paper apresenta um método híbrido de atenção esparsa para reduzir demandas de prefill e compactar o armazenamento de KV cache em agentes com contextos longos.
- Atenção e arquitetura de modelosPesquisa
HySparse2 reduz custo de contexto longo com reuso de KV
Publicado em 23 de setembro de 2026, o post descreve dois níveis de compartilhamento de KV para reduzir FLOPs de prefill e tamanho do cache, com melhores scores de retrieval que o Hybrid SWA do MiMo-V2.6 em contexto de 1 milhão de tokens.
- Atenção e arquitetura de modelosArtigo
IA com profundidade recorrente: desafios para monitorar
Publicação de 2 de setembro de 2026 afirma que a IA Astra usa raciocínio com profundidade recorrente, o que pode dificultar o monitoramento, afetar custos e desempenho e complicar a supervisão.
- HardwarePublicação
IA local: Mac Studio M5 Ultra ou RTX PRO 6000?
Comparação de configurações para IA local destaca diferenças de memória, suporte a CUDA, velocidade de prefill, custo e ruído.
- Treino e fine-tuningProjeto
IFM-AI publica ferramentas abertas para LLMs
Em 28 de setembro de 2026, a IFM-AI anunciou ferramentas de código aberto para pré-treinamento, atenção, conversão de checkpoints e serving de LLMs.
- Atenção e arquitetura de modelosPesquisa
iLLaDA: difusão mascarada em um modelo de 8B
Descrição publicada em 25 de junho de 2026 apresenta o iLLaDA, modelo de linguagem de difusão mascarada de 8B treinado do zero com atenção totalmente bidirecional.
- Atenção e arquitetura de modelosPublicação
iLLaDA treina modelo de difusão com 8 bilhões de parâmetros
Artigo publicado em 27 de junho de 2026 descreve o treinamento de um Transformer de 8 bilhões de parâmetros com difusão mascarada bidirecional em 12 trilhões de tokens.
- Voz: TTS e ASRPublicação
Índice compara modelos de fala em três capacidades
Publicado em 23 de junho de 2026, o índice da Artificial Analysis combina três conjuntos de avaliação para comparar modelos nativos de Speech-to-Speech.
- CUDA e programação de GPUArtigo
Índices de GPU ampliam suporte a PyTorch e Python
Post da Astral, publicado em 5 de outubro de 2026, informa suporte a PyTorch 2.13 e 2.14 e Python 3.15, com wheels para GPU de pacotes como FlashAttention e DeepSpeed.
- Inferência de LLMsProjeto
Inferência de LLMs com VRAM limitada
Post de 17 de julho de 2026 descreve um framework para inferência e fine-tuning heterogêneos, distribuindo experts entre GPU e CPU.
- Aprendizado por reforçoPesquisa
Informação privilegiada pode afetar raciocínios longos em modelos
Artigo datado de 7 de julho de 2026 relata degradação em trajetórias longas de raciocínio após self-distillation com informação privilegiada, em cinco modelos avaliados no AIME.
- SegurançaPublicação
Injeção de prompt em binários analisados com IA
Pesquisa da Naval Postgraduate School, publicada em 12 de julho de 2026, descreve como strings em binários C podem influenciar agentes de engenharia reversa com modelos de linguagem.
- SegurançaArtigo
Inspeção autorizada de tráfego HTTPS com TLS 1.3
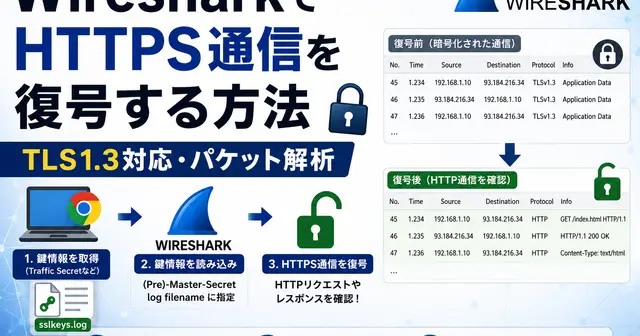
Artigo publicado em 29 de agosto de 2026 explica como registrar segredos de sessão por meio da variável SSLKEYLOGFILE e carregá-los no Wireshark para analisar requisições HTTP capturadas em conexões HTTPS.
- SegurançaPesquisa
Intel atualiza paper sobre proteções de memória
Em 1º de julho de 2026, a Intel atualizou o paper técnico sobre proteções de memória da arquitetura Intel para confidential computing, documento 869103.
- Atenção e arquitetura de modelosPesquisa
Interpretabilidade além dos conceitos humanos
Publicado em 22 de setembro de 2026, o paper investiga se modelos de linguagem usam representações internas que não correspondem adequadamente a conceitos humanos familiares.
- Atenção e arquitetura de modelosPublicação
Interpretabilidade automatizada para heads de atenção
Paper publicado em 29 de junho de 2026 descreve uma técnica que explica heads de atenção com programas Python. Substituir cerca de 40% dos padrões de atenção no Llama-3B por saídas desses programas quase não afetou o desempenho nas tarefas avaliadas.
- SegurançaPesquisa
IO Factory e a detecção de campanhas de influência adaptativas
Artigo publicado em 12 de agosto de 2026 descreve um framework de IA que simula campanhas coordenadas e adaptáveis, e aponta desafios para detectar esse tipo de atividade.
- Treino e fine-tuningPublicação
IW-OPD repondera tokens na destilação on-policy
Post publicado em 30 de junho de 2026 apresenta o IW-OPD, método que dá mais peso aos tokens iniciais na destilação on-policy e relata ganho de 6,9 pontos no AIME-2025 frente ao OPD padrão.
- Atenção e arquitetura de modelosArtigo
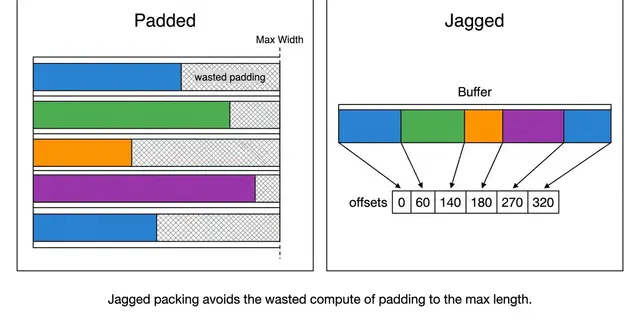
Jagged Flash Attention na NVIDIA Blackwell: lições para otimizar kernels
Em artigo publicado em 1º de outubro de 2026, o blog do PyTorch descreve um kernel de attention desenvolvido com TLX para a NVIDIA Blackwell. Nas formas jagged do Generative Ads Model da Meta, o artigo relata desempenho superior ao FlashAttention-4.
- Atenção e arquitetura de modelosPesquisa
Jamba combina Transformer, Mamba e MoE
O artigo, publicado em 20 de setembro de 2026, descreve uma arquitetura híbrida que intercala blocos Transformer e Mamba e usa mixture-of-experts em algumas camadas.
 arxiv.org
 unsloth.ai
Vamos avaliar seu projeto

Respondo com escopo e proposta.