


Notícias de IA e infraestrutura
- Agentes de IAPesquisa
DiscoBench testa agentes de busca diante de pedidos ambíguos
Publicado em 29 de junho de 2026, o DiscoBench avalia se agentes de busca com modelos de linguagem lidam com solicitações vagas, incompletas ou factualmente incorretas em tarefas de recuperação e raciocínio em várias etapas.
- Treino e fine-tuningPublicação
Distilação de modelos: a direção do KL por token
Estudo sistemático publicado em 3 de outubro de 2026 relata que a direção da divergência KL por token pesa mais que a política de rollout na distilação on-policy e off-policy.
- Aprendizado por reforçoPesquisa
Distilação em duas fases para modelos multitarefa
Paper de 30 de junho de 2026 estuda como consolidar especialistas de aprendizado por reforço em um modelo multitarefa usando distilação off-policy e on-policy.
- Aprendizado por reforçoPublicação
Distilação on-policy para combinar modelos especialistas
A técnica MOPD treina um modelo student com suas próprias respostas e usa probabilidades por token de vários teachers para transferir capacidades especializadas.
- Voz: TTS e ASRArtigo
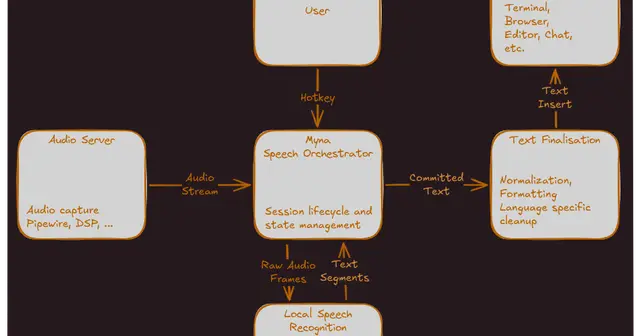
Ditado local no Ubuntu: como avaliar o Project Myna
Em publicação de 18 de junho de 2026, o Ubuntu descreve o Project Myna, recurso planejado para o Ubuntu 26.10 que pretende inserir ditado por voz no aplicativo ativo, com processamento local.
- Agentes de IAPublicação
Divergência no prompt do shell elevou a latência no DSH
Post publicado em 17 de agosto de 2026 relata que prompts diferentes entre duas ferramentas de shell no DSH acionavam um timeout de 3,5 segundos; uma alteração reduziu o tempo de um comando de 3.600 ms para 158 ms.
- CUDA e programação de GPUArtigo
Do nvcc aos warps: como um kernel CUDA é executado
Publicado em 8 de julho de 2026, o artigo acompanha um kernel de soma de vetores da compilação com nvcc até sua execução por warps na GPU.
- Treino e fine-tuningPublicação
Do REINFORCE ao GRPO: métodos de policy gradient para LLMs
Artigo publicado em 24 de setembro de 2026 apresenta uma progressão de métodos de policy gradient usados no treinamento de LLMs, de vanilla policy gradient e REINFORCE a PPO, GRPO e variantes.
- Agentes de IAPesquisa
Dockerless propõe verificar patches sem execução
Publicado em 30 de junho de 2026, o paper descreve um verificador que avalia patches de agentes de programação sem executá-los. A proposta mira a seleção de trajetórias para SFT e a geração de recompensas para RL, como alternativa à configuração de ambientes por repositório.
- Aprendizado por reforçoPesquisa
DreamSmooth suaviza recompensas esparsas em RL
Apresentado em um paper da ICLR publicado em 28 de junho de 2026, o DreamSmooth aplica suavização temporal às recompensas em model-based RL e foi avaliado em RoboDesk e Shadow Hand.
- Inferência de LLMsPesquisa
Dual-Cache: compartilhamento de contexto entre LLMs
Paper publicado em 26 de setembro de 2026 apresenta um protocolo latente para transferir informações entre modelos heterogêneos, convertendo o KV cache e adicionando mistura conjunta entre camadas.
- Atenção e arquitetura de modelosPublicação
Dust explora treinamento de transformers sem gradientes
Publicado em 5 de outubro de 2026, o paper apresenta o Dust, método zeroth-order que usa perturbações de ativações e relata experimentos de escala e comparações com backpropagation.
- Aprendizado por reforçoPesquisa
EfficientRollout acelera rollouts de RL para LLMs
Paper de 5 de julho de 2026 descreve speculative decoding autoespeculativo com adaptação ao sistema e relata até 19,6% mais rapidez na geração de rollouts.
- RAG e recuperação de contextoPesquisa
Embeddings de relevância para recuperar candidatos
Paper da Yandex, publicado em 7 de julho de 2026, descreve embeddings de consultas e itens para recuperar candidatos com eficiência quando calcular relevância é caro.
- RAG e recuperação de contextoModelo
Embeddings multimodais ampliam a busca em conteúdo visual
Em post publicado em 25 de agosto de 2026, a Tencent descreve um modelo que representa texto, imagens, vídeos e documentos visuais em um espaço compartilhado e afirma resultados de ponta em dois benchmarks.
- Treino e fine-tuningPesquisa
EnvACE ensaia o mundo para treinar agentes
Publicado em 9 de agosto de 2026, o artigo descreve um método de reinforcement learning que substitui interações com ambientes externos por ensaios internos durante o treinamento de agentes.
- Treino e fine-tuningPesquisa
Escala da taxa de aprendizado em LLMs pode ser não linear
Artigo publicado em 30 de junho de 2026 avalia taxas de aprendizado em modelos GPT-2 de 22 milhões a 707 milhões de parâmetros, treinados com 5 bilhões a 100 bilhões de tokens.
- HardwarePublicação
ESP32 bloqueia 537 mil domínios com cerca de 50 KB de RAM
Um post publicado em 20 de julho de 2026 descreve um firmware para ESP32 que mantém a lista de bloqueio na flash e leva cerca de 10 milissegundos para bloquear requisições.
- Treino e fine-tuningPublicação
Espectros de pesos podem sinalizar memorização em LLMs
Uma análise preliminar, publicada em 24 de setembro de 2026, encontrou uma relação entre o expoente α da matriz K de atenção e a memorização de rótulos aleatórios durante o treinamento de LLMs.
- Atenção e arquitetura de modelosProjeto
Estado recorrente pode ampliar a memória de Transformers
A descrição do Recurrent Looped Transformer, datada de 13 de setembro de 2026, apresenta um decoder recorrente que preserva estado entre tokens para ampliar o caminho temporal de informação.
- SegurançaPesquisa
Estudo aponta código sobreposto em sistemas de filtragem de rede
Artigo do USENIX Security relata sobreposição entre código vazado da Geedge Networks e o Grande Firewall da China, incluindo injeção de DNS e de pacotes RST.
- Agentes de IAPesquisa
EvoRec propõe agentes para otimizar recomendações
Publicado em 30 de junho de 2026, o paper apresenta um framework multiagente que busca reduzir a otimização manual de sistemas de recomendação, retendo metodologias entre iterações e explorando ideias além de um espaço predefinido.
- SegurançaPesquisa
ExploitGym avalia agentes de IA em exploração de vulnerabilidades
A pesquisa ExploitGym propõe avaliar se agentes de IA conseguem transformar vulnerabilidades em impactos como acesso não autorizado a arquivos ou execução de código.
- Inferência de LLMsProjeto
Falhas silenciosas no serving de LLMs: como diagnosticar
Publicado em 28 de julho de 2026, o repositório do GitHub cataloga falhas de serving de LLMs, seus sintomas, mecanismos, verificações e correções.
- Atenção e arquitetura de modelosPublicação
Fatoração de attention e fluxo de gradientes: implicações para modelos
Publicada em 30 de setembro de 2026, a publicação discute como fatorar a matriz de attention como S = WWᵀ pode alterar o fluxo de gradientes e remover um gargalo de expoente de informação na otimização.
- CUDA e programação de GPUPesquisa
FIBER propõe separar registradores da execução na GPU
Publicado em 21 de agosto de 2026, o artigo apresenta uma arquitetura de GPU que desacopla a propriedade de registradores das instâncias de execução paralela.
- Atenção e arquitetura de modelosPesquisa
Filtragem de contexto na atenção para hardware limitado
Artigo da SAS, publicado em 16 de setembro de 2026, descreve um seletor treinado de ponta a ponta dentro do Softmax para filtrar contexto em mecanismos de atenção voltados a hardware com recursos computacionais limitados.
- Voz: TTS e ASRProjeto
FireRedAudio reúne cinco tarefas de fala em um modelo
Publicado em 27 de agosto de 2026, o FireRedAudio combina reconhecimento e compreensão de áudio, geração de fala e edição em um modelo com representações distintas para compreensão e geração.
- Atenção e arquitetura de modelosPesquisa
FlashAttention-3: otimização de attention em GPUs Hopper
O artigo, publicado em 24 de setembro de 2026, apresenta técnicas de execução assíncrona e baixa precisão para acelerar attention em GPUs Hopper, com foco em tráfego de memória e uso do hardware.
- Atenção e arquitetura de modelosPesquisa
FlowTracer rastreia tokens influentes no raciocínio de LLMs
Publicado em 4 de julho de 2026, o artigo apresenta um método que usa atenção para rastrear a propagação de informação e direcionar a atribuição de crédito no treinamento por reforço.
- Atenção e arquitetura de modelosPublicação
Fluxos recorrentes refinam o raciocínio em tarefas discretas
Um post publicado em 3 de setembro de 2026 descreve modelos que combinam fluxos contínuos e refinamento recorrente para resolver problemas estruturados, como Sudoku.
- CUDA e programação de GPUPublicação
Fork habilita P2P via PCIe em GeForce
Post de 27 de agosto de 2026 relata uma alteração em drivers gráficos para habilitar transferências peer-to-peer via PCIe em GeForce durante a otimização de serving em GPU.
- Aprendizado por reforçoProjeto
FrontierSmith reúne 200 problemas abertos de RL
Em 28 de setembro de 2026, a FrontierSmith publicou um repositório com 200 problemas para estudar aprendizado por reforço em tarefas abertas e desafiadoras.
- C e C++Vídeo
Ftrace para observar o comportamento do kernel Linux
Uma sessão de 2018 de Steven Rostedt apresenta o tracing com ftrace e aborda memória virtual, tabelas de páginas e a interação entre programas e o kernel.
- Atenção e arquitetura de modelosPublicação
FuncAttn leva attention funcional a dados contínuos
Post de 25 de junho de 2026 descreve um método que aplica operadores lineares estruturados à attention entre espaços de funções, com resultados em solução de PDEs, segmentação 3D e regressão.
- Atenção e arquitetura de modelosPublicação
Functional Attention propõe atenção de custo linear
Publicado em 6 de julho de 2026, o paper descreve uma forma de representar query e key/value com bases aprendidas e uma matriz compacta, relatando custo linear no número de pontos.
- C e C++Publicação
FUTEX_PRIVATE_FLAG e o custo dos locks entre threads
Post de 28 de junho de 2026 explica como FUTEX_PRIVATE_FLAG pode reduzir a latência de locks em threads que compartilham memória no mesmo processo.
- Atenção e arquitetura de modelosPesquisa
Gated Linear Attention: atenção linear com gates
Publicado em 20 de setembro de 2026, o artigo apresenta uma formulação de transformer com atenção linear e gates dependentes dos dados, expressável também como uma RNN com estados ocultos matriciais.
- Treino e fine-tuningPublicação
GEPA adapta modelo com prompts e exemplos rotulados
Uma demonstração publicada em 19 de setembro de 2026 descreve o uso de prompts e exemplos rotulados para adaptar um modelo a critérios específicos de decisão.
- Agentes de IAPesquisa
Git como memória compartilhada para agentes de pesquisa
Um post publicado em 17 de setembro de 2026 descreve agentes que registram contribuições verificáveis em um histórico Git pesquisável, para compartilhar resultados e reduzir experimentos repetidos.
 arxiv.org
Vamos avaliar seu projeto

Respondo com escopo e proposta.